
Affiliazione
Inizia Gratis Ora
Desenvolvimento de Personagens Consistentes em Vídeo: O Guia Completo de Fusão Multi-Imagem
Aug 3, 2026
O Desafio da Consistência de Personagens em Vídeos Gerados por IA
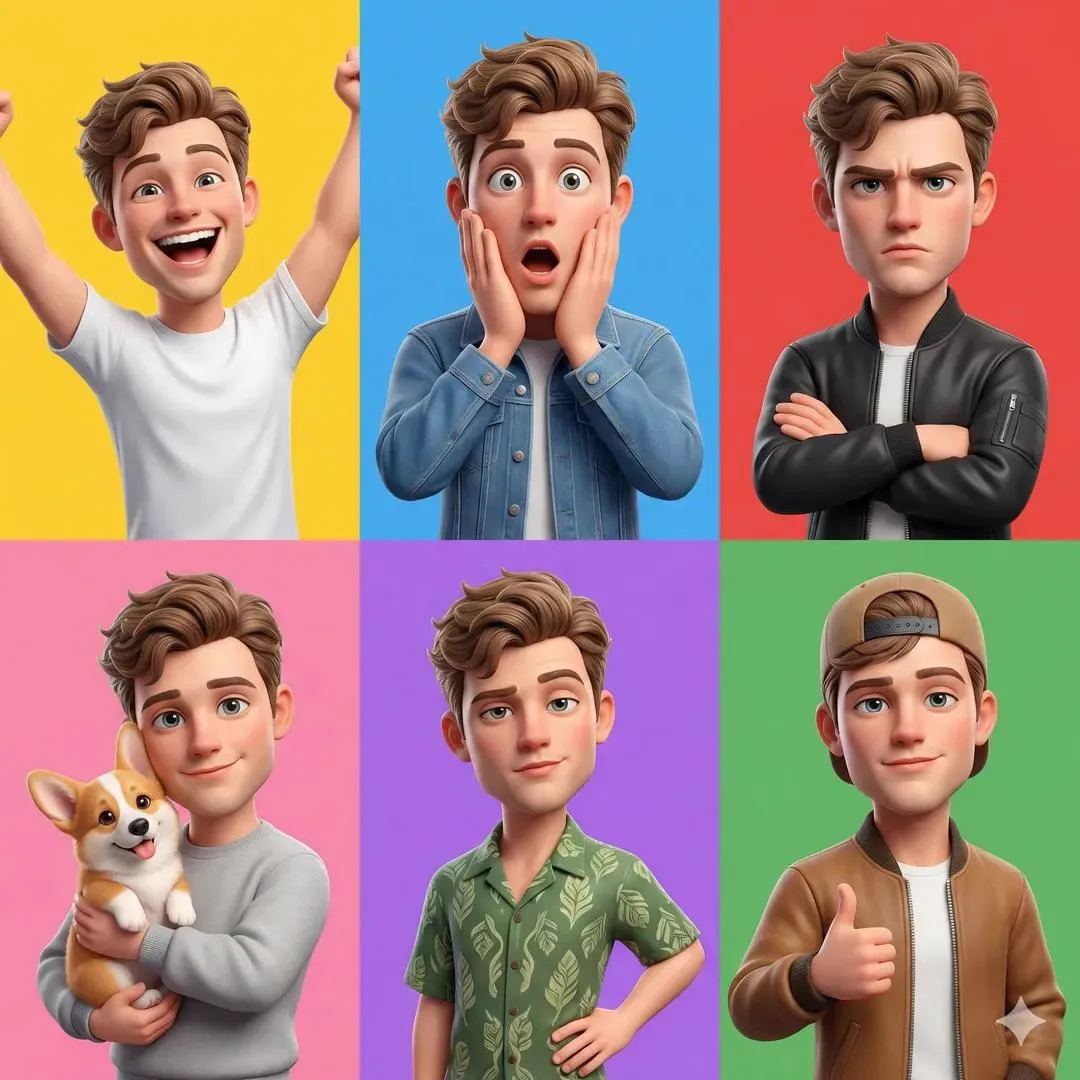
A criação de vídeos com inteligência artificial atingiu um nível impressionante em 2025. No entanto, um problema persiste: manter o mesmo personagem com aparência idêntica em diferentes cenas. A inconsistência visual é o principal fator de rejeição de conteúdo gerado por IA pelo público. A fusão multi-imagem surge como a solução definitiva para esse desafio.
Plataformas como Domer AI Video Generator estão incorporando técnicas avançadas de referência visual para garantir que personagens mantenham traços faciais, figurino e proporções consistentes, mesmo sob diferentes ângulos de câmera e condições de iluminação.
Por Que a Consistência de Personagens é Fundamental
O mercado global de vídeo gerado por IA deve ultrapassar US$ 15 bilhões em 2025. A demanda por produções de qualidade cinematográfica exige coerência visual absoluta. Quando um protagonista muda de aparência entre cenas, a imersão narrativa é destruída.
O Problema da Deriva de Identidade
A deriva de identidade ocorre quando modelos de difusão falham em manter características semânticas de um personagem ao processar prompts diferentes. Um personagem que aparece em uma floresta e depois em uma cidade pode sofrer alterações sutis mas perceptíveis no rosto, cabelo ou tom de pele.
Para resolver isso, ferramentas como Domer AI Image Generator permitem criar referências visuais consistentes que servem como base para geração de vídeo.
Como Funciona a Fusão Multi-Imagem
A fusão multi-imagem combina informações de múltiplas fontes visuais — uma foto de rosto em alta resolução, uma imagem de corpo inteiro e um keyframe da cena anterior — para criar um "DNA visual" do personagem. Este DNA é injetado no processo de geração de cada frame, garantindo consistência.
Ponderação Inteligente de Referências
O segredo está na ponderação correta dos vetores latentes. Uma imagem de rosto recebe maior peso para coerência facial, enquanto uma imagem de traje é priorizada para consistência de figurino. Modelos avançados como Seedance 2.0 se destacam por sua capacidade de manter coerência temporal em sequências longas.
O Papel do Treinamento de Modelos Personalizados
Além da fusão multi-imagem, o treinamento de modelos personalizados usando técnicas como LoRA permite capturar características específicas de um personagem. Combinar um modelo personalizado com fusão multi-imagem cria o nível máximo de fidelidade visual.
Escolhendo os Modelos Certos para Consistência
Cada modelo de IA tem pontos fortes diferentes para consistência de personagens. O Kling 3.0 oferece excelente persistência de objetos em sequências. Modelos com arquiteturas de atenção temporal aprimoradas permitem que a IA "lembre" do frame anterior com mais eficiência.
Otimização de Custo-Benefício
Criadores podem combinar modelos mais acessíveis para cenas de transição com modelos premium para cenas-chave, otimizando o orçamento sem sacrificar a consistência. O importante é manter o personagem como prioridade máxima em todas as etapas da produção.
Fluxo de Trabalho para Personagens Consistentes
Etapa 1: Definição do Personagem
Crie um conjunto de imagens de referência do seu personagem em diferentes ângulos e expressões. Estas serão a base para todo o projeto.
Etapa 2: Configuração da Fusão
Carregue as referências na plataforma de text-to-video e ajuste os controles de fidelidade para definir o peso de cada referência.
Etapa 3: Geração e Validação
Gere os frames e verifique a consistência. Se houver desvio, ajuste os parâmetros de fusão e regenere.
Etapa 4: Escala
Com o personagem validado, produza em escala mantendo a mesma configuração de referência.
Conclusão
A consistência de personagens não é mais um luxo — é uma necessidade para qualquer criador sério de conteúdo com IA. A fusão multi-imagem representa o salto tecnológico que transforma a produção de vídeo com IA de experimentos isolados para narrativas profissionais contínuas. Dominar essa técnica é essencial para se destacar em 2025.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.