
Criar
Fotorealistische KI-Bilder zu Videos Umwandeln: Der Ultimative Leitfaden
Aug 4, 2026
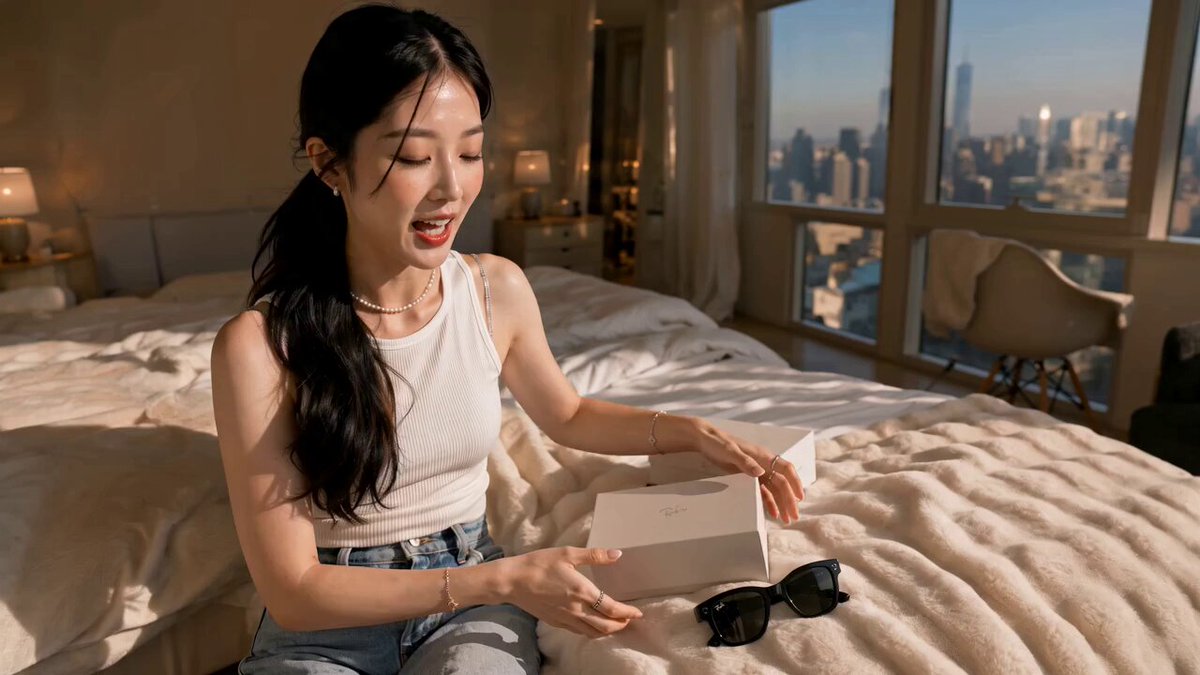
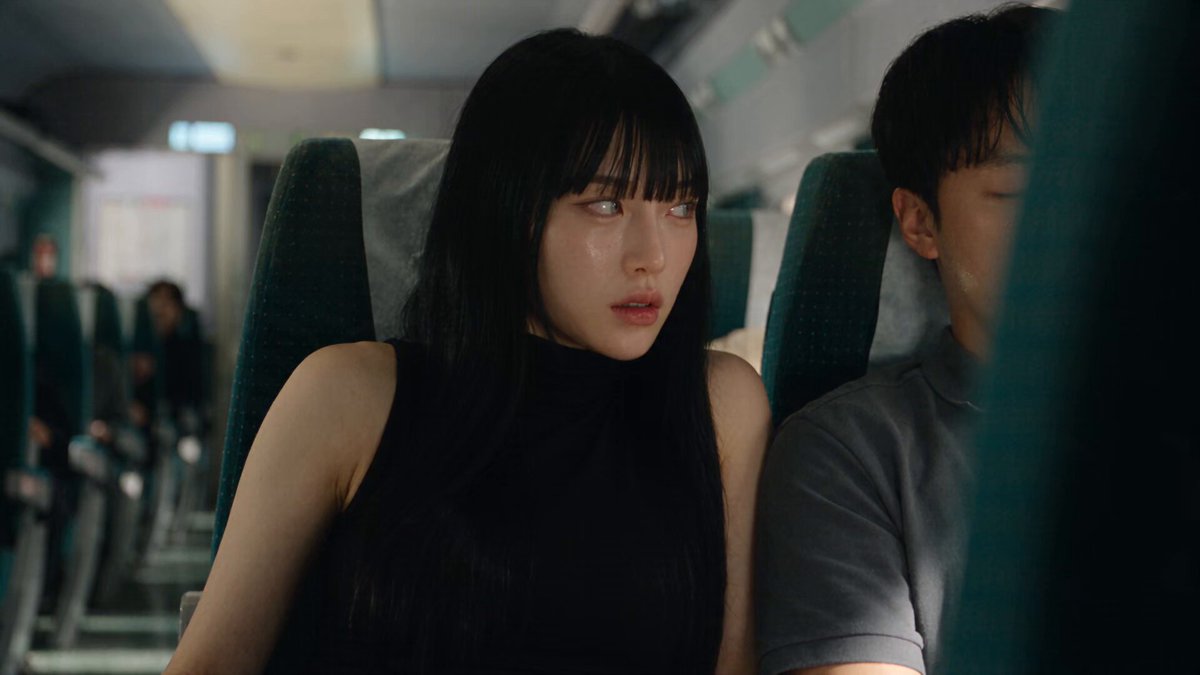
Vom Standbild zum Bewegtbild
Fotorealistische KI-Bilder sind beeindruckend — aber sie zum Leben zu erwecken, sie in Bewegung zu versetzen, das ist die nächste Evolutionsstufe. Die Umwandlung von KI-generierten Bildern in Videos eröffnet völlig neue kreative Möglichkeiten.
Ob für Marketing, Social Media oder künstlerische Projekte: Wer diese Technik beherrscht, kann Content produzieren, der aus der Masse heraussticht.
Die Technologie dahinter
Die Bild-zu-Video-Konvertierung nutzt KI-Modelle, die aus einem einzelnen Standbild eine Videosequenz generieren. Das Modell analysiert das Bild, versteht die räumliche Tiefe, identifiziert Objekte und deren Beziehungen zueinander und berechnet dann, wie sich die Szene in Bewegung verändern würde.
Moderne Modelle können:
- Natürliche Bewegungen (fließendes Wasser, wehende Haare, fahrende Autos) simulieren
- Kamerafahrten (Zoom, Schwenk, Drohnenflug) hinzufügen
- Beleuchtungsänderungen über die Zeit darstellen
- Parallax-Effekte durch Tiefeninformationen erzeugen
Schritt-für-Schritt-Anleitung
1. Erstellen Sie das perfekte Ausgangsbild
Die Qualität des Endvideos hängt direkt vom Ausgangsbild ab. Nutzen Sie den Domer AI Image Generator für hochauflösende, detailreiche Bilder. Achten Sie auf:
- Hohe Auflösung (mindestens 1024x1024)
- Klare Komposition mit Tiefe
- Interessante Elemente, die Bewegung rechtfertigen
2. Wählen Sie den richtigen Video-Generator
Der Domer AI Video Generator unterstützt Bild-zu-Video mit verschiedenen Modellen. Für fotorealistische Ergebnisse empfehlen wir Seedance 2.0.
3. Definieren Sie die Bewegung
Beschreiben Sie präzise, was sich wie bewegen soll:
- "Langsame Kamerafahrt von links nach rechts"
- "Sanfte Wellenbewegung auf dem Wasser"
- "Wolken ziehen langsam über den Himmel"
4. Optimieren Sie iterativ
Das erste Ergebnis ist selten perfekt. Passen Sie die Bewegungsparameter an und generieren Sie neu, bis das Ergebnis überzeugt.
Typische Anwendungsfälle
- Immobilienmarketing: Architektur-Renderings mit atmosphärischer Bewegung
- Produktpräsentationen: 360-Grad-Ansichten mit sanfter Rotation
- Kunstinstallationen: Digitale Kunstwerke mit subtiler Bewegung
- Social Media: Eye-Catching Content mit Cinemagraph-Charakter
Tipps für beste Ergebnisse
- Weniger ist mehr: Subtile Bewegungen wirken natürlicher als hektische Aktionen.
- Vordergrund und Hintergrund: Bilder mit klarer Tiefenstaffelung erzeugen bessere Parallax-Effekte.
- Vermeiden Sie statische Elemente im Fokus: Das Hauptmotiv sollte Potenzial für Bewegung haben.
- Experimentieren Sie mit der Dauer: 3-5 Sekunden reichen oft für einen starken Eindruck.
Die Umwandlung von KI-Bildern in Videos ist mehr als eine technische Spielerei — sie ist ein kreatives Werkzeug, das die Grenzen zwischen Fotografie und Film verschwimmen lässt. Wer heute anfängt zu experimentieren, hat morgen einen Wettbewerbsvorteil.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.