
多图融合技术:如何用AI保持角色一致性
Aug 4, 2026
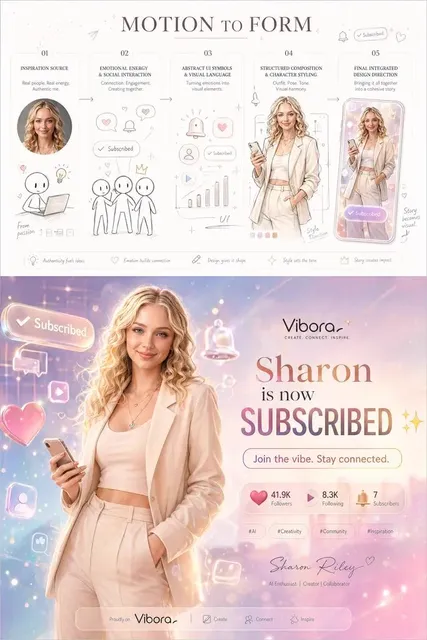
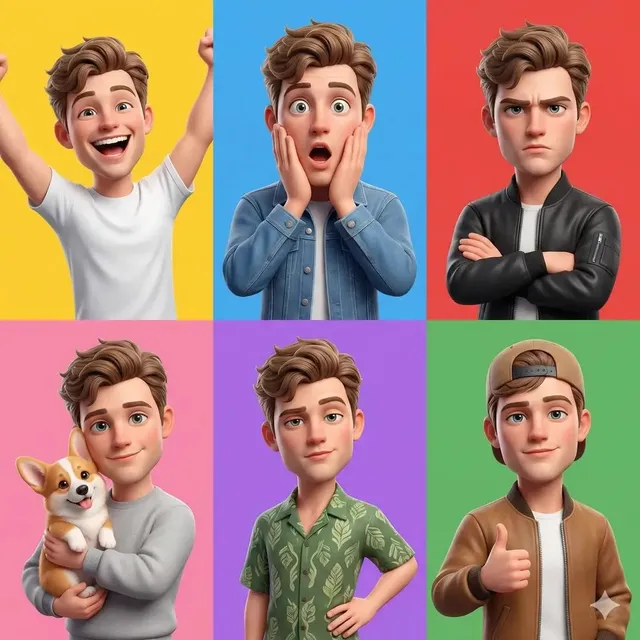
AI视频生成的最大痛点:角色一致性
如果你用过AI视频生成工具,一定遇到过这个问题:第一帧的角色和第二帧的角色长得完全不一样。头发颜色变了,脸型改了,甚至连衣服都换了。这种不一致性是AI视频生成领域最困扰创作者的问题之一。
想象一下你在制作一个动画短片。主角在场景A中是一个金发女孩,到了场景B却变成了黑发——这不仅破坏了观众的沉浸感,也让整个作品显得不够专业。
好在,多图融合技术正在改变这一现状。
什么是多图融合技术?
多图融合(Multi-Image Fusion)是一种允许AI模型同时参考多张图像来生成新内容的技术。简单来说,你上传一张或多张角色参考图,AI就会「记住」这个角色的外观特征,并在后续生成的所有画面中保持一致。
这种方式的工作原理是:AI将参考图像的特征编码为高维向量,然后在生成新帧时,将这些向量作为约束条件,确保生成的角色与参考图匹配。
为什么多图融合如此重要?
对于内容创作者来说,多图融合解决了一个根本问题:品牌一致性。不管你是:
- 制作系列动画短片
- 创建虚拟IP形象
- 为品牌制作营销视频
- 制作个性化的社交媒体内容
角色的一致性都直接决定了作品的专业度和观众的信任感。
在Domer平台上,你可以利用先进的AI视频生成工具,轻松实现角色在各种场景下的一致性表现。
如何使用多图融合:分步指南
第一步:创建你的角色参考图
找一张能清楚展示角色面部特征、发型、服装的图片。如果想要更好的效果,可以上传多张不同角度的参考图。使用Domer AI图像生成器可以快速创建高质量的角色设计图。
第二步:选择支持多图融合的模型
并非所有AI模型都支持多图融合。推荐使用支持此功能的高级模型,如Seedance 2.0,它在角色一致性和运动流畅度方面表现出色。
第三步:编写详细的场景描述
在提示词中不仅要描述动作和场景,还要明确提到参考图中的角色特征,帮助AI更好地维护一致性。
第四步:迭代优化
第一版结果可能不完美。根据生成效果调整提示词,逐步接近理想状态。
多图融合的实际应用案例
- 虚拟主播:创建一个虚拟形象,在所有视频中保持外观一致
- 产品演示:同一个产品在不同场景下展示,保持外观准确
- 教育内容:固定的卡通角色贯穿整个教学系列
- 社交媒体个人品牌:用统一的虚拟形象建立辨识度
常见问题与解决方案
- 角色变形:确保参考图清晰且光线充足
- 角度限制:上传正面、侧面、45度等多角度参考图
- 风格漂移:在提示词中明确指定艺术风格
多图融合技术让AI视频创作从「随机生成」迈向了「精确控制」。对于追求品质的创作者来说,掌握这项技术是必备技能。开始尝试吧,你会惊讶于它带来的创作自由。

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.