
ปัญหาใหญ่ของการสร้างวิดีโอด้วย AI
คุณเคยลองสร้างวิดีโอ AI แบบหลายซีนไหม? ปัญหาคลาสสิกคือ: ซีนแรกตัวละครใส่เสื้อแดง ผมสั้น ซีนสองกลายเป็นเสื้อน้ำเงิน ผมยาวซะงั้น AI จำหน้าตาตัวละครไม่ได้
นี่คือปัญหา "Character Consistency" หรือความสม่ำเสมอของตัวละคร และมันคืออุปสรรคอันดับหนึ่งของการเล่าเรื่องด้วย AI
Multi-Image Fusion คืออะไร
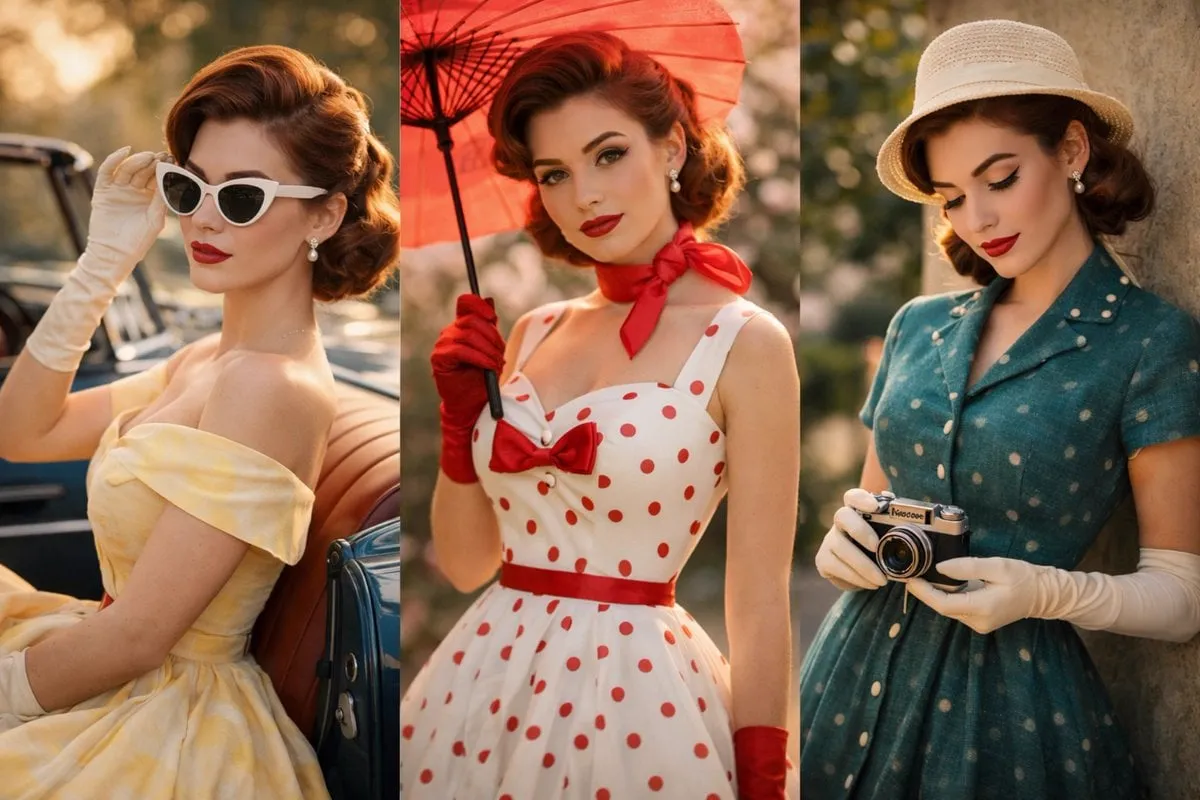
Multi-Image Fusion (การหลอมรวมหลายภาพ) คือเทคนิคที่ใช้ภาพอ้างอิงหลายภาพเพื่อบอก AI ว่า "ตัวละครของฉันหน้าตาแบบนี้นะ" แทนที่จะให้ AI จินตนาการจากข้อความอย่างเดียว
วิธีการทำงาน:
- คุณสร้างภาพตัวละครต้นแบบ 2-3 ภาพ (มุมตรง มุมข้าง เสื้อผ้าหลายแบบ)
- ใส่ภาพทั้งหมดเป็นข้อมูลอ้างอิง (Reference Images)
- AI ใช้ข้อมูลจากทุกภาพมาสร้างตัวละครในซีนใหม่ ทำให้ได้ผลลัพธ์ที่สม่ำเสมอมากขึ้น
วิธีการทำ Multi-Image Fusion แบบง่าย
ขั้นตอนที่ 1: สร้างภาพตัวละครต้นแบบ
ใช้ AI Image Generator สร้างตัวละครในท่าทางและมุมต่างๆ อย่างน้อย 3 ภาพ:
- ภาพใบหน้าตรง (Front View)
- ภาพด้านข้าง (Profile)
- ภาพเต็มตัว (Full Body)
ขั้นตอนที่ 2: กำหนดสไตล์ให้สม่ำเสมอ
ใช้ prompt เดิมแต่เปลี่ยนแค่มุมกล้อง เช่น:
- "ตัวละครชาย อายุ 25 ปี ผมสีดำ เสื้อแจ็คเก็ตหนัง มุมตรง"
- "ตัวละครชาย อายุ 25 ปี ผมสีดำ เสื้อแจ็คเก็ตหนัง มุมข้าง"
ขั้นตอนที่ 3: ใช้เป็น Reference ในการสร้างวิดีโอ
เมื่อคุณมีภาพอ้างอิงที่สม่ำเสมอแล้ว ให้ใช้ AI Video Generator หรือ Image-to-Video โดยอัปโหลดภาพอ้างอิงเข้าไปด้วย — AI จะพยายามคงลักษณะตัวละครตามภาพ
เคล็ดลับให้ผลลัพธ์ดีขึ้น
- ภาพอ้างอิงต้องคุณภาพสูง: ถ้าภาพต้นฉบับเบลอหรือแสงไม่ดี ผลลัพธ์จะแย่ลง
- รักษาสไตล์ศิลปะเดียวกัน: ถ้าตัวละครเป็นสไตล์อนิเมะ ทุกภาพอ้างอิงต้องเป็นอนิเมะ
- อย่าคาดหวัง 100%: เทคนิคนี้ลดความผันผวนได้เยอะ แต่ยังไม่ใช่ Perfect Consistency ต้องมี Manual Edit บ้าง
เมื่อไหร่ควรใช้ และเมื่อไหร่ไม่ควร
ควรใช้เมื่อ:
- ทำซีรีส์หรือเรื่องสั้นที่มีตัวละครเดิมหลายตอน
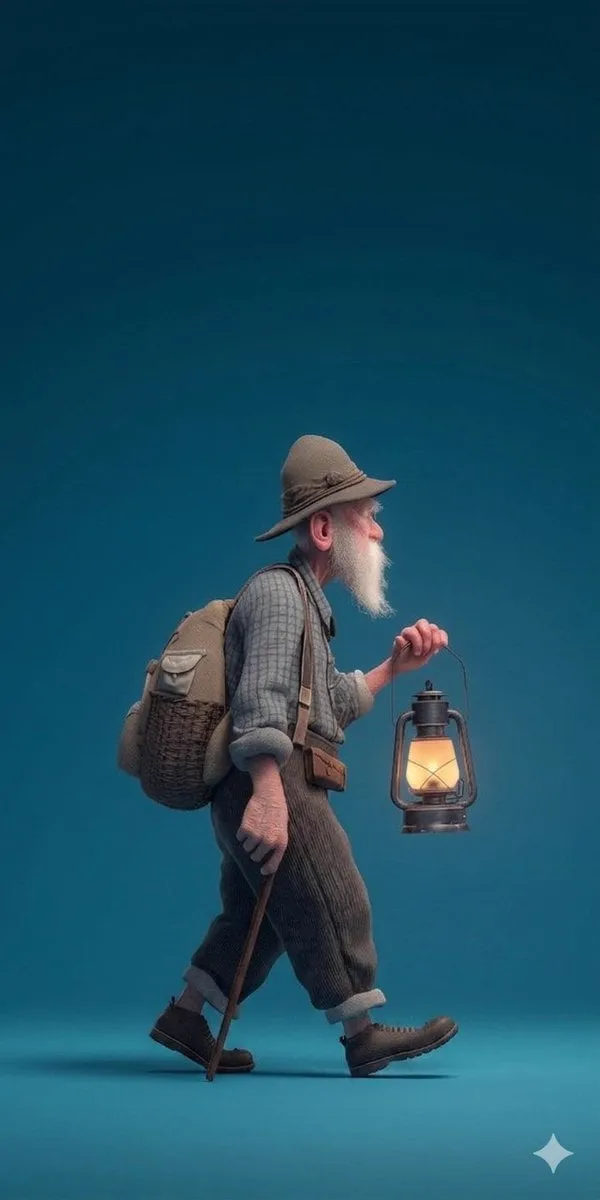
- ทำคอนเทนต์แบรนด์ที่มีมาสคอต
- ทำการ์ตูนหรือแอนิเมชัน
ไม่จำเป็นเมื่อ:
- วิดีโอแบบ One-shot คลิปเดียวจบ
- เนื้อหาแบบ Abstract ไม่มีตัวละครตายตัว
- กำลังทดลองไอเดีย ยังไม่ซีเรียสเรื่องความสม่ำเสมอ
สรุป
Multi-Image Fusion เป็นเทคนิคที่ยกระดับคุณภาพการเล่าเรื่องด้วย AI อย่างมีนัยสำคัญ ฝึกใช้ให้คล่องแล้วคุณจะสร้างคอนเทนต์ที่ดูเป็นมืออาชีพขึ้นมาก
