
Multi-Image Fusion und KI-Bildbearbeitung: Techniken für konsistente visuelle Inhalte
Aug 4, 2026
Was ist Multi-Image Fusion?
Multi-Image Fusion ist eine der spannendsten Entwicklungen in der KI-gestützten Bild- und Videogenerierung. Die Technik erlaubt es, mehrere Referenzbilder zu kombinieren, um konsistente visuelle Ergebnisse über verschiedene Generationen hinweg zu erzielen.
Stellen Sie sich vor, Sie entwerfen eine animierte Figur. Sie laden drei Bilder hoch — von vorne, von der Seite und in einer Aktionspose. Die KI extrahiert die Kernmerkmale Ihrer Figur und stellt sicher, dass jedes neu generierte Bild oder Video diese Merkmale beibehält. Egal ob die Figur läuft, spricht oder in einer anderen Umgebung erscheint — sie bleibt erkennbar.
Warum Konsistenz der Heilige Gral ist
Das größte Problem bei KI-generierten Videos war lange die Inkonsistenz. Eine Figur sah in Szene 1 anders aus als in Szene 2. Haarfarbe, Kleidung, Gesichtsmerkmale — alles konnte sich von Frame zu Frame ändern. Für ernsthafte Videoproduktion war das ein Showstopper.
Multi-Image Fusion löst dieses Problem. Indem Sie der KI mehrere Referenzpunkte geben, versteht sie, welche Merkmale konstant bleiben müssen und welche variieren dürfen.
Die Technischen Grundlagen
Wie es funktioniert
- Feature-Extraktion: Die KI analysiert Ihre Referenzbilder und identifiziert Schlüsselmerkmale — geometrische Strukturen, Texturen, Farbpaletten
- Embedding-Erstellung: Diese Merkmale werden in einen mathematischen Vektorraum übersetzt
- Konsistente Generierung: Bei jeder neuen Bild- oder Videogenerierung werden diese Embeddings als Leitfaden verwendet
Anwendungsbereiche
Charakterdesign: Erstellen Sie eine Figur einmal und verwenden Sie sie in unendlich vielen Szenarien.
Produktvisualisierung: Zeigen Sie ein Produkt in verschiedenen Umgebungen, Winkeln und Kontexten — mit perfekter Konsistenz.
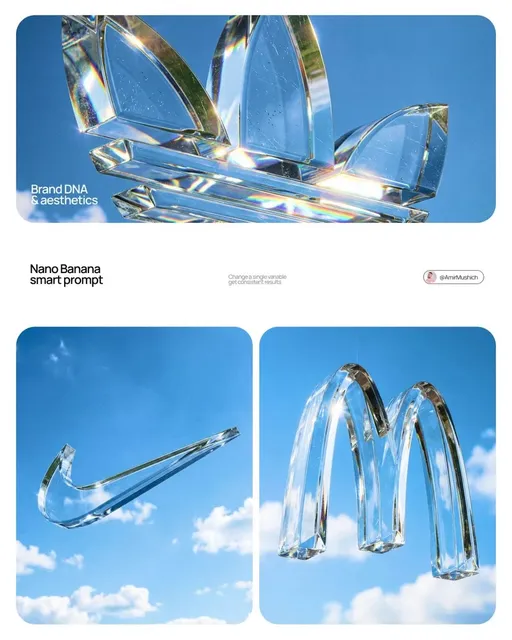
Markenidentität: Entwickeln Sie einen einzigartigen visuellen Stil und wenden Sie ihn konsistent auf alle Ihre Inhalte an.
Mit Domer und dem AI image generator können Sie diese Techniken direkt anwenden.
Praktischer Workflow
Schritt 1: Referenzmaterial vorbereiten
Sammeln Sie 3-5 qualitativ hochwertige Referenzbilder. Diese sollten:
- Das gleiche Subjekt aus verschiedenen Winkeln zeigen
- Konsistente Beleuchtung haben
- Die gewünschten Schlüsselmerkmale deutlich darstellen
Schritt 2: Hochladen und Konfigurieren
Laden Sie Ihre Referenzbilder in die Plattform hoch. Die KI analysiert automatisch die gemeinsamen Merkmale.
Schritt 3: Prompt Engineering
Beschreiben Sie, was Sie generieren möchten, und geben Sie an, dass die Referenzmerkmale beibehalten werden sollen. Zum Beispiel: "Die gleiche Figur wie in den Referenzbildern, jetzt in einem Café sitzend, warmes Abendlicht."
Schritt 4: Iteration und Verfeinerung
Überprüfen Sie die Ergebnisse. Wenn bestimmte Merkmale nicht perfekt übernommen wurden, passen Sie Ihren Prompt an oder fügen Sie spezifischere Referenzbilder hinzu.
Kombination mit anderen Techniken
Style Transfer + Multi-Image Fusion
Wenden Sie einen künstlerischen Stil auf Ihre konsistenten Charaktere an. Das Ergebnis: eine Figur, die in jeder Szene gleich aussieht, aber im Stil eines Ölgemäldes, Comics oder einer bestimmten Kunstrichtung.
Modelle wie GPT Image 2 sind hervorragend für diese Art von hochwertiger Stilkonsistenz.
Text-to-Video Integration
Nachdem Sie konsistente Charaktere mit Multi-Image Fusion erstellt haben, können Sie diese mit Domer's AI video generator animieren. Die Schlüsselmerkmale bleiben über die gesamte Videosequenz erhalten.
Profi-Tipps
- Qualität vor Quantität: Wenige hervorragende Referenzbilder sind besser als viele mittelmäßige
- Variation zeigen: Ihre Referenzbilder sollten Variation in Pose und Umgebung, aber Konsistenz in den Kernmerkmalen zeigen
- Prompt-Präzision: Je präziser Sie beschreiben, was gleich bleiben soll und was sich ändern darf, desto besser
- Batch-Testing: Testen Sie verschiedene Prompt-Variationen gleichzeitig, um Zeit zu sparen
Grenzen und Lösungen
Grenze: Extreme Perspektivwechsel
Bei dramatischen Perspektivwechseln (z.B. von vorne nach direkt von oben) kann die Konsistenz leiden. Lösung: Fügen Sie Referenzbilder hinzu, die extreme Winkel abdecken.
Grenze: Stilistische Brüche
Wenn Sie zwischen sehr unterschiedlichen KI-Modellen wechseln, kann der Stil variieren. Lösung: Verwenden Sie Style-Transfer als Nachbearbeitung.
Grenze: Komplexe Szenen mit vielen Charakteren
Je mehr Elemente konsistent bleiben müssen, desto schwieriger wird es. Lösung: Generieren Sie komplexe Szenen schrittweise und fügen Sie Elemente nacheinander hinzu.
Zukunftsperspektiven
Die Technologie entwickelt sich rasant:
- Echtzeit-Fusion: Konsistente Generierung ohne Wartezeit
- 3D-Integration: Nahtloser Übergang zwischen 2D-Referenzen und 3D-Modellen
- Audio-visuelle Konsistenz: Charaktere, die nicht nur visuell, sondern auch akustisch konsistent sind
Fazit
Multi-Image Fusion transformiert KI-generierte Inhalte von "interessant aber inkonsistent" zu "produktionsreif". Für Creator, die ernsthafte Projekte umsetzen wollen — sei es eine animierte Serie, konsistente Markeninhalte oder Produktvisualisierungen — ist diese Technik unverzichtbar.
Starten Sie mit Domer, experimentieren Sie mit Seedance 2.0 für videobasierte Fusion, und entdecken Sie, wie konsistente KI-Inhalte Ihre kreative Arbeit auf das nächste Level heben.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.