
Il video generativo ha smesso da tempo di essere una curiosità da laboratorio. Oggi registi indipendenti, motion designer, illustratori e creator social lo usano per storyboard animati, spot brevi, teaser musicali e contenuti verticali. In questo panorama i modelli della famiglia Hailuo si sono ritagliati uno spazio preciso grazie a due qualità riconoscibili: un realismo fisico convincente nei movimenti e una resa della luce che ricorda la fotografia cinematografica. Il rovescio della medaglia è che questi modelli non perdonano i prompt approssimativi. Una frase vaga produce clip generiche, con volti che si deformano e camera che vaga senza intenzione. Una descrizione strutturata, invece, produce materiale montabile al primo o secondo tentativo.
Questa guida raccoglie un metodo di lavoro pratico: come si costruisce un prompt per Hailuo, quali elementi contano davvero, come si mantiene la coerenza tra le inquadrature, come si gestiscono i limiti del modello e come si organizza un workflow completo dal concept alla clip finale.
Che cosa distingue Hailuo dagli altri modelli video
Hailuo è un modello text-to-video e image-to-video pensato per clip brevi ad alta densità visiva. La sua architettura lavora su rappresentazioni latenti temporali: non genera fotogrammi indipendenti e poi li incolla, ma costruisce una traiettoria coerente nel tempo. Da qui derivano tre comportamenti tipici che è utile conoscere prima di scrivere qualsiasi prompt.
Il primo è la sensibilità al movimento fisico. Hailuo gestisce bene peso, inerzia e attrito: una giacca che si muove al vento, un bicchiere che oscilla su un tavolo, un salto che ricade con accelerazione credibile. Se il prompt descrive un'azione fisica con un vincolo chiaro, il modello tende a rispettarlo.
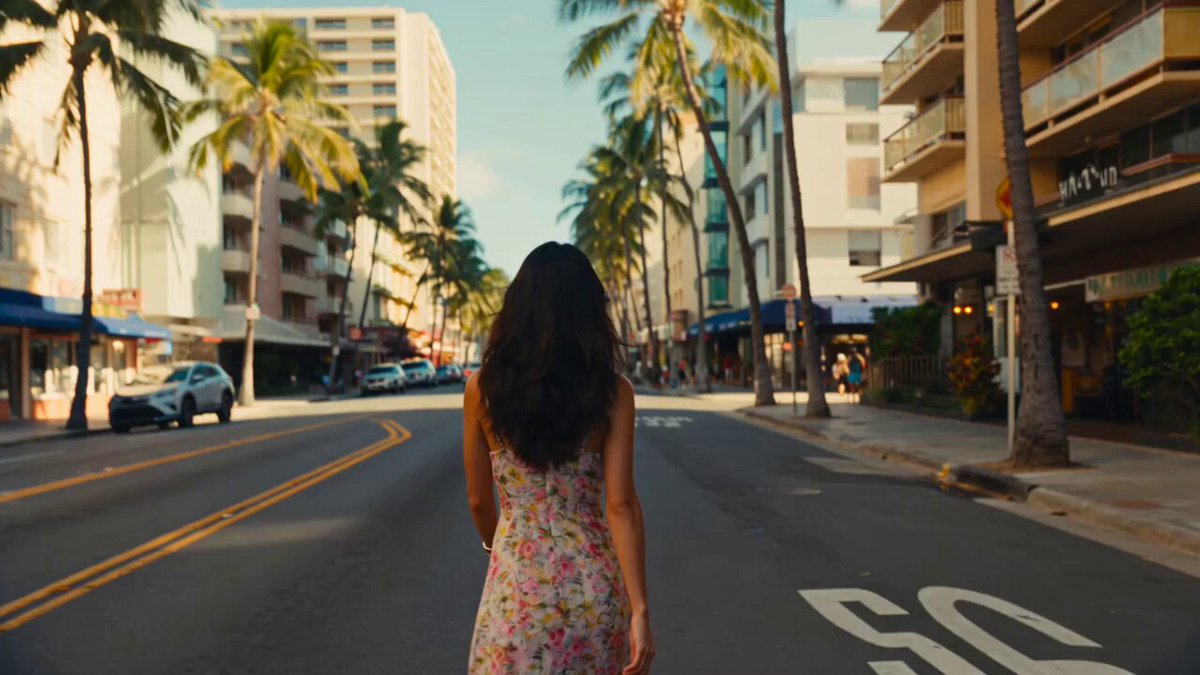
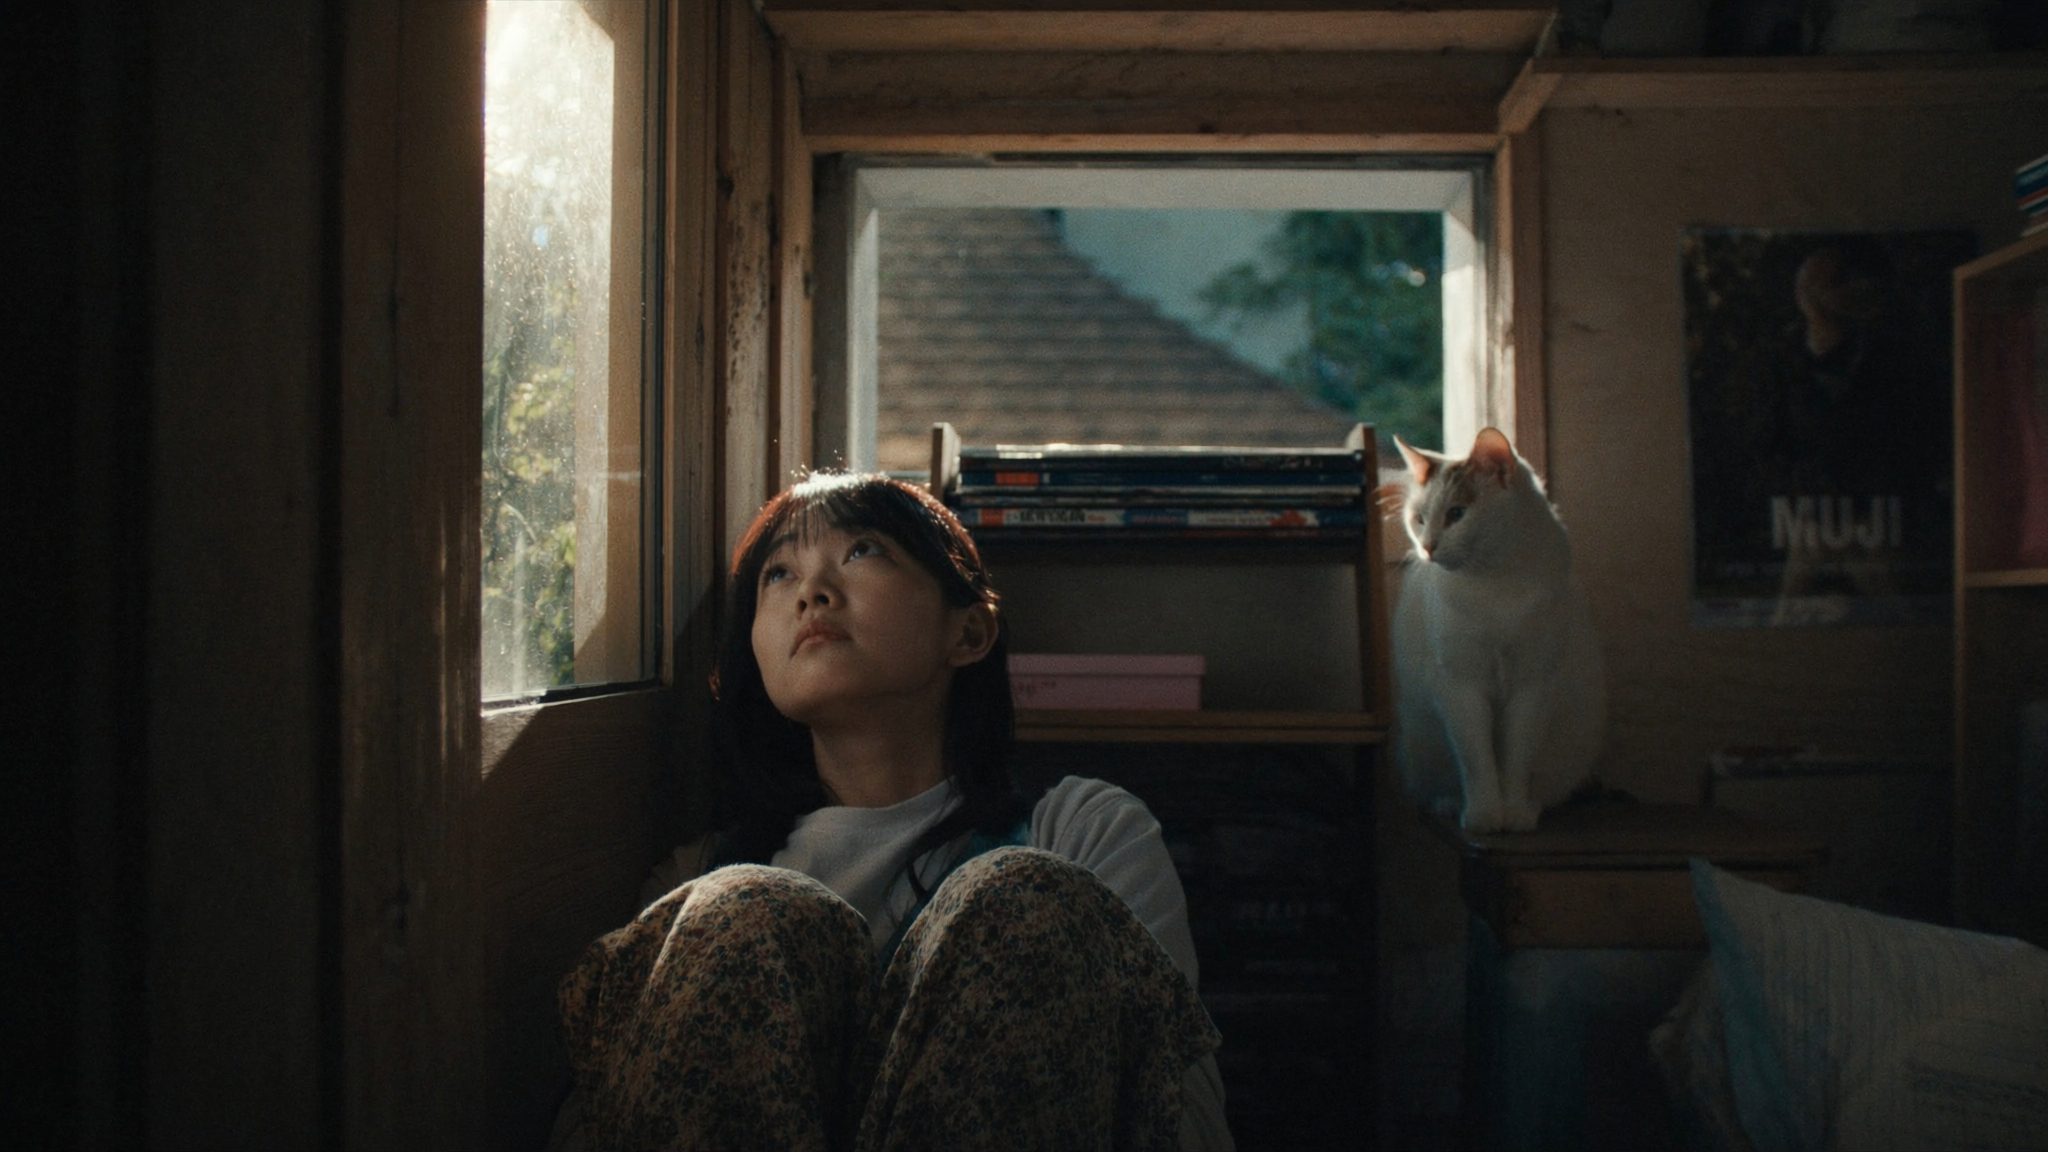
Il secondo è la preferenza per la luce motivata. Il modello rende al meglio quando la fonte luminosa è dichiarata: controluce, luce finestra diffusa, neon laterale, luce dura di mezzogiorno. Indicare la luce non è decorazione, è una delle istruzioni più efficaci per orientare il risultato.
Il terzo è la difficoltà con l'informazione simbolica. Testo leggibile nelle insegne, loghi, grafiche sovrapposte e dialoghi multi-personaggio complessi restano punti deboli. Sapere dove il modello vacilla evita di sprecare tentativi su richieste che non gli appartengono.
L'anatomia di un prompt Hailuo efficace
La struttura in quattro blocchi
Un prompt affidabile per Hailuo si costruisce per blocchi, non per accumulo di aggettivi. L'ordine consigliato è questo:
- Soggetto e contesto — chi o cosa, dove, in quale momento della giornata.
- Azione principale — un solo verbo forte, con eventuale vincolo fisico.
- Movimento di camera — come lo spettatore guarda la scena.
- Atmosfera e resa — luce, palette, texture, formato, stile fotografico.
Un errore ricorrente è mettere lo stile prima del soggetto. Il modello pesa le prime parole in modo più forte, quindi aprire con "cinematic, 4k, hyperrealistic" e solo alla fine dire cosa accade nella scena produce risultati generici ma ben illuminati. Invertire l'ordine cambia radicalmente la resa.
Un esempio commentato
Prompt debole: "Un uomo cammina in una strada di notte, stile cinematografico, bello, 4k".
Prompt strutturato: "Un uomo di mezza età con un cappotto di lana consumato cammina lentamente sotto la pioggia battente su un marciapiede di ciottoli, una mano in tasca, l'altra che tiene un ombrello rotto inclinato verso destra. Ripresa laterale in tracking lento, camera a livello del petto, leggero movimento a mano. Luce dei lampioni al sodio dall'alto, riflessi sull'asfalto bagnato, palette ambra e blu profondo, grana pellicola sottile."
La differenza non è la lunghezza, ma la specificità verificabile. Il secondo prompt contiene dettagli che il modello può tradurre in decisioni: il cappotto ha un materiale, l'ombrello è rotto e inclinato, la camera è dichiarata, la luce ha una temperatura. Ogni dettaglio riduce lo spazio di interpretazione casuale.
Quanto lungo deve essere un prompt
Non esiste un limite rigido, ma esiste un punto di saturazione. Nella pratica, i prompt migliori stanno tra le 40 e le 90 parole. Sotto le 30 il risultato è imprevedibile; sopra le 120 il modello inizia a ignorare sezioni intere. Se hai bisogno di più informazioni, dividi la scena in più clip e concatenale invece di comprimere tutto in un unico prompt.
Coerenza visiva: riferimenti e continuità tra le scene
La coerenza è il problema numero uno di chi produce sequenze e non singole clip. Un personaggio che cambia viso tra un'inquadratura e l'altra distrugge la sospensione dell'incredulità più di qualsiasi errore tecnico.
Quando usare un fotogramma di riferimento
La modalità image-to-video è lo strumento più potente per la continuità. Il flusso di lavoro consigliato è: genera un fotogramma chiave statico con un modello di immagine, verificalo, poi usalo come riferimento per la clip video. In questo modo il volto, il costume e la palette restano ancorati a un'immagine reale, non a una descrizione testuale che il modello reinterpreta ogni volta.
Se la scena richiede più angolazioni dello stesso soggetto, crea due o tre fotogrammi di riferimento coerenti tra loro prima di animare. Costa qualche minuto in più nella fase di preparazione e fa risparmiare molti tentativi nella fase di generazione.
Descrizioni riutilizzabili per i personaggi
Quando il riferimento immagine non è disponibile, usa una formula descrittiva fissa e ripetila identica in ogni prompt della sequenza. Non parafrasare. Se il personaggio è "donna sulla quarantina, capelli ricci castani raccolti, giacca di pelle nera, cicatrice sottile sopra il sopracciglio sinistro", quella stringa deve restare identica in tutte le scene. Ogni variazione lessicale introduce una variazione visiva.
Fusione multi-immagine e transizioni
Quando il modello supporta l'ingresso di più immagini, puoi usarlo per gestire le transizioni: l'ultimo fotogramma della clip A diventa il primo riferimento della clip B. Questo approccio produce raccordi morbidi senza dover descrivere a parole il passaggio. È particolarmente utile per carrellate, soggettive e scene in cui la camera attraversa un ambiente.
Realismo fisico: chiedere movimento credibile
Verbi di movimento e vincoli fisici
Hailuo risponde bene ai verbi che implicano una conseguenza fisica: inciampa, scivola, si appoggia, trascina, oscilla, rimbalza, si irrigidisce. Al contrario, verbi astratti come esprime, comunica, riflette non producono movimento visibile.
Aggiungere un vincolo aiuta ancora di più. "Cammina" è debole; "cammina zoppicando sul piede destro, spalla sinistra abbassata" è un'istruzione che il modello può tradurre in una posa e in un ritmo. Il vincolo fisico è ciò che separa una clip generica da una clip credibile.
Chi si muove e chi resta fermo
Uno dei modi più rapidi per rovinare una clip è chiedere contemporaneamente movimento del soggetto e movimento complesso di camera. Il modello tenta di fare entrambe le cose e ottiene instabilità.
La regola pratica: una sola intenzione dinamica dominante per clip. Se il soggetto compie un'azione forte, tieni la camera ferma o quasi. Se vuoi un movimento di camera marcato, fai restare il soggetto relativamente statico. I migliori risultati arrivano quando la camera e il soggetto si alternano come protagonisti del movimento.
Luce, ombre e coerenza dei materiali
Il realismo fisico dipende anche dalle ombre. Specificare la direzione della luce implica automaticamente una direzione delle ombre, e il modello tende a rispettarla. Indicare i materiali — pelle, cotone bagnato, metallo opaco, vetro sporco — migliora la resa della superficie e riduce l'effetto plastica che affligge molti video generati.
Prompt chaining: costruire sequenze narrative
Il principio della continuità variabile
Il prompt chaining consiste nel generare una sequenza come catena di clip brevi, dove ogni clip mantiene fissi alcuni elementi e ne varia altri. Gli elementi che restano fissi sono: identità del soggetto, costume, palette, direzione della luce, tipo di obiettivo. Gli elementi che cambiano sono: inquadratura, azione, durata, distanza focale.
Questa separazione è ciò che rende una sequenza leggibile. Se cambi tutto a ogni clip, ottieni una raccolta di frammenti scollegati. Se non cambi nulla, ottieni la stessa clip ripetuta.
Esempio: tre inquadrature per una scena d'azione
Clip 1 — establishing. Piano largo, soggetto che entra nell'inquadratura da destra, camera fissa, luce naturale del tardo pomeriggio. Funzione narrativa: collocare lo spazio.
Clip 2 — dettaglio. Primo piano sulle mani che stringono un oggetto, camera leggermente a mano, stessa luce ma più contrasto. Funzione narrativa: creare tensione.
Clip 3 — reazione. Mezzo busto, il soggetto si volta verso la camera, movimento rapido, camera che segue con un piccolo ritardo. Funzione narrativa: chiudere il ritmo.
Le tre clip condividono soggetto, costume, palette e direzione della luce. Cambiano scala, ritmo e funzione. Montate insieme funzionano come una scena, non come tre esperimenti separati.
Quanto deve durare ogni clip
Per il montaggio, clip da tre a sei secondi sono il compromesso più efficiente. Sotto i tre secondi il modello ha poco tempo per costruire movimento credibile; sopra gli otto secondi aumenta il rischio di deriva visiva, cioè di lento allontanamento dall'aspetto iniziale del soggetto. Meglio tre clip corte e coerenti che una clip lunga da correggere.
Parametri operativi: durata, formato e gestione delle risorse
Prima di scrivere prompt su larga scala, definisci i vincoli di produzione. Cambiano il modo in cui scrivi.
Formato. Se il progetto è verticale per il social, dichiara il rapporto d'aspetto nel prompt o imposta il parametro corretto: composizioni pensate per il 16:9 si svuotano nel 9:16, con soggetti troppo piccoli o tagliati.
Durata. Decidi se lavori su clip singole o su sequenze. Le clip singole richiedono prompt ricchi di dettaglio; le sequenze richiedono prompt brevi ma altamente coerenti, perché il dettaglio visivo verrà costruito dal montaggio.
Budget di generazione. Ogni tentativo ha un costo in tempo e risorse. Il modo più efficace per ridurlo non è scrivere prompt più corti, ma ridurre il numero di tentativi: usa fotogrammi di riferimento, riutilizza stringhe descrittive, testa una variabile alla volta. Dieci tentativi alla cieca costano più di tre tentativi informati.
Risoluzione e upscaling. Genera alla risoluzione nativa del modello e valuta l'upscaling solo sulle clip che sopravvivono al montaggio. Fare upscaling di tutto è uno spreco che non migliora la qualità percepita.
Workflow completo: dal concept alla clip finale
- Concept in una frase. Scrivi la scena in una singola frase con soggetto, luogo e conflitto. Se non riesci a riassumerla, non sei pronto a generarla.
- Shot list. Dividi la scena in tre-sei inquadrature con funzione narrativa dichiarata: establishing, dettaglio, reazione, transizione, chiusura.
- Bibbia visiva. Definisci palette, direzione della luce, tipo di obiettivo, grana, formato. Questi elementi resteranno fissi.
- Fotogrammi di riferimento. Genera un'immagine chiave per ciascun soggetto ricorrente e verificane la coerenza reciproca.
- Prompt per inquadratura. Applica la struttura in quattro blocchi, con una sola intenzione dinamica dominante.
- Generazione controllata. Cambia una variabile alla volta tra i tentativi: prima la camera, poi la luce, poi il ritmo. Annota cosa ha funzionato.
- Selezione e montaggio. Scegli le clip per funzione narrativa, non per bellezza isolata. Una clip spettacolare che non raccorda è inutile.
- Rifinitura. Colore, stabilizzazione, suono e micro-tagli si fanno in post-produzione, non nel prompt.
Il punto 6 è quello che distingue un artista digitale da un semplice utente: la generazione non è una slot machine, è un esperimento con variabili controllate.
Errori frequenti e come correggerli
| Errore | Sintomo | Correzione |
|---|---|---|
| Prompt sovraccarico | Alcuni dettagli ignorati del tutto | Riduci a 60-80 parole, una sola azione |
| Stile prima del soggetto | Clip bella ma vuota | Sposta soggetto e azione all'inizio |
| Doppio movimento | Camera instabile, soggetto deformato | Una sola intenzione dinamica per clip |
| Descrizioni variabili | Personaggio diverso a ogni scena | Stringa descrittiva identica, o riferimento immagine |
| Nessuna luce dichiarata | Illuminazione piatta e casuale | Specifica fonte, direzione e temperatura |
| Clip troppo lunghe | Volto che deriva lentamente | Spezza in clip da 3-6 secondi |
| Troppi tentativi casuali | Costi alti, risultati incoerenti | Cambia una variabile per volta e annota |
Un errore meno ovvio è correggere nel prompt ciò che va corretto in montaggio. Il ritmo, le transizioni e la continuità sonora appartengono alla post-produzione. Usare il prompt per risolvere problemi di montaggio è la strada più lenta possibile.
Domande frequenti
Hailuo è adatto a principianti? Sì, ma richiede disciplina più che esperienza tecnica. La curva di apprendimento non sta nello strumento: sta nell'imparare a descrivere una scena in modo verificabile. Chi ha esperienza di regia, fotografia o storyboard ha un vantaggio netto.
Meglio text-to-video o image-to-video? Dipende dall'obiettivo. Il text-to-video è più veloce per esplorare idee e per clip singole. L'image-to-video è superiore quando serve coerenza tra più inquadrature, perché ancora il risultato a un riferimento visivo verificato.
Perché il mio personaggio cambia aspetto tra le clip? Perché ogni generazione reinterpreta la descrizione. La soluzione è ripetere la stessa stringa descrittiva senza variazioni, oppure usare l'ultimo fotogramma della clip precedente come riferimento per la successiva.
Quante parole dovrebbe avere un prompt? Tra 40 e 90 parole nella maggior parte dei casi. Sotto le 30 il controllo è scarso, sopra le 120 il modello inizia a trascurare parti del testo.
Come si ottengono movimenti di camera fluidi? Dichiarando un solo movimento, la sua velocità e il punto di vista. "Carrellata laterale lenta a livello del petto" funziona; "camera dinamica che ruota e si avvicina" produce instabilità.
Serve conoscere la terminologia cinematografica? Aiuta molto. Termini come controluce, primo piano, camera a spalla, obiettivo grandangolare sono istruzioni compatte che sostituiscono intere frasi descrittive. Impararne una ventina migliora i risultati più di qualsiasi trucco.
Come si gestisce una scena con due personaggi? Con inquadrature separate e montaggio. Le interazioni complesse tra più soggetti restano il punto debole dei modelli video: genera i due personaggi in clip distinte, con la stessa luce e la stessa palette, e costruisci il dialogo visivo in montaggio.
Quanto conta il suono? Moltissimo nella percezione finale, anche se non si genera nel prompt. Una clip mediocre con sound design curato risulta più professionale di una clip spettacolare con audio improvvisato.
Conclusione operativa
Il prompt engineering per Hailuo non è una raccolta di parole magiche. È un metodo: descrivere una scena in modo che il modello possa prendere decisioni coerenti, isolare una variabile alla volta, ancorare la continuità a riferimenti visivi e riservare alla post-produzione tutto ciò che appartiene al montaggio. Chi lavora così produce meno tentativi, più materiale utilizzabile e sequenze che si sostengono anche quando lo spettatore smette di pensarci e inizia semplicemente a guardare.
