
เคล็ดลับการเล่าเรื่องด้วย AI: ออกแบบช็อตภาพยนตร์ระดับมืออาชีพ
Aug 4, 2026
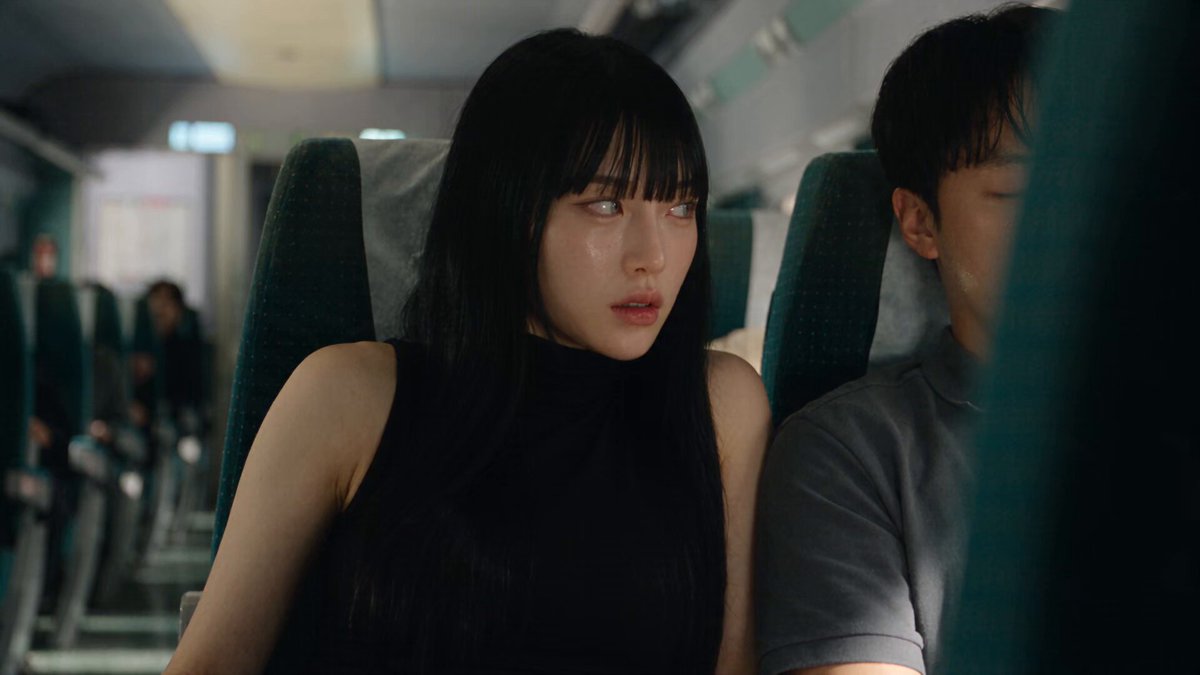
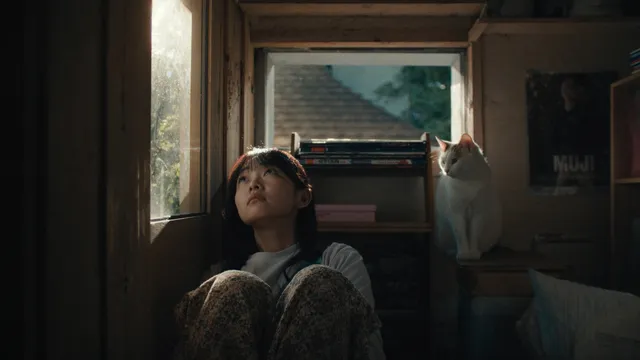
บทนำ: ภาพหนึ่งภาพเล่าเรื่องได้มากกว่าพันคำ
ในโลกของภาพยนตร์และวิดีโอ การเล่าเรื่องด้วยภาพ (Visual Storytelling) คือหัวใจของทุกอย่าง ไม่ใช่แค่ "มีภาพสวย ๆ" แต่เป็น "ภาพนี้กำลังบอกอะไรกับคนดู" ทุกช็อต ทุกมุมกล้อง ทุกแสงเงา ล้วนมีหน้าที่เล่าเรื่อง
AI ในปี 2025 ทำให้คุณสามารถควบคุมองค์ประกอบเหล่านี้ได้ แม้ไม่เคยเรียนภาพยนตร์มาก่อน domer.io คือเครื่องมือของคุณ
ภาษาของภาพ: พื้นฐานที่ต้องรู้
ขนาดช็อต (Shot Size)
แต่ละขนาดช็อตส่งผลต่ออารมณ์ต่างกัน:
- Extreme Long Shot (ELS): ตัวละครเล็กมากในเฟรม — ความโดดเดี่ยว, ความยิ่งใหญ่ของธรรมชาติ
- Long Shot (LS): เห็นตัวละครเต็มตัว — บริบท, การแนะนำสถานที่
- Medium Shot (MS): ครึ่งตัว — บทสนทนา, ปฏิสัมพันธ์
- Close-Up (CU): ใบหน้า — อารมณ์, ความรู้สึก
- Extreme Close-Up (ECU): ดวงตาหรือรายละเอียด — ความสำคัญสูงสุด, จุดเปลี่ยน
มุมกล้อง (Camera Angle)
- Eye Level: มุมปกติ — ความเป็นกลาง, สมจริง
- Low Angle: มองจากต่ำ — อำนาจ, ความยิ่งใหญ่, น่าเกรงขาม
- High Angle: มองจากสูง — ความอ่อนแอ, เล็ก, ถูกกดทับ
- Dutch Angle: เอียง — ความไม่มั่นคง, แปลกประหลาด, สับสน
การเคลื่อนกล้อง (Camera Movement)
- Static: กล้องนิ่ง — ความมั่นคง, สงบ, จดจ่อ
- Dolly In: เคลื่อนเข้า — เพิ่มความสนใจ, เปิดเผยข้อมูล
- Dolly Out: เคลื่อนออก — ปล่อยวาง, จบบท
- Pan/Tilt: หมุน — แสดงพื้นที่, เชื่อมโยง
เทคนิคการเล่าเรื่องด้วยภาพ
1. การใช้สี (Color)
สีแต่ละสีกระตุ้นอารมณ์ต่างกัน:
- แดง: อันตราย, ความรัก, พลัง
- ฟ้า: สงบ, เศร้า, เทคโนโลยี
- เหลือง: ความสุข, ความหวัง, คำเตือน
- เขียว: ธรรมชาติ, การเติบโต, ความอิจฉา
Tip: ใช้ Domer AI Image Generator ระบุโทนสีใน Prompt:
"Warm golden tones, nostalgic atmosphere"
2. แสงและเงา (Lighting)
- High-Key: สว่าง สม่ำเสมอ — ตลก, เบาสมอง, โรแมนติก
- Low-Key: มืด มีเงาลึก — ลึกลับ, ระทึกขวัญ, ดราม่า
- Side Light: แสงด้านข้าง — มิติ, ความลึก, ความขัดแย้งภายใน
- Back Light: แสงจากด้านหลัง — ภาพเงา, ความลึกลับ
3. การจัดองค์ประกอบ (Composition)
Rule of Thirds: แบ่งเฟรมเป็น 3x3 วางตัวละครที่เส้นตัด ไม่ใช่กลางภาพ
Leading Lines: ใช้เส้นในภาพนำสายตาคนดู
Depth: เพิ่มมิติด้วย Foreground, Midground, Background
Workshop: ออกแบบ 3 ช็อตสำหรับเรื่องสั้น
เรื่อง: "การตัดสินใจ"
ตัวละครต้องเลือกทางใดทางหนึ่ง
ช็อต 1: ความสับสน
- Shot: Medium Close-Up
- Angle: Eye Level
- Light: Low-Key, เงาลึกครึ่งหน้า
- Color: โทนเย็น (ฟ้า/เทา)
- Prompt: "Medium close-up of a person's conflicted face, half in shadow, cool blue tones, low-key lighting, cinematic"
ช็อต 2: ทางเลือก
- Shot: Long Shot
- Angle: Low Angle
- Light: แสงแยกสองทาง (อุ่น vs เย็น)
- Color: ด้านซ้ายอบอุ่น ด้านขวาเย็น
- Prompt: "Long shot of a person at a fork in the road, warm light on the left path, cool light on the right, low angle, dramatic"
ช็อต 3: การตัดสินใจ
- Shot: Close-Up
- Angle: Eye Level → tilt up เล็กน้อย
- Light: High-Key, สว่าง
- Color: โทนอุ่น (ทอง/ส้ม)
- Prompt: "Close-up of determined eyes, warm golden light washing over the face, slight upward tilt, hopeful atmosphere"
สร้างช็อตด้วย domer.io แล้วนำมาต่อกันด้วย AI Video Generator
เคล็ดลับมือโปร
1. ตั้งชื่อช็อต
ตั้งชื่อแต่ละช็อตเพื่อให้ทีมเข้าใจตรงกัน: "CU_hero_determination_v3"
2. ทำ Shot List
ก่อนเริ่มสร้าง เขียนรายการทุกช็อต:
| ช็อต | ขนาด | มุม | แสง | อารมณ์ |
|---|---|---|---|---|
| 1 | CU | Eye Level | Low-Key | สับสน |
| 2 | LS | Low Angle | Split | ทางเลือก |
| 3 | CU | Tilt Up | High-Key | มุ่งมั่น |
3. Consistency is King
ใช้ GPT Image 2 สร้าง Reference Image ของตัวละคร แล้วใช้ในทุกช็อต
4. แอนิเมชันคุณภาพ
เปลี่ยนช็อตนิ่งเป็นวิดีโอด้วย Seedance 2.0
สรุป
การเล่าเรื่องด้วยภาพไม่ใช่พรสวรรค์ — มันคือทักษะที่เรียนรู้ได้ AI ทำให้คุณทดลองเทคนิคระดับมืออาชีพได้โดยไม่ต้องมีกล้องราคาแพง ฝึกทำทุกวัน แล้วคุณจะเห็นพัฒนาการอย่างรวดเร็ว
เริ่มต้นที่ domer.io
FAQ
ต้องมีความรู้ภาพยนตร์มาก่อนไหม?
ไม่จำเป็น บทความนี้ให้พื้นฐานพอเริ่มต้นได้
Prompt ภาษาไทยใช้ได้ไหม?
ใช้ภาษาอังกฤษจะให้ผลลัพธ์แม่นยำกว่า
ใช้เวลานานแค่ไหนถึงจะเก่ง?
สร้างวันละ 1 ช็อต ฝึก 30 วันก็เห็นความแตกต่างชัดเจน

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.