
Introducción
En la producción de video generado por IA, mantener la coherencia visual es el factor que separa el contenido amateur del profesional. Un personaje que cambia de rostro entre escenas, una ambientación que varía de color sin motivo o un estilo que se rompe en cada corte: todos estos problemas tienen una misma raíz, la falta de control sobre la identidad visual.
La fusión multi-imagen se ha convertido en la solución estándar para este desafío. En lugar de confiar únicamente en descripciones de texto, el sistema utiliza un conjunto de imágenes de referencia para fijar la apariencia de personajes y escenarios.
Por qué el texto no basta
Una descripción como «una guerrera con armadura plateada» deja demasiado margen de interpretación. Cada modelo genera una versión ligeramente distinta: el tono del metal, la forma del casco, los detalles del rostro. En un plano aislado la diferencia es imperceptible; en una secuencia de varios planos, se vuelve evidente.
El problema crece cuando se combinan varios modelos. Cada motor de generación tiene su propio estilo visual, y cambiar de modelo entre escenas casi garantiza una ruptura en la identidad del personaje.
Cómo funciona la fusión multi-imagen
Paso 1: Crear el set de referencias
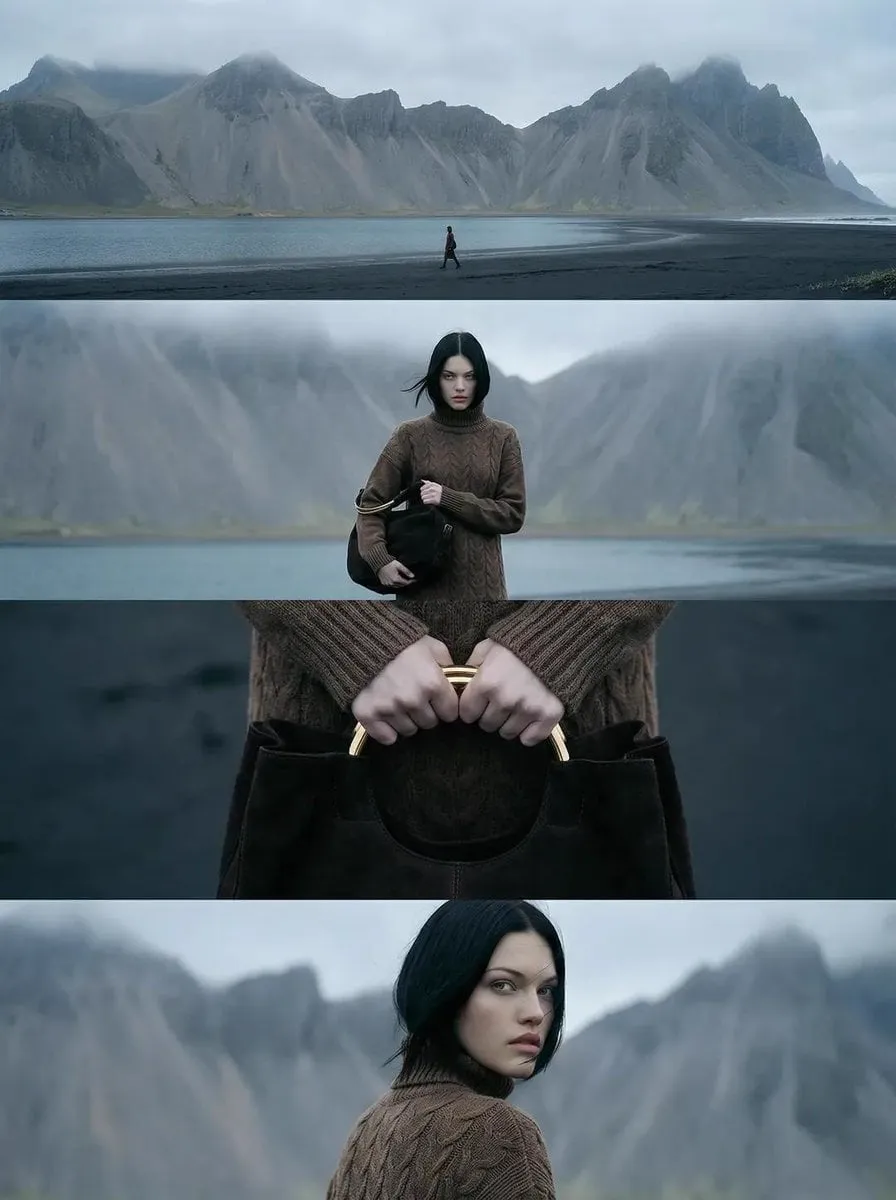
Genere de 5 a 10 imágenes del personaje: retrato frontal, perfil, tres cuartos, distintas expresiones y planos de cuerpo completo. Cuanta más variedad de ángulos e iluminación, más robusto será el perfil. Para generar estas referencias en un estilo coherente, un generador de imágenes con IA es la herramienta ideal.
Paso 2: Fijar los rasgos invariantes
El sistema analiza las imágenes y extrae las características estables: estructura facial, color de ojos, elementos distintivos de vestuario. Estas características se convierten en un perfil de personaje que se inyecta como restricción en el modelo de generación.
Paso 3: Aplicar el perfil en cada generación
Una vez creado, el perfil se aplica a todas las generaciones posteriores, sin importar el modelo elegido. Puede variar el estilo de la escena, la iluminación y los ángulos, pero los rasgos fundamentales del personaje se mantienen. Esto es especialmente útil en la generación de video a partir de imagen, donde la imagen fuente define apariencia y composición.
Técnicas prácticas
Separar identidad y estilo
La identidad debe ser estable: rostro, cuerpo, vestuario característico. El estilo puede variar: iluminación, colorimetría, atmósfera. Esta separación permite aplicar distintos estilos al mismo personaje sin deformar sus rasgos.
Crear una ficha de identidad
Produzca un set de imágenes estándar del personaje y guárdelo en la carpeta del proyecto. Úselas como entrada para la generación de video desde texto o desde imagen. Un estándar único es la garantía contra la deriva de identidad en proyectos largos.
Probar en secuencias cortas
Antes de lanzar una escena completa, genere una secuencia de 3 a 5 planos y verifique la estabilidad de los rasgos. Una prueba rápida ahorra tiempo y recursos que se gastarían en regeneraciones.
Trabajar con múltiples modelos
La fusión multi-imagen muestra todo su potencial cuando se combinan modelos para tareas distintas:
- Un modelo fuerte en iluminación para los planos de ambiente.
- Un modelo preciso en física de movimiento para escenas dinámicas.
- Un modelo rápido para maquetas y guiones gráficos.
El mismo perfil de personaje se transmite a los tres modelos, permitiendo cambiar de uno a otro sin romper la continuidad. Para escenas complejas con movimiento de cámara, un generador de video con IA con control de cámara ayuda a mantener un lenguaje visual homogéneo.
Errores comunes
Pocas referencias
Una o dos imágenes no bastan. Un rostro de frente y uno de perfil son conjuntos de datos distintos. Reúna al menos cinco imágenes desde ángulos variados.
Referencias contradictorias
Si las referencias se contradicen, el sistema calcula un promedio borroso. Mantenga referencias coherentes con los mismos detalles clave.
Omitir la verificación
Incluso con un perfil perfecto, pueden aparecer desviaciones aleatorias. Verifique siempre la secuencia completa, no solo los planos aislados.
Conclusión
La fusión multi-imagen es el estándar del trabajo profesional con video generativo. Resuelve el problema principal de los prompts textuales: la inestabilidad de la identidad. Comience con un set de referencias de calidad, fije el perfil del personaje y aplíquelo a todas sus generaciones, desde la creación de video por texto hasta proyectos multicena complejos.
Al dominar este enfoque, podrá construir narrativas largas con el mismo protagonista, cambiar de estilo entre episodios y trabajar con varios modelos generativos sin perder la coherencia visual. Esa es la base para producir contenido que se sienta profesional, consistente y digno de una producción cinematográfica.
