
マルチ画像フュージョン技術で実現する一貫したキャラクター表現
Aug 4, 2026
ブレないキャラクター表現を実現する技術
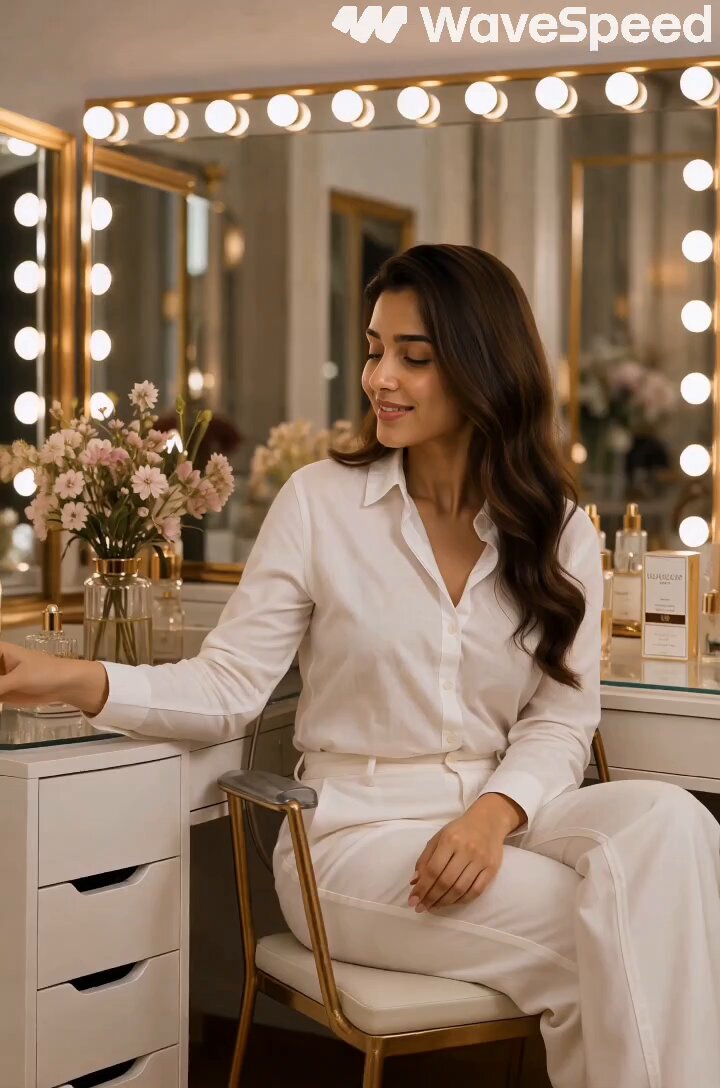
AI動画制作において、最もクリエイターを悩ませるのが「キャラクターの一貫性」です。同じ人物のはずが、シーンごとに違う顔になってしまう——これは視聴者の没入感を大きく損ないます。この課題を解決するのがマルチ画像フュージョン技術です。AI video generatorに複数の参照画像を与えることで、AIが一貫したキャラクター像を構築します。
なぜ従来の手法ではダメだったのか
単一の参照画像だけでは、AIは限られた角度や表情しか学習できません。その結果:
- 横顔が不自然になる
- 表情の変化で別人に見える
- 照明条件が変わると特徴が失われる
マルチ画像フュージョンは、これらの問題を根本から解決します。
マルチ画像フュージョンの仕組み
技術的な背景
AIは複数の画像からキャラクターの「本質的な特徴」を抽出します:
- 骨格構造
- 目・鼻・口の配置比率
- 肌の質感と色味
- 髪質と髪型のシルエット
これらの情報を統合し、まだ見ぬ角度や表情でも同一人物として生成できるようになります。
必要な参照画像
効果的なフュージョンには、以下のバリエーションが理想的です:
| 種類 | 目的 |
|---|---|
| 正面 | 基本構造の把握 |
| 横顔 | 奥行きと立体感 |
| 斜め45度 | 中間角度の補完 |
| 無表情 | ベースライン |
| 笑顔 | 表情変化の学習 |
画像品質の重要性
参照画像の品質が結果を左右します。AI image generatorで高品質な参照画像を生成することが、成功の第一歩です。
- 均一な照明
- シンプルな背景
- 同じ服装と髪型
- 高解像度(最低1024px)
実践ワークフロー
Step 1: キャラクターデザインの確定
まずGPT Image 2で理想的なキャラクターを生成します。この時点で、年齢、人種、体格、髪型、服装を詳細に指定します。
Step 2: 参照セットの作成
確定したデザインをベースに、5〜7枚のバリエーションを生成:
- 同一プロンプトで角度指定を変える
- 表情キーワードを追加する
- すべて同じシード値を使用する
Step 3: フュージョン生成
image-to-videoに参照セットを投入。AIが特徴を学習し、一貫性のあるキャラクターで動画を生成します。
Step 4: 品質チェックと調整
生成結果をチェックし、必要に応じて参照画像を追加・差し替え。問題がある部分は再生成します。
高度なテクニック
年齢・時間変化の表現
同一キャラクターの「若い頃」と「現在」を表現したい場合:
- 基本の参照セットに加えて
- 「10年前」バージョンの参照を追加
- プロンプトで時間的変化を明示
特殊メイク・変身
キャラクターが変身するシーンでは:
- 変身前の参照セット
- 変身後の参照セット
- 中間段階はAIが自動補間
複数キャラクターの同時制御
複数人が登場するシーンでは、各キャラクターに個別の参照セットを用意。AIはそれぞれ独立して一貫性を維持します。
活用シーン
アニメ・漫画制作
キャラクターの「絵柄」を全カットで統一。作画監督の負担を劇的に軽減します。
ブランドマスコット
企業のマスコットキャラクターを、あらゆる媒体で一貫して表現。ブランド価値の向上に直結します。
VTuber / バーチャルタレント
同一アバターを様々なシチュエーションで自然に動かすことが可能に。コンテンツの幅が大きく広がります。
教育コンテンツ
説明動画の進行役キャラクターをシリーズ全体で統一。視聴者の信頼感と親しみを醸成します。
限界と注意点
完全な同一ではない
AIによる生成である以上、100%同一のキャラクターにはなりません。しかしマルチ画像フュージョンにより、人間の目には「同じ人物」と認識できるレベルに達しています。
参照画像の質がすべて
粗い画像や矛盾した画像を参照にすると、かえって品質が下がります。Garbage in, garbage out の原則が適用されます。
処理時間とコスト
複数画像を処理するため、単一参照より時間がかかります。Seedance 2.0のような高性能モデルを使用することで、処理時間と品質のバランスを最適化できます。
まとめ
マルチ画像フュージョンは、AI動画制作における「キャラクターの一貫性問題」を解決する最も実践的なアプローチです。適切な参照画像の準備と、モデルの特性を理解した運用で、プロフェッショナルな品質のコンテンツを効率的に生産できます。

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.