
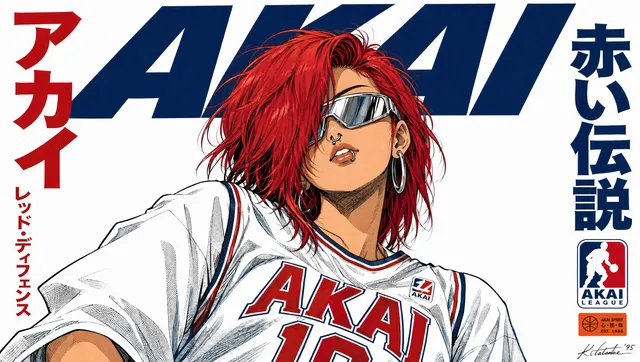
Dal Testo all'Immagine all'Animazione: La Guida Completa alla Creazione AI
Aug 4, 2026
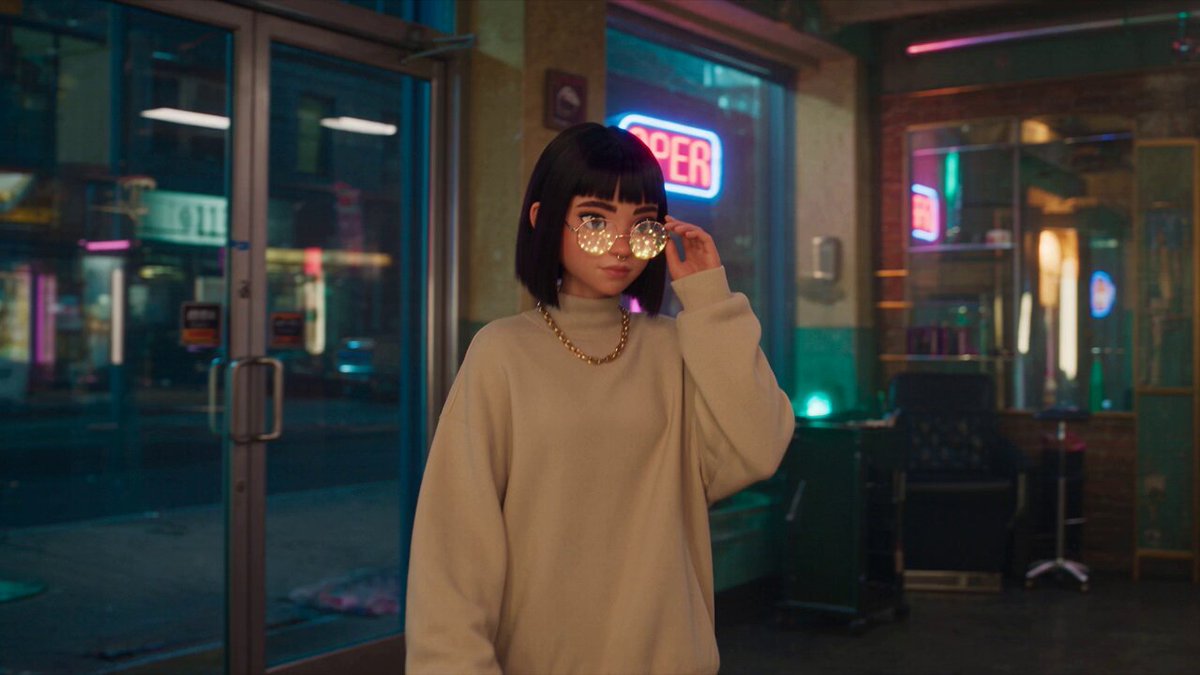
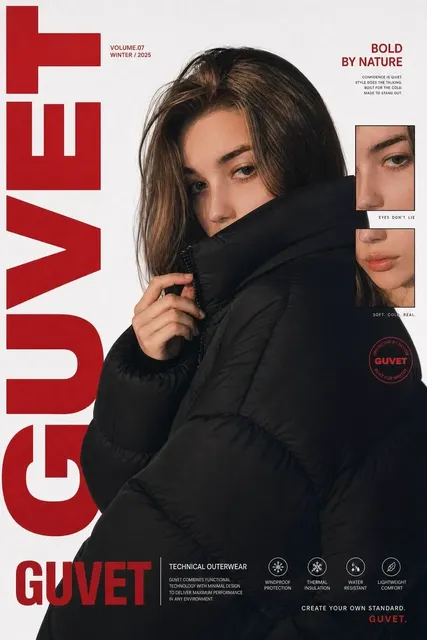
Il Flusso Creativo nell'Era dell'IA
La creazione di contenuti digitali sta vivendo una trasformazione radicale. Oggi, un creatore può partire da una semplice descrizione testuale e arrivare a un'animazione completa in pochi passaggi, grazie all'intelligenza artificiale generativa.
Questo flusso - dal testo all'immagine, dall'immagine all'animazione - rappresenta il nuovo paradigma della produzione creativa. Con il generatore di video AI di Domer, l'intero processo diventa accessibile a chiunque.
Fase 1: Dal Testo all'Immagine
Il punto di partenza è sempre un prompt testuale ben costruito. Più dettagliato è il prompt, migliore sarà il risultato. Specifica soggetto, stile, illuminazione e composizione. Con GPT Image 2, puoi ottenere immagini di qualità eccezionale con prompt in italiano.
Fase 2: Dall'Immagine all'Animazione
Una volta ottenuta l'immagine perfetta, il passo successivo è darle vita. Il convertitore immagine-video di Domer trasforma immagini statiche in brevi animazioni fluide, ideali per post social dinamici, intro e outro per video, e contenuti pubblicitari.
Fase 3: Rifinitura
Per risultati professionali, utilizza l'image-to-image per apportare modifiche mirate senza dover ricominciare da zero. Puoi cambiare colori, aggiungere elementi o modificare lo stile mantenendo la composizione originale.
Consigli Pratici
Inizia sempre con prompt semplici. Testa diversi stili prima di impegnarti. Documenta i prompt che funzionano meglio. Sfrutta il generatore di immagini AI per creare librerie di asset riutilizzabili.
Conclusione
Il flusso testo-immagine-animazione sta democratizzando la produzione creativa. Non servono più competenze di modellazione 3D o animazione tradizionale: bastano le parole giuste e gli strumenti adatti.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.