
Twórz Własne Postacie AI: Opanuj Multi-Image Fusion dla Spójnych Scen
W 2026 roku standardem stała się fotorealistyczna jakość i złożoność narracyjna w generowaniu wideo przez AI. Ale jest jedna rzecz, która wciąż odróżnia amatorów od profesjonalistów: umiejętność utrzymania spójności postaci. Generowanie długich sekwencji, w których bohater zachowuje identyczne rysy twarzy, ubiór i sylwetkę — niezależnie od zmiany oświetlenia, kąta kamery czy kontekstu sceny — to największe wyzwanie techniczne w tej branży.
Ten artykuł pokazuje, jak opanować technikę, która to rozwiązuje: multi-image fusion (fuzję wielu obrazów).
Problem: Dryf Wizualny
W tradycyjnym modelu tekst-na-wideo każda nowa klatka jest wynikiem niezależnego wnioskowania. Model naturalnie generuje nową interpretację postaci przy każdym prompcie — zmieniają się proporcje twarzy, detale, znaki rozpoznawcze. Ten "dryf wizualny" niszczy immersję widza i buduje poczucie, że ogląda się przypadkowy zlepek klipów, a nie spójną historię.
Badania są jednoznaczne: spójność postaci jest czterokrotnie ważniejsza dla utrzymania zaangażowania widza w narracyjnych treściach niż początkowa jakość renderowania. Postać, która zmienia twarz w połowie filmu, niszczy wszystko — nawet jeśli każdy pojedynczy kadr wygląda świetnie.
Rozwiązanie: Multi-Image Fusion
Multi-image fusion to technologia, która działa na poziomie kontroli kluczowych klatek. Dostarczasz zestaw referencyjnych obrazów postaci, a system traktuje je nie jako sugestie stylu, ale jako macierze tożsamości.
Jak to działa w praktyce:
- Wektoryzacja cech: system analizuje geometryczne, teksturalne i chromatyczne cechy referencji i tworzy unikalny embedding wektorowy postaci
- Wstrzyknięcie tożsamości: ten embedding jest "wstrzykiwany" do potoku generacyjnego każdego modelu
- Warstwowanie: informacje o postaci są nakładane na wynik generowany przez wybrany model wideo
Dzięki temu, nawet jeśli dwa modele mają fundamentalnie różne style generowania, bazują na tej samej macierzy tożsamości. Dokładność zachowania kluczowych cech twarzy przy użyciu zaawansowanych metod fuzji sięga ponad 90%, w porównaniu do około 65% w standardowych systemach wieloobrazowych.
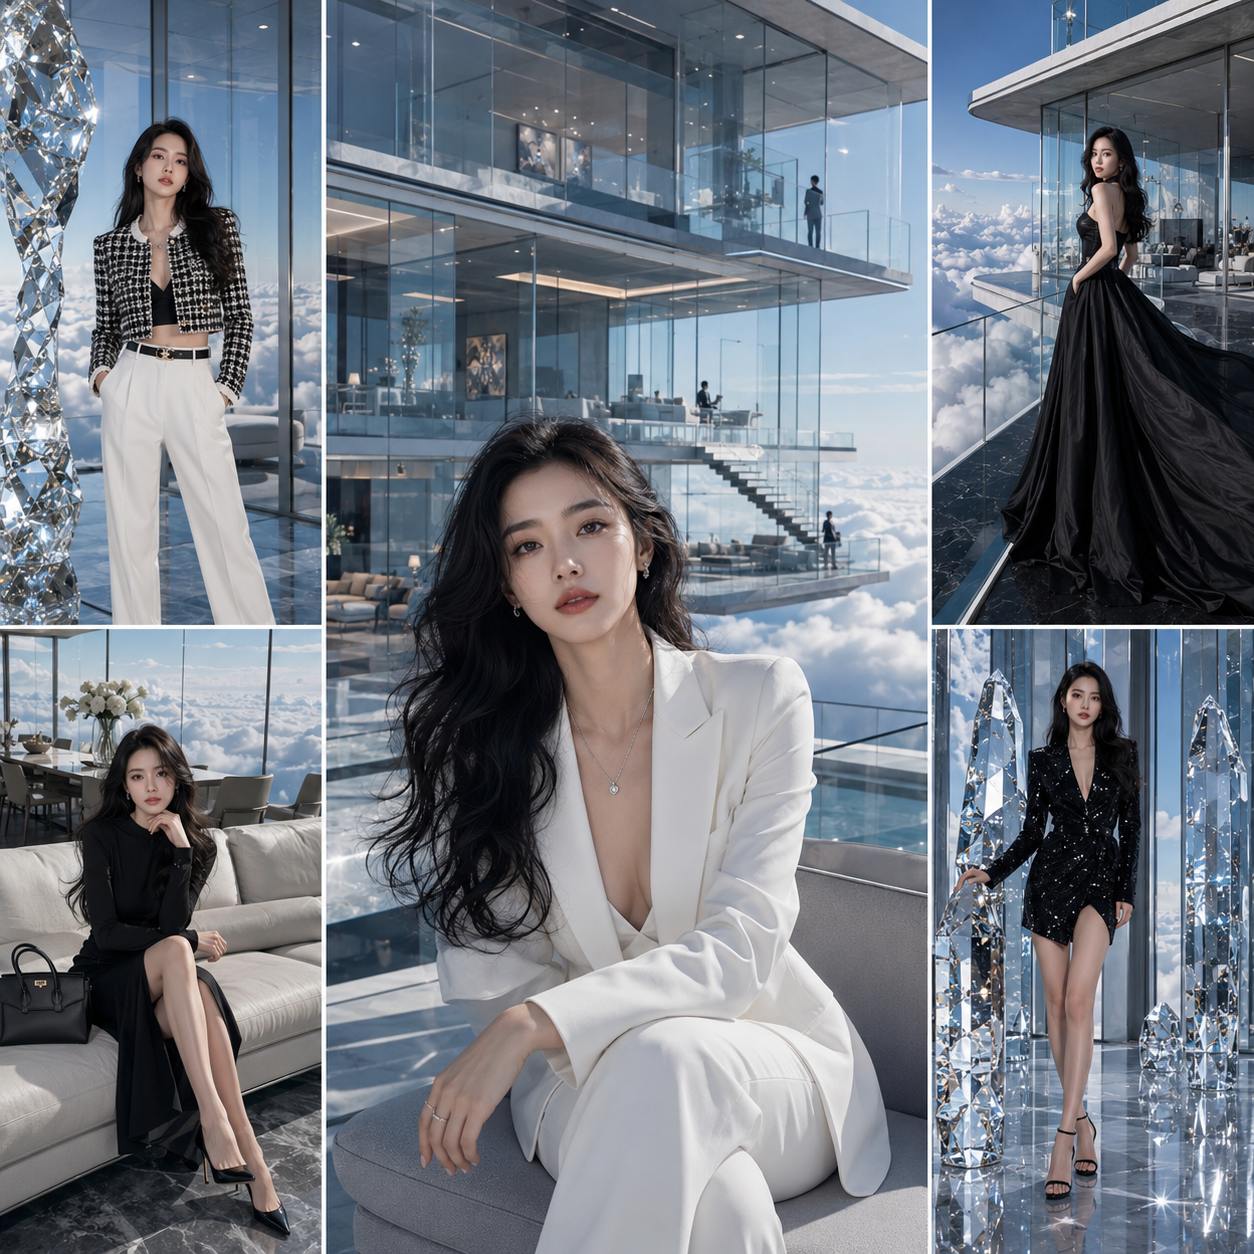
Krok 1: Zbierz Właściwy Materiał Referencyjny
Jakość fuzji zależy bezpośrednio od jakości i różnorodności obrazów referencyjnych. Nie wystarczy jeden doskonały portret. Zasada 10 perspektyw:
- Przód, profil, ujęcie 3/4
- Ujęcie od dołu i od góry
- Różne ekspresje: neutralna, uśmiech, złość
- Różna odległość: zbliżenie na oczy, pełna sylwetka
Obrazy referencyjne powinny mieć zróżnicowane tło, aby algorytm fuzji nauczył się separować cechy postaci od tła. Jednak kluczowe cechy — na przykład specyficzny emblemat na ramieniu — muszą być wyraźnie widoczne w co najmniej dwóch ujęciach.
Do przygotowania referencji możesz użyć generatora obrazów AI — wygeneruj postać w różnych pozach, światłach i ujęciach, zachowując spójność kluczowych elementów.
Krok 2: Zweryfikuj Fuzję Przed Kosztownymi Procesami
Po załadowaniu referencji system wykonuje szybki test fuzji na statycznym kadrze. Widzisz przezroczyste nałożenie wskaźników referencyjnych na wynik generacji — to pozwala ocenić dokładność wektoryzacji cech, zanim uruchomisz kosztowne procesy wideo.
Zawsze wykonuj ten krok. Uratuje cię przed setkami nieudanych generacji i zmarnowanym budżetem.
Krok 3: Testuj Postać na Różnych Modelach
Prawdziwa moc multi-image fusion ujawnia się, gdy ta sama postać jest renderowana za pomocą różnych modeli — dla fotorealizmu i dla dynamicznej animacji. Możesz uruchomić generowanie wsadowe na kilku modelach i porównać wyniki wizualne: który model najlepiej oddaje subtelne niuanse twojej postaci.
Kluczowa zasada: nie zakładaj z góry, który model będzie najlepszy. Testuj, porównuj i wybieraj na podstawie rzeczywistych wyników. Model, który świetnie radzi sobie ze scenami akcji, może nie być najlepszy do scen dialogowych.
Krok 4: Zadbaj o Dynamikę
Najtrudniejszym elementem spójności jest dynamika. Gdy postać się porusza lub zmienia wyraz twarzy, fuzja musi adaptacyjnie modyfikować tekstury i cieniowanie, nie naruszając przy tym podstawowego kształtu nosa czy linii szczęki.
Nowoczesne systemy radzą sobie z tym przez:
- Dynamiczne maskowanie kontekstowe: stabilizacja rysów podczas intensywnych zmian wyrazu twarzy
- Korekty ruchu i dopasowanie barw: automatyczne wyrównanie między klipami wygenerowanymi przez różne modele
- Zarządzanie spójnością rekwizytów: jeśli postać trzyma unikalny artefakt, system wymusza, aby ten artefakt się nie zmieniał
Krok 5: Zapisz Profil Postaci
Po pomyślnym zakończeniu sekwencji, cała konfiguracja — zestaw referencyjnych obrazów, zastosowany model fuzji, parametry i użyte modele wideo — powinna zostać zapisana jako profil postaci. Ten profil może być natychmiast załadowany do kolejnego projektu, gwarantując powtarzalność procesu.
To jest klucz do budowania serii, seriali i kampanii z powracającymi bohaterami: raz zdefiniowana postać jest zawsze tą samą postacią.
Zaawansowane Podejście: Własny Model Postaci
Dla postaci o bardzo specyficznym stylu artystycznym, który nie jest dobrze oddany przez standardowe modele, warto rozważyć trenowanie własnego modelu. To pozwala na głębszą integrację tożsamości postaci z wnętrzem modelu bazowego.
W tym podejściu:
- Trenujesz model na zestawie obrazów swojej postaci
- Ustawiasz go jako główny generator dla postaci
- Multi-image fusion działa wtedy jako dodatkowa warstwa, która koryguje wszelkie dryfty wprowadzone przez niedoskonałości procesu treningu
To podejście łączy zalety obu światów: głęboką integrację stylu z elastyczną korektą na poziomie generacji.
Zarządzanie Kosztami
Fuzja wielu obrazów jest intensywna obliczeniowo. Efektywne zarządzanie zadaniami jest krytyczne dla utrzymania niskich kosztów operacyjnych. Kluczowe zasady:
- Priorytetyzacja: zadania wymagające fuzji są oznaczane wyższym priorytetem, bo ich niepowodzenie skutkuje utratą całego kontekstu postaci
- Dopasowanie modelu do sceny: dla scen z rozległymi ujęciami krajobrazowymi, gdzie detale postaci są mniej krytyczne, wybieraj tańsze modele; dla zbliżeń na twarz — najmocniejsze dostępne
- Przewidywanie kosztów: sprawdzaj szacowany koszt dla danej sekwencji przed jej uruchomieniem — to kluczowe dla budżetowania projektów filmowych
Model, który osiąga wysoką stabilność przy użyciu tańszego rozwiązania, powinien być używany — oszczędzasz kredyty bez straty jakości. Warto porównać opcje takie jak GPT Image 2 dla detali i Seedance 2.0 dla płynnych ruchów.
Podsumowanie: Proces Krok po Kroku
- Zbierz zestaw referencyjnych obrazów — minimum 10 perspektyw
- Zweryfikuj fuzję na statycznym kadrze przed kosztownymi procesami
- Testuj postać na różnych modelach i wybierz najlepszy
- Zadbaj o dynamikę: ruch, mimika, rekwizyty
- Zapisz profil postaci do powtórnego użycia
- Rozważ trenowanie własnego modelu dla unikalnych stylów
- Zarządzaj kosztami przez dopasowanie modelu do sceny
Multi-image fusion to nie opcjonalny dodatek — to krytyczna infrastruktura dla każdego, kto chce tworzyć serie, reklamy i narracyjne filmy oparte na oryginalnych bohaterach AI. Przesuwa punkt ciężkości z generowania pojedynczych klipów na budowanie cyfrowych franczyz.
Zacznij od jednej postaci i jednej krótkiej sekwencji. Zbierz referencje, przetestuj fuzję, porównaj modele i zapisz profil. Kiedy opanujesz ten proces, twoje historie zyskają spójność, która wyróżni cię na tle tysięcy generycznych treści. Pełny pipeline możesz zbudować wokół generatora wideo AI.
