
Czym jest multi-image fusion i dlaczego rozwiązuje problem spójności
Spójność bohatera to najczęstszy powód, dla którego ambitny projekt animowany rozsypuje się w połowie produkcji. Pierwsze ujęcie wygląda świetnie, drugie jeszcze akceptowalnie, a przy szóstym ta sama postać przypomina kogoś zupełnie innego. Multi-image fusion, czyli fuzja wielu obrazów, adresuje ten problem u samych podstaw: zamiast opisywać bohatera słowami, dostarczasz modelowi zestaw zdjęć referencyjnych, na których postać wygląda dokładnie tak, jak chcesz ją widzieć w każdym kadrze.
Mechanizm jest prosty w założeniu i wymagający w praktyce. Model koduje referencje do wspólnej przestrzeni cech wizualnych — twarz, sylwetkę, ubiór, kolorystykę, fakturę materiałów — a następnie warunkuje generowanie kolejnych klatek tym zakodowanym profilem. Kolejne ujęcia nie powstają więc od zera, lecz są dopasowywane do ustalonego wzorca wizualnego. Efektem jest stabilna tożsamość postaci przy zachowaniu naturalnego ruchu i zmiennych kadrów.
Od text-to-video do fuzji wielu referencji
Klasyczne text-to-video operuje wyłącznie na języku. Model nie ma trwałej pamięci postaci, więc w każdym ujęciu twarz powstaje z rozkładu prawdopodobieństwa, a nie z konkretnego zdjęcia. To dlatego opis „ta sama kobieta w czerwonym płaszczu, 30 lat, ciemne włosy” daje w praktyce kilka różnych osób — sieć za każdym razem trafia w inny punkt przestrzeni możliwych twarzy.
Fuzja referencji zmienia punkt wyjścia. Zamiast wnioskować wygląd z opisu, model otrzymuje konkretne piksele i uczy się, które z nich są istotne dla tożsamości, a które są przypadkowym tłem. W ten sposób informacja o wyglądzie staje się ograniczeniem, a nie sugestią. W praktyce oznacza to mniej poprawek, krótsze serie akceptacji i możliwość planowania scen z wieloma ujęciami bez obawy, że bohater rozjedzie się wizualnie.
Trzy warstwy spójności: tożsamość, styl i scena
Najlepsze rezultaty osiągniesz, gdy rozdzielisz spójność na trzy niezależne warstwy, bo każda z nich wymaga innych materiałów wejściowych:
- Tożsamość — twarz, proporcje, wiek, charakterystyczne detale. Tu liczą się przede wszystkim zbliżenia i ujęcia z różnych kątów.
- Styl — paleta barw, ziarno, kontrast, gatunek obrazu. Tę warstwę definiujesz osobnymi kadrami nastroju, a nie zdjęciami postaci.
- Scena — światło, otoczenie, rekwizyty, pora dnia. Scena może się zmieniać między ujęciami, ale powinna mieć wewnętrzną logikę.
Mieszanie tych warstw w jednym zestawie referencji to najczęstsza przyczyna chaosu. Jeśli jako wzorzec stylu podasz zdjęcie nocnej ulicy, model może próbować odtworzyć jej oświetlenie w ujęciu dziennym. Rozdzielenie warstw pozwala precyzyjnie powiedzieć systemowi, co ma zostać stałe, a co może się zmieniać.
Anatomia dobrego zestawu referencji
Jakość wyjścia rzadko przewyższa jakość wejścia. Zestaw referencji to nie galeria ulubionych zdjęć, lecz specyfikacja techniczna bohatera. Warto traktować go jak arkusz produkcyjny: minimum informacji, maksimum trafności.
Ile zdjęć naprawdę potrzeba
W większości przypadków wystarczy od trzech do sześciu zdjęć postaci. Poniżej trzech model ma zbyt mało danych, by odróżnić cechy stałe od przypadkowych — na przykład uzna cień pod nosem za element tożsamości. Powyżej ośmiu wzrasta ryzyko konfliktów: jeśli zdjęcia różnią się fryzurą lub makijażem, model uśredni je w coś pomiędzy i żadne z ujęć nie będzie wyglądało wiarygodnie.
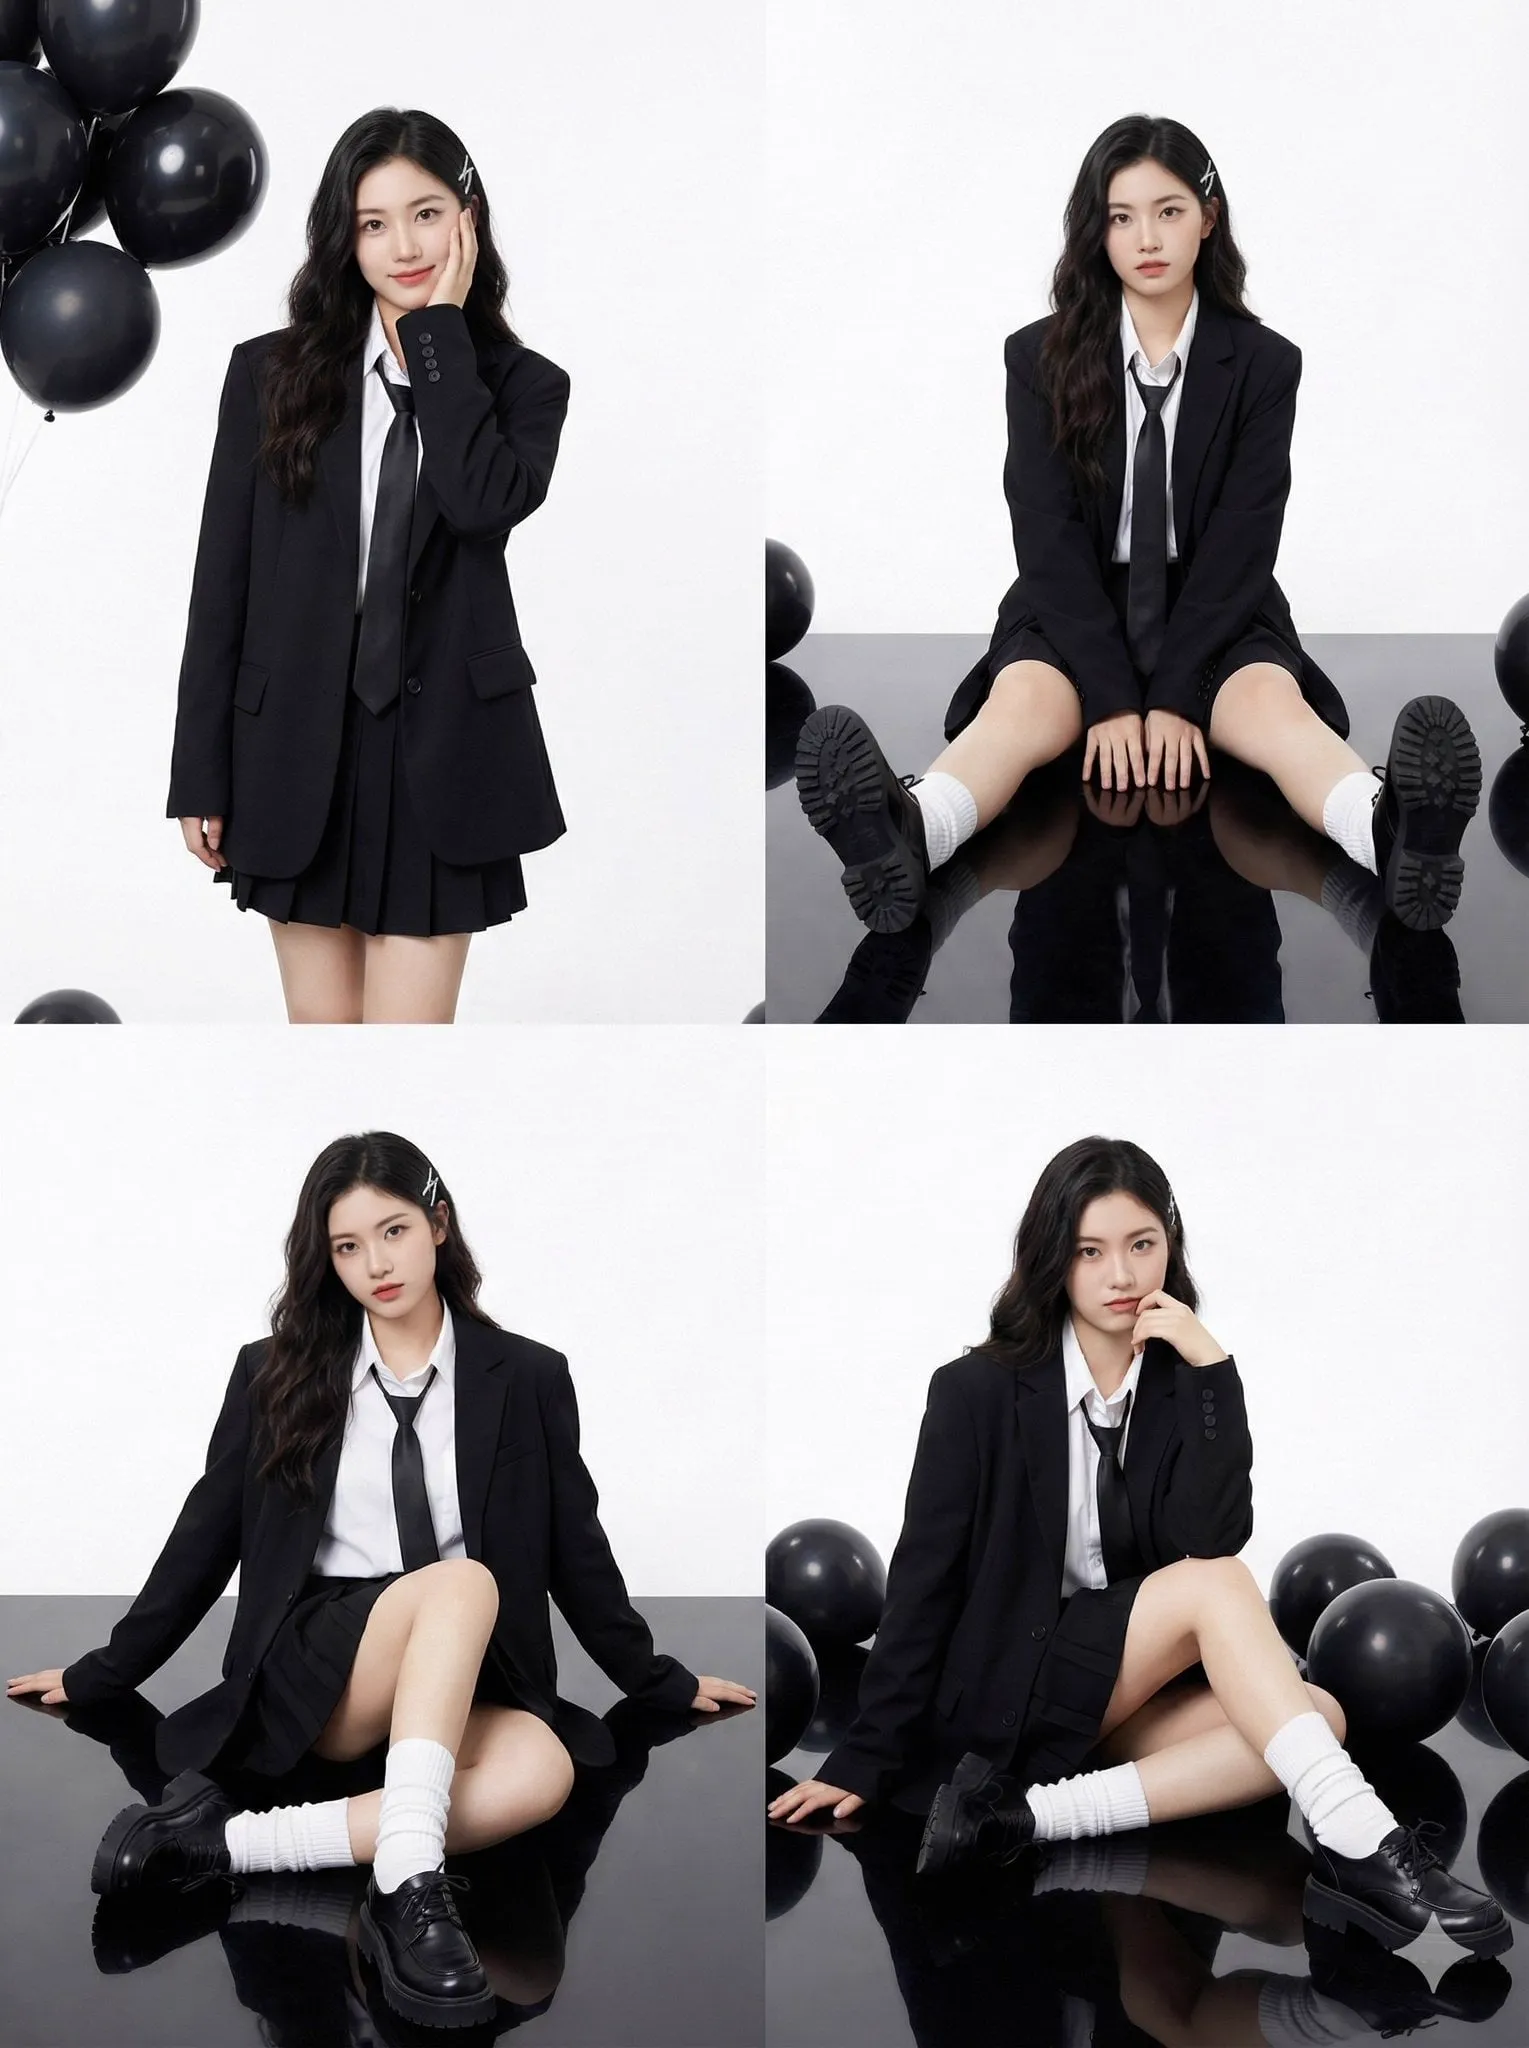
Optymalny zestaw zawiera zwykle jedno zbliżenie twarzy na wprost, jedno w profilu trzy czwarte, jedno półpostaciowe i jedno w ruchu lub w innym oświetleniu. Taki zestaw pokrywa geometrię twarzy, proporcje i zachowanie materiałów.
Jak przygotować pliki
Przed wgraniem referencji warto wykonać kilka prostych kroków:
- Ujednolić kadrowanie — postać powinna zajmować podobną część kadru na każdym zdjęciu.
- Usunąć tło albo je ujednolicić — jeśli tło jest istotne dla stylu, przygotuj je jako osobny zestaw.
- Zachować rozdzielczość — unikaj mocno skompresowanych plików, bo artefakty JPEG stają się częścią profilu postaci.
- Sprawdzić ostrość — rozmyte zdjęcia uczą model miękkości, której potem nie da się usunąć promptem.
- Zweryfikować kolor — zdjęcia z różnych źródeł mają różne balanse bieli; wyrównanie ich zmniejsza ryzyko dryfu kolorystycznego.
Czego nie wkładać do referencji
Do zestawu nie powinny trafiać zdjęcia z mocno odmiennym oświetleniem, na przykład jedno w świetle studyjnym, drugie w ostrym słońcu. Nie mieszaj też różnych stylizacji postaci, jeśli docelowo ma występować w jednej wersji. Świadomie pomiń kadry, na których twarz jest zasłonięta, zniekształcona perspektywą lub częściowo poza kadrem, o ile nie chcesz, by te cechy zostały odtworzone w animacji.
Workflow krok po kroku: od briefu do gotowej sceny
Poniższy proces sprawdza się zarówno przy krótkich formach reklamowych, jak i przy dłuższych sekwencjach narracyjnych. Kluczowe jest tempo: najpierw weryfikujesz najtańszy element, czyli pojedyncze ujęcie, dopiero potem skalujesz produkcję.
Krok 1 — brief i lista bohaterów
Zanim wygenerujesz cokolwiek, rozpisz scenariusz na ujęcia i przypisz każdemu z nich bohatera, miejsce i typ ruchu kamery. Ten krok wydaje się biurokratyczny, ale oszczędza godziny pracy: ujęcia dzielą się naturalnie na grupy, które można wygenerować z tym samym zestawem referencji.
Krok 2 — klatki kluczowe i plansza postaci
Wygeneruj statyczne klatki kluczowe dla najważniejszych momentów. Jeśli podobają Ci się konkretne ujęcia, zapisz je jako dodatkowe referencje dla kolejnych etapów. W ten sposób powstaje plansza postaci, którą będziesz wykorzystywać w całym projekcie — jeden zbiór plików dla jednego bohatera.
Krok 3 — test na jednym ujęciu
Wybierz najprostsze ujęcie: statyczna kamera, postać w kadrze, łagodny ruch. Wygeneruj kilka wariantów z różnymi wagami referencji. Oceń, czy tożsamość jest stabilna, czy styl pasuje do reszty projektu i czy ruch nie wprowadza artefaktów. Dopiero po akceptacji przechodź dalej.
Krok 4 — rozciągnięcie na całą scenę
Gdy masz sprawdzony zestaw parametrów, generuj ujęcia grupowo. Trzymaj ten sam zestaw referencji i ten sam model bazowy. Nie zmieniaj jednocześnie modelu, wagi referencji i promptu — jeśli wynik się pogorszy, nie będziesz wiedzieć, który element był przyczyną.
Krok 5 — iteracje i montaż
Na końcu porównaj ujęcia obok siebie, najlepiej w kolejności montażowej. Dopiero w sekwencji widać dryf, którego nie zauważysz na pojedynczym kadrze. Zidentyfikuj dwa lub trzy najsłabsze ujęcia i popraw tylko je, zamiast regenerować całość.
Promptowanie przy wielu referencjach
Prompt przy fuzji obrazów nie opisuje bohatera od zera — on opisuje relację między bohaterem a ujęciem. To subtelna, ale kluczowa różnica.
Nazywanie ról referencji
Jeśli narzędzie na to pozwala, przypisz referencjom role: twarz, strój, styl, tło. Wtedy prompt może się do nich odwoływać bez powtarzania cech wyglądu. Zamiast wypisywać kolor oczu i kształt nosa, opisujesz akcję, kadr i światło, a wygląd pozostaje w gestii referencji.
Słowa sterujące powtarzalnością
Pomocne okazują się sformułowania wskazujące na ciągłość: ta sama postać, identyczna fryzura, niezmieniony strój, spójne oświetlenie, ten sam obiektyw. Warto też precyzyjnie określać plan i ogniskową, na przykład zbliżenie 85 mm albo szeroki plan 24 mm — parametry kamery stabilizują proporcje twarzy między ujęciami.
Czego unikać w promptach
Nie powtarzaj w promptcie szczegółowego opisu wyglądu, jeśli dostarczyłeś referencje. Dwa źródła prawdy prowadzą do konfliktu i model zaczyna improwizować. Unikaj też sprzecznych wskazówek dotyczących światła oraz nadmiaru przymiotników oceniających (piękny, idealny, hiperrealistyczny), które nie wnoszą informacji technicznej, a zwiększają wariancję wyników.
Jak dobrać model i narzędzie do zadania
Nie ma jednego najlepszego modelu do wszystkich zadań związanych ze spójnością. Różne rodziny modeli mają różne predyspozycje i warto dobierać je do konkretnego etapu pracy.
Modele do realistycznej tożsamości
Modele z rodziny Flux oraz nowsze wersje Runway Gen dobrze radzą sobie z utrzymaniem realistycznej twarzy i drobnych detali skóry. Sprawdzają się w materiałach, w których bohater występuje w zbliżeniach i musi być rozpoznawalny. Częściej jednak wymagają staranniejszego zestawu referencji i bywają wrażliwe na zmiany oświetlenia między ujęciami.
Modele do stylizacji i ruchu
Kling i PixVerse często wygrywają tam, gdzie liczy się dynamika i wyrazisty styl — sceny akcji, ujęcia z ruchem kamery, materiały o bardziej ilustracyjnej estetyce. Ich przewaga w ruchu bywa okupiona mniejszą wiernością detali twarzy, dlatego dobrze działają w połączeniu z realistycznymi klatkami kluczowymi.
Modele multimodalne do złożonych scen
Narzędzia takie jak Vidu czy modele z rodziny Hunyuan lepiej radzą sobie z wieloma obiektami w kadrze, interakcjami i złożoną kompozycją. Jeśli scena zawiera dwie postacie, pojazd i tłum w tle, warto rozważyć właśnie tę grupę, pamiętając, że przy większej liczbie referencji rośnie ryzyko uśredniania cech.
Podejście hybrydowe
W praktyce najstabilniejsze pipeline'y są hybrydowe: jeden model generuje klatki kluczowe o wysokiej wierności, drugi animuje je z zachowaniem ruchu, a trzeci odpowiada za wybrane ujęcia stylizowane. Ważne, by w obrębie jednej sceny nie mieszać zbyt wielu modeli — każda zmiana silnika to potencjalne źródło dryfu wyglądu.
Kontrola jakości: checklista dla każdego ujęcia
Zanim uznasz ujęcie za gotowe, przejrzyj je pod kątem kilku powtarzalnych kryteriów. Konsekwencja w tej kontroli jest tym, co odróżnia amatorski montaż od profesjonalnej sekwencji.
- Tożsamość — czy twarz zachowuje kształt, proporcje i charakterystyczne detale z zestawu referencyjnego?
- Strój — czy materiał, kolor i krój ubioru nie zmieniły się między ujęciami?
- Oświetlenie — czy kierunek światła i temperatura barwowa są zgodne z sąsiednimi kadrami?
- Ruch — czy nie pojawiają się drgania, rozmycia lub przeskoki w obrębie jednego ujęcia?
- Tło — czy elementy otoczenia nie zmieniają położenia w sposób, który łamie logikę sceny?
- Dłonie i detale — czy palce, biżuteria i drobne rekwizyty są poprawne anatomicznie?
Najskuteczniejszy test to odtworzenie trzech kolejnych ujęć w pętli bez dźwięku. Oko wychwytuje wtedy niespójności, które umykają przy normalnym odbiorze.
Typowe błędy i sposoby ich naprawy
Dryf tożsamości w dłuższych sekwencjach
Im dłuższa sekwencja, tym większa kumulacja drobnych odchyleń. Rozwiązaniem jest dzielenie materiału na bloki po kilka ujęć i regenerowanie każdego bloku z tym samym, sprawdzonym zestawem referencji, zamiast rozciągania jednego przebiegu na całość.
Uśrednianie twarzy
Gdy referencje różnią się między sobą, model tworzy kompromisową twarz, która nie przypomina żadnego ze zdjęć. Pomaga redukcja zestawu do najbardziej spójnych kadrów oraz zwiększenie wagi jednej, wzorcowej referencji.
Dryf stylu
Zmiana palety barw w połowie sceny najczęściej wynika z mieszania ujęć wygenerowanych różnymi modelami albo z niekonsekwentnych opisów światła. Ujednolicenie promptów i silnika zwykle rozwiązuje problem.
Rozjazd kompozycji
Model potrafi przesunąć bohatera w kadrze, jeśli prompt nie określa planu i pozycji. Precyzyjne wskazanie kadrowania i kierunku patrzenia stabilizuje kompozycję.
Migotanie tekstury
Drobne drgania faktury skóry czy tkanin to zwykle efekt zbyt wysokiej wagi referencji przy słabym prompcie ruchu. Delikatne obniżenie wagi i dopisanie opisu ruchu zwykle wygładza rezultat.
Optymalizacja czasu pracy i liczby iteracji
Największym kosztem w produkcji opartej na generowaniu wideo nie jest samo generowanie, lecz liczba poprawek. Kilka nawyków znacząco skraca cykl:
- Testuj na krótkich klipach. Najpierw dwu-, trzysekundowe próby, dopiero potem pełne ujęcia.
- Zamrażaj parametry. Gdy znalazłeś działający zestaw, zapisz go i nie modyfikuj bez powodu.
- Grupuj podobne ujęcia. Generowanie serii o zbliżonym oświetleniu i planie zmniejsza wariancję.
- Pracuj na niższej rozdzielczości na etapie prób. Ostateczne renderowanie zostaw na koniec.
- Prowadź dziennik parametrów. Notuj model, wagę referencji i wersję promptu dla każdego zaakceptowanego ujęcia.
Te pozornie drobne nawyki przekładają się na przewidywalność całego projektu i pozwalają planować pracę w rytmie produkcji, a nie eksperymentu.
Przykładowy projekt: 45-sekundowy materiał z jedną bohaterką
Zobaczmy, jak wygląda pełny przebieg pracy na konkretnym przykładzie. Załóżmy, że potrzebujesz krótkiego materiału reklamowego: jedna bohaterka, trzy miejsca, sześć ujęć, stała identyfikacja wizualna.
Zaczynasz od planszy postaci — cztery zdjęcia kobiety w zbliżeniu i półpostaci, w neutralnym świetle, na jednolitym tle. Osobno przygotowujesz trzy kadry nastrojowe dla poszczególnych lokalizacji. Kolejnym krokiem jest wygenerowanie klatek kluczowych: bohaterka w biurze, w kawiarni i na ulicy. Każda klatka przechodzi kontrolę tożsamości jeszcze przed animacją.
Dopiero po akceptacji statycznych kadrów uruchamiasz animację. Ujęcia generujesz blokami po dwa, zachowując ten sam zestaw referencji i identyczne ustawienia kamery w obrębie jednej lokalizacji. Po zmontowaniu wersji roboczej oceniasz sekwencję w całości i poprawiasz tylko te ujęcia, w których widoczny jest dryf. Cały proces kończy się ujednoliceniem kolorów i drobną korekcją tempa montażu.
Taki tryb pracy ma jedną zasadniczą zaletę: problemy wychwytujesz na etapie, gdy ich naprawa jest tania, a nie po wygenerowaniu wszystkich ujęć.
FAQ: najczęstsze pytania o spójne animacje
Czy fuzja wielu obrazów działa z jedną referencją? Tak, ale rezultaty są mniej stabilne. Jedno zdjęcie nie pokazuje, jak postać wygląda z innych kątów, więc model musi zgadywać. Trzy do sześciu referencji znacząco poprawia wierność.
Dlaczego twarz zmienia się między ujęciami, mimo tych samych zdjęć? Najczęściej dlatego, że zmienił się prompt ruchu, kadr lub model. Tożsamość jest warunkowana referencjami, ale reszta ujęcia wpływa na końcowy obraz. Utrzymuj stałe parametry w obrębie sceny.
Czy warto używać zdjęć wygenerowanych wcześniej przez AI? Można, o ile są ostre i spójne. Uważaj jednak na kumulację artefaktów — kolejne generacje mogą je wzmacniać i prowadzić do stopniowego odchodzenia od pierwotnego wyglądu.
Jak długie ujęcia są realistyczne do uzyskania? W praktyce najstabilniejsze są klipy od trzech do ośmiu sekund. Dłuższe sekwencje lepiej składać z krótszych fragmentów niż generować w jednym przebiegu.
Co robić, gdy bohater ma wystąpić z drugą postacią? Przygotuj osobne zestawy referencji dla każdej osoby i jasno rozdziel role w prompcie. Przy dwóch postaciach warto też uprościć tło, aby model nie mylił cech bohaterów.
Czy stylizacja całkowicie blokuje spójność? Nie, ale wymaga innego podejścia. W stylach ilustracyjnych tożsamość jest zdefiniowana mniejszą liczbą cech, więc wystarczy zwykle mniej referencji, za to bardziej konsekwentnych stylistycznie.
Od czego zacząć, jeśli dopiero testuję tę technikę? Wybierz jedno ujęcie, jedną postać i jeden model. Dopiero gdy uzyskasz stabilny wynik, rozszerzaj projekt o kolejne kadry i lokalizacje.
