
Consistência de Personagem com IA: Como Manter a Identidade Visual em Vídeos
Aug 4, 2026
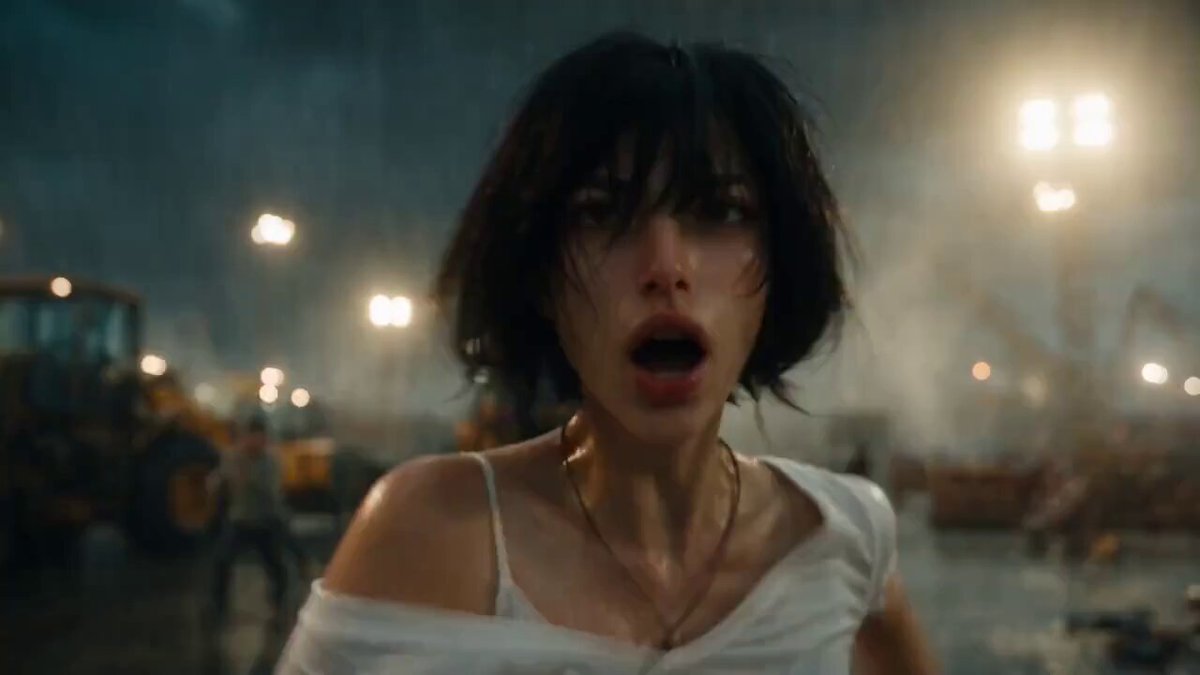
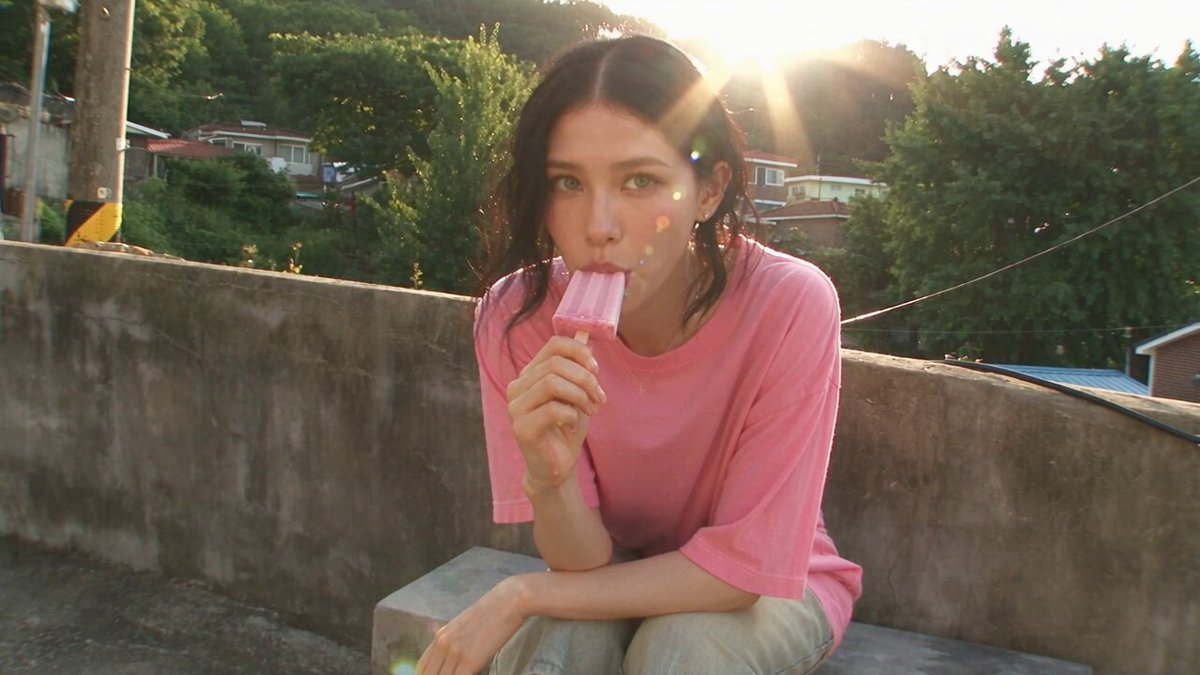
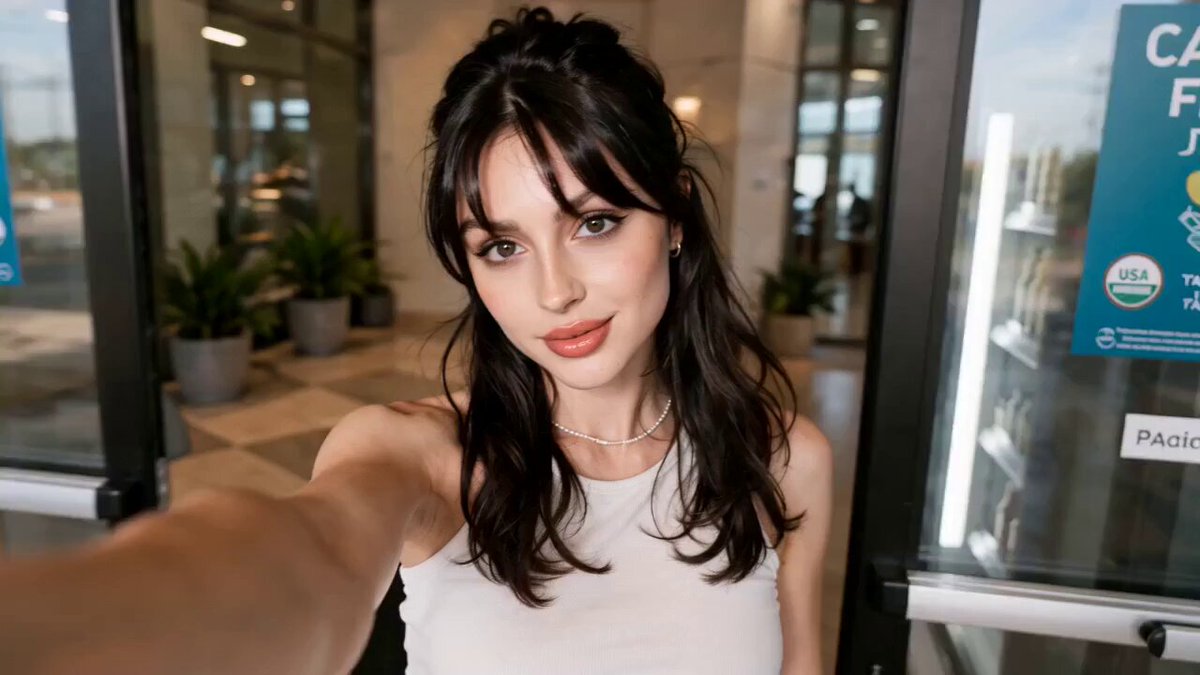
O maior desafio da animação com IA
A inconsistência de personagens sempre foi o calcanhar de Aquiles da geração de vídeo por IA. Você cria um personagem incrível na primeira cena, mas na segunda ele parece outra pessoa. Para criadores que querem contar histórias, isso é um obstáculo enorme.
Felizmente, 2025 trouxe soluções definitivas para este problema. A tecnologia de fusão de imagens e o controle por keyframes mudaram completamente o jogo, permitindo que personagens mantenham sua identidade visual cena após cena.
Por que os personagens mudam?
O problema é técnico: modelos de IA generativa não têm "memória" entre gerações. Cada prompt é processado independentemente, e pequenas variações na interpretação resultam em mudanças visuais. Para resolver isso, precisamos dar à IA referências concretas.
A solução: referências visuais ancoradas
Método 1 — Imagens de referência: Forneça 1-7 imagens do seu personagem em diferentes ângulos. A IA usará essas imagens como guia para manter consistência.
Método 2 — Prompt-DNA: Crie uma descrição ultra-detalhada que sirva como "DNA" do personagem. Inclua medidas específicas, proporções e características únicas que não deixem margem para interpretação.
Método 3 — Seed locking: Algumas ferramentas permitem travar o seed de geração, garantindo que o mesmo "ponto de partida" seja usado.
Ferramentas para o trabalho
Domer implementa essas técnicas de forma integrada. Com GPT Image 2, você pode gerar as imagens de referência do seu personagem em poses variadas, criando um "kit de identidade" completo.
Passo a passo prático
- Crie o design base: Use o gerador de imagens IA para criar a aparência definitiva do personagem.
- Gere variações: Crie 3-5 imagens do mesmo personagem em diferentes ângulos e expressões.
- Monte o kit de referência: Organize todas as imagens como um arquivo de referência para a IA.
- Produza as cenas: Use as referências em cada geração para garantir consistência total.
- Verifique e ajuste: Compare cada cena com o design base e refine se necessário.
A consistência de personagem não é mais um luxo — é o padrão mínimo para conteúdo profissional. Domine essa técnica e suas produções darão um salto de qualidade.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.