
未来已来:探秘Kling、Sora等前沿AI视频模型的最新进展
AI视频生成技术正在从实验室演示快速走向日常生产工具。从基础的文本转视频,到能够生成数分钟级别、具有复杂物理交互和高保真叙事的专业级作品,这一领域在短短几年内完成了巨大的飞跃。本文梳理2025年最受瞩目的AI视频模型进展,并给出创作者实际使用这些能力的方法。
核心技术突破:从生成画面到理解世界
Sora与Kling:东西方顶尖模型的范式比较
OpenAI的Sora以对物理世界规律的深度理解和长时间、高分辨率视频的生成能力著称。它的时空注意力机制能有效跨越时间帧保持对象身份和环境光照的连贯性,显著减少了传统模型中常见的闪烁和形变问题,这对需要连续场景叙事的商业短片至关重要。
快手Kling则在中文语境和特定风格把握上表现出色,尤其在提示词的精准响应和文化元素的准确再现方面具备竞争力。Kling V2.1 Pro通过更精细的局部调整能力,允许创作者在保持整体一致性的同时,对特定物体的微小动作或表情细节进行精确控制。
实际使用中,聪明的做法不是绑定单一模型,而是组合使用:用擅长宏大场景的模型生成环境镜头,再用擅长细节控制的模型精修角色特写,形成跨模型协同工作流。这也是多模型聚合平台的核心理念。
多参考技术:解决角色一致性的关键
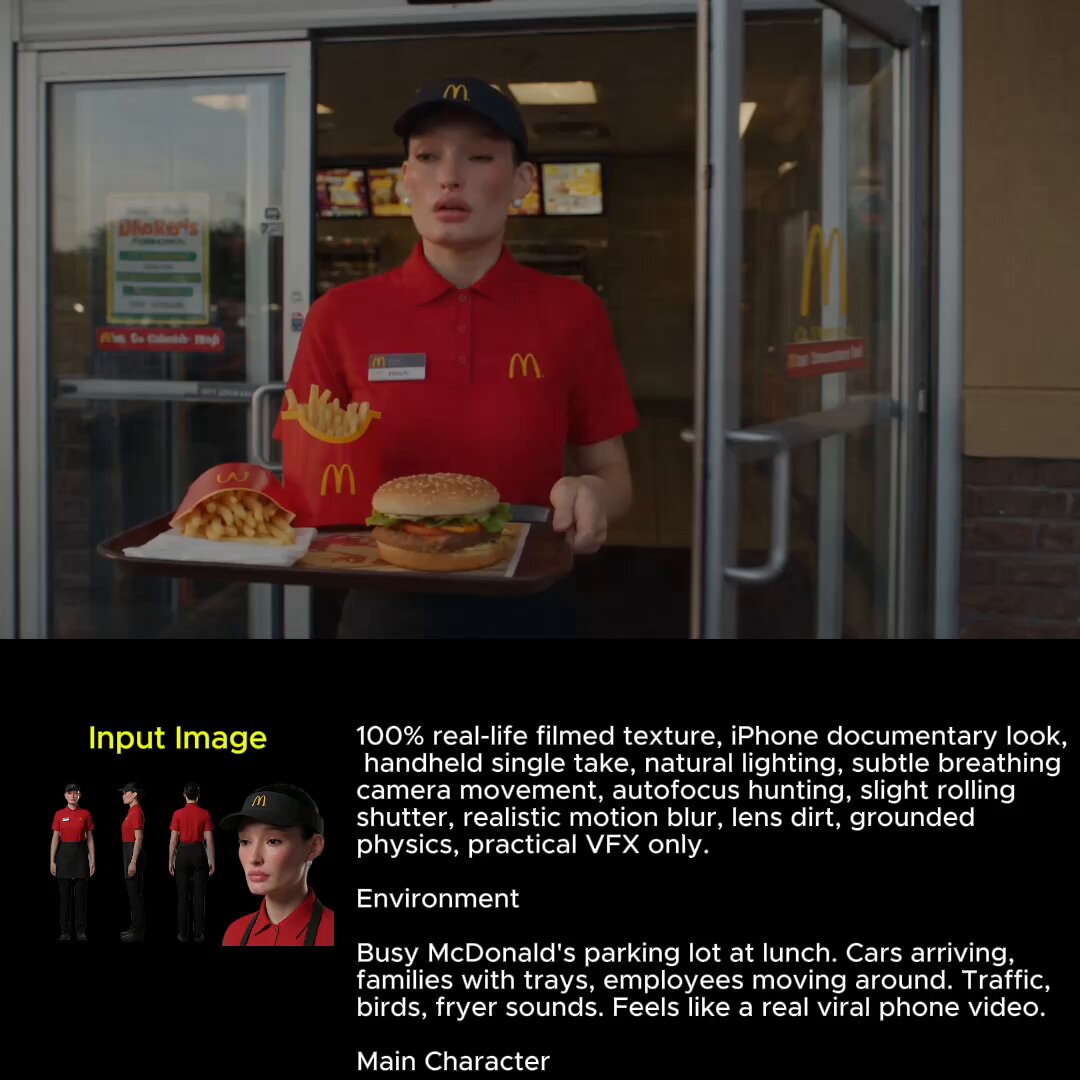
一致性是AI视频从技术演示走向专业生产的关键瓶颈。如果角色在不同镜头中外观不一致,视频便无法用于商业发布。PixVerse V4.5和Vidu Q1在这方面引入了革命性的多参考技术。
多图像参考功能允许用户上传多张角色关键帧,系统会学习并固化角色的面部特征、服装细节,确保在不同动作和灯光下呈现的是同一主体。Vidu Q1 Multi-Reference支持多达7张参考图像,能动态处理风格迁移与角色锁定之间的平衡。对系列化内容制作来说,这称得上里程碑式的进步。
物理真实感与运动流畅度
AI视频生成的终极目标之一是像素级的物理真实感和动作的自然连贯性。Luma Ray 2特别注重光影追踪和物体间自然交互的模拟,其自然连贯的运动和精细的相机运动控制,使其在生成环境镜头时表现卓越。Runway Gen-4则优化了视频到视频的转换,允许创作者以极高的保真度对已有素材进行风格迁移或动作修正,这对后期特效和修复工作流具有颠覆性价值。
如果你想亲身体验这些技术,可以从AI视频生成工具开始,它把多种生成能力整合在一个工作流里,避免在多个工具之间来回切换。
速度与质量的平衡:成本效益分析
在内容高频输出的背景下,生成成本和速度成为衡量模型实用性的重要指标。面向快速迭代和创意探索的"闪电速度"模型,适合头脑风暴和快速原型设计,尽管其复杂叙事能力略逊于顶级模型。
- 大量背景素材或快速预览脚本:选择性价比高的轻量模型
- 需要物理魅力或复杂细节的关键镜头:投入高端模型
- 品牌视觉识别统一的系列内容:优先保证风格一致性
成本管理的核心是精确计量每个模型的消耗,根据项目需求灵活选择。先想清楚这个镜头的用途,再决定投入多少算力,而不是所有镜头都用最强模型。
叙事精确性与后期控制
首尾帧锁定与时间线精确编辑
传统AI生成往往是一个"黑箱"过程,一旦生成,修改难度极大。新一代模型正在把专业编辑工具的理念引入生成阶段。Alibaba Wan系列的首尾帧锁定功能允许创作者锁定视频的起始和结束帧,系统将确保中间的过渡自然且符合预设的情境变化,极大增强了故事板的落地性。
这种高精度控制使得AI生成的内容可以直接用于专业剪辑流程。创作者不再需要生成数百个片段来挑选可用镜头,而是能直接生成接近最终版本的素材,大幅提高迭代效率。
风格与镜头语言的深度模仿
AI视频模型不仅要生成内容,还要能理解和应用专业的美学规范。Framepack专注于高清帧序列的渲染与打包,确保在高帧率输出时每个单独帧都符合影院级标准,这对需要慢动作回放或逐帧分析的场景至关重要。MAGI-1则擅长捕捉和复现特定艺术家的风格或电影流派的视觉特征,模型蒸馏技术在保持高识别度的同时,有效降低了运行延迟和资源占用。
动态音频集成与声音设计自动化
高质量的视频内容离不开同步的、沉浸式的音轨。新一代视频模型开始探索音频与视频的深度耦合,尝试理解视频的情绪和动作节奏,自动匹配和生成适配的音频元素。
更完整的方案是使用集成了AI语音合成和音乐生成模型的一体化工具,用户可以在不离开视频编辑界面的情况下直接对音效进行调整,避免传统流程中导出视频、导入音频软件、重新渲染的繁琐步骤。
开源模型生态的力量
开源社区对推动AI视频技术普及起到了不可替代的作用。Tencent Hunyuan Video和CogVideoX-5B等模型的开放为定制化和模型训练提供了基础。企业级用户能够基于其核心架构,使用私有数据集进行模型微调,以生成品牌高度一致的视频内容。
对个人创作者来说,开源模型意味着可以基于成熟的基础架构,创造出独家的、高价值的专业模型,实现知识产权的保护与变现。
如何跟上AI视频模型的发展节奏
- 关注头部模型的更新日志和技术报告,理解每次迭代解决了什么问题
- 建立自己的测试基准:用同一段提示词在不同模型上测试,记录效果差异
- 保持跨模型工作流思维:没有完美的单一模型,组合才是常态
- 重视一致性与控制力,它们比单帧画质更能决定专业产出
常见问题
我应该选择哪个AI视频模型?
取决于你的场景。需要长篇叙事和物理真实感时优先考虑世界模型能力强的模型;需要文化元素精准再现时选择本土化模型;需要快速迭代时用轻量模型。多数情况下组合使用效果最好。
如何保证角色跨镜头一致?
使用多参考技术:上传多张角色关键帧,并在每个镜头的提示词中重复描述关键特征。先做一两秒的测试片段验证一致性,再生成完整内容。
生成成本太高怎么办?
区分镜头用途:背景、过渡镜头用轻量模型,关键镜头用高端模型。首尾帧锁定也能减少废片率,避免反复生成。
总结
2025年的AI视频模型已经跨越了"能生成"的阶段,进入"可控、一致、高效"的专业生产阶段。理解每个模型的技术特长、学会跨模型协同、重视一致性与后期控制,是创作者驾驭这场技术浪潮的关键。技术迭代很快,但方法论是通用的:明确目标、组合工具、小步验证、持续迭代。
如果你想亲自尝试这些工具,可以从 AI Image Generator 和 Text to Video 开始
