
Tạo Hình Ảnh Nhất Quán Cho Nhân Vật AI: Kỹ Thuật Ghép Ảnh Đa Chiều
Aug 3, 2026
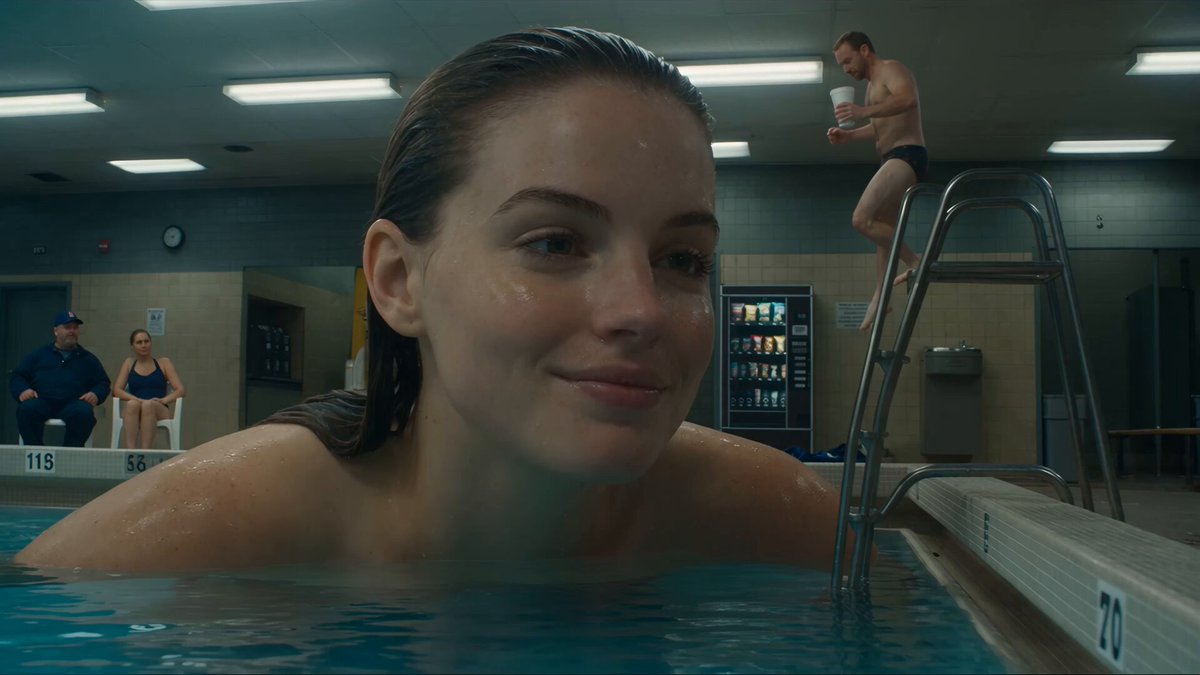
Bài Toán Nhân Vật AI: Tại Sao Lại Khó?
Nếu bạn từng tạo video AI với nhân vật, bạn biết vấn đề: nhân vật của bạn ở cảnh 1 có mái tóc nâu, mắt xanh, nhưng đến cảnh 2 tóc chuyển sang đen, mắt thành nâu. Đây không phải lỗi của bạn — đó là bản chất của các mô hình AI hiện tại: mỗi lần tạo là một lần "vẽ lại từ đầu", không có bộ nhớ về lần tạo trước.
Kỹ thuật Multi-Image Fusion (ghép ảnh đa chiều) ra đời để giải quyết chính xác vấn đề này. Thay vì mô tả nhân vật bằng văn bản mỗi lần (dễ sai lệch), bạn cung cấp nhiều ảnh tham chiếu, và AI học "DNA hình ảnh" của nhân vật — đảm bảo nhất quán qua mọi lần tạo. AI Image Generator là nơi tốt để tạo ảnh tham chiếu chất lượng.
Multi-Image Fusion Hoạt Động Như Thế Nào?
Nguyên Lý Cơ Bản
Bạn cung cấp 3-7 ảnh của cùng một nhân vật từ các góc độ, ánh sáng và biểu cảm khác nhau. Hệ thống AI phân tích tất cả, trích xuất các đặc điểm chung nhất quán (cấu trúc khuôn mặt, màu da, màu tóc, tỷ lệ cơ thể) và tạo ra một "embedding vector" — một mã số đại diện cho nhân vật.
Khi bạn tạo video sau đó, embedding này được đưa vào mọi lần tạo như một điều kiện ràng buộc. Dù bạn dùng mô hình AI nào, tạo cảnh nào, nhân vật của bạn vẫn giữ nguyên đặc điểm cốt lõi.
Tại Sao Cần Nhiều Ảnh?
Một ảnh chỉ cho AI biết nhân vật trông như thế nào từ một góc, trong một điều kiện ánh sáng. Khi xoay mặt, thay đổi ánh sáng, AI sẽ "đoán" — và thường đoán sai. Nhiều ảnh từ nhiều góc giúp AI hiểu cấu trúc 3D thực sự của khuôn mặt, không chỉ bề mặt 2D.
Hướng Dẫn Từng Bước
Bước 1: Chuẩn Bị Ảnh Tham Chiếu
Chụp hoặc tạo 5-7 ảnh nhân vật của bạn: chính diện (ánh sáng tự nhiên), góc 3/4 trái và phải, góc nghiêng, biểu cảm khác (cười, nghiêm túc, ngạc nhiên), và điều kiện ánh sáng khác (trong nhà, ngoài trời).
Nguyên tắc: ảnh phải sắc nét (tối thiểu 1024x1024), background đơn giản và đồng nhất, cùng một người/nhân vật, và phong cách nhất quán (đừng trộn ảnh thật với tranh vẽ).
Bước 2: Tạo Embedding
Upload tất cả ảnh vào hệ thống AI. Quá trình xử lý mất vài phút. Kết quả: một embedding ID duy nhất cho nhân vật của bạn. Lưu ID này cẩn thận — đây là "chứng minh thư" của nhân vật.
Bước 3: Sử Dụng Trong Sản Xuất
Mỗi khi tạo video có nhân vật này, thêm embedding ID vào prompt. Bạn không cần mô tả lại ngoại hình nữa — chỉ cần mô tả hành động, bối cảnh, cảm xúc. AI sẽ tự động áp dụng diện mạo nhất quán.
Bước 4: Kiểm Tra và Tinh Chỉnh
Tạo một vài cảnh test với embedding. Kiểm tra: khuôn mặt có nhất quán không? Màu tóc có giữ nguyên? Tỷ lệ cơ thể có ổn định? Nếu có sai lệch, điều chỉnh bằng cách thêm ảnh tham chiếu vào những góc/yếu tố bị lệch.
Mẹo Nâng Cao
Kết Hợp Với Keyframe Control
Embedding giữ diện mạo nhất quán, nhưng để kiểm soát tư thế và chuyển động, bạn cần keyframe control. Kết hợp cả hai: embedding cho diện mạo + keyframe cho chuyển động = nhân vật nhất quán di chuyển theo ý muốn. Seedance 2.0 hỗ trợ cả hai tính năng.
Quản Lý Thư Viện Nhân Vật
Khi có nhiều dự án, bạn sẽ có hàng chục embedding. Tổ chức thư viện: đặt tên rõ ràng (tên nhân vật + phiên bản + ngày tạo), lưu ý ảnh tham chiếu nào tạo ra embedding, và ghi chú model AI nào hoạt động tốt nhất với embedding này.
Style Consistency Ngoài Nhân Vật
Nguyên lý tương tự áp dụng cho style nhất quán. Tạo embedding cho: bảng màu thương hiệu, phong cách hình ảnh (cyberpunk, watercolor, noir), loại ánh sáng đặc trưng. Bất cứ yếu tố thị giác nào bạn muốn lặp lại.
Lỗi Thường Gặp và Cách Khắc Phục
Lỗi: Nhân vật vẫn thay đổi nhẹ giữa các cảnh. Khắc phục: Thêm ảnh tham chiếu ở góc độ bị lỗi, hoặc tăng weight của embedding trong prompt.
Lỗi: Embedding quá cứng nhắc, nhân vật không thể hiện cảm xúc. Khắc phục: Thêm ảnh tham chiếu với biểu cảm đa dạng hơn, hoặc giảm nhẹ weight embedding.
Lỗi: Mất chi tiết khi zoom cận mặt. Khắc phục: Đảm bảo có ảnh tham chiếu close-up chất lượng cao.
Tại Sao Kỹ Thuật Này Quan Trọng
Trong kỷ nguyên nội dung AI, nhất quán là yếu tố phân biệt chuyên nghiệp với nghiệp dư. Khán giả không khoan dung với nhân vật thay đổi liên tục. Multi-Image Fusion không phải tính năng phụ — nó là nền tảng cho mọi dự án video AI có nhân vật. GPT Image 2 và AI Video Generator giúp bạn bắt đầu hành trình này.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.