
Spójne Postaci w Wideo AI: Technika Multi-Image Fusion Krok po Kroku
Aug 4, 2026
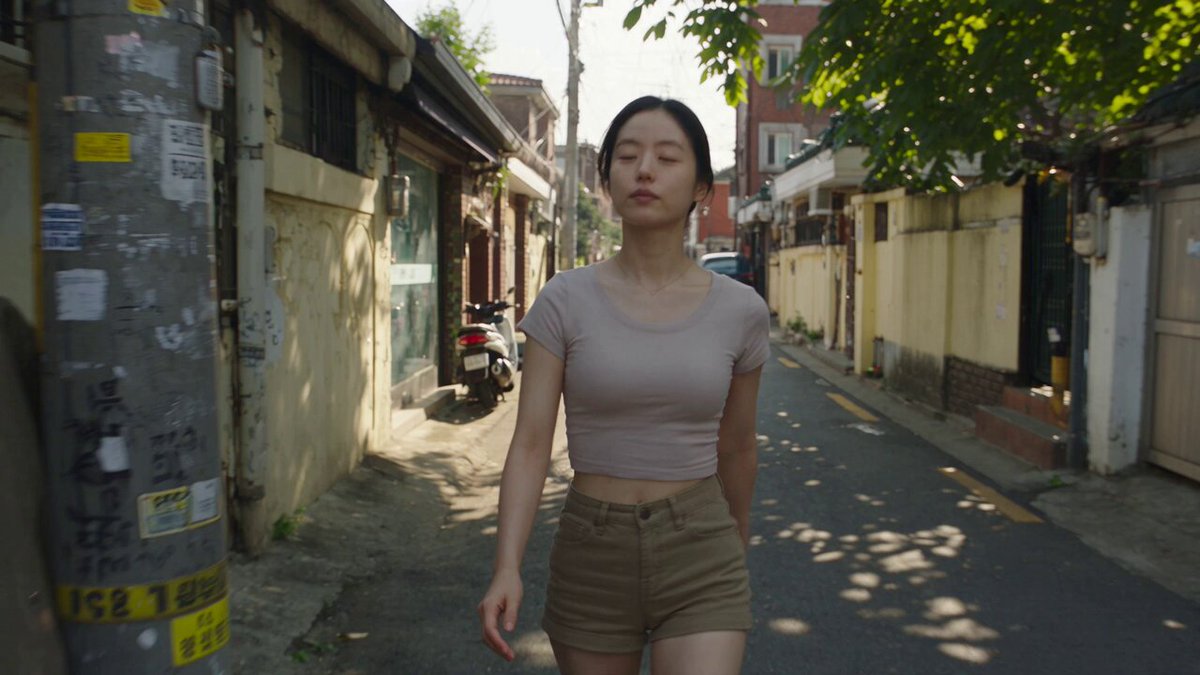
Dlaczego spójność postaci ma kluczowe znaczenie
Generujesz scenę — postać wygląda świetnie. Generujesz drugą scenę — ta sama postać, ale... coś jest nie tak. Inny kształt twarzy, inne oczy, inna fryzura. To frustrujący problem każdego twórcy korzystającego z AI.
Spójność postaci to nie tylko kwestia estetyki. To fundament wiarygodności opowieści. Kiedy widz zauważa, że postać zmienia wygląd między scenami, traci zaufanie do całej narracji.
Czym jest Multi-Image Fusion
Multi-Image Fusion to zaawansowana technika, która rozwiązuje problem niespójności. Polega na dostarczeniu AI kilku obrazów referencyjnych tej samej postaci — z różnych kątów, w różnym oświetleniu, z różnymi wyrazami twarzy. AI uczy się w ten sposób, jak postać naprawdę wygląda, i odtwarza ją wiernie w nowych scenach.
Jak to zrobić w praktyce
Krok 1: Stwórz zestaw referencyjny
Minimum 3-5 obrazów tej samej postaci:
- Widok z przodu (en face)
- Profil (bok)
- Ujęcie 3/4
- Różne wyrazy twarzy (neutralny, uśmiech, zaskoczenie)
Użyj Domer AI Image Generator do stworzenia wysokiej jakości obrazów referencyjnych. Im lepsza jakość, tym lepsze rezultaty.
Krok 2: Trenuj AI na swoich obrazach
Prześlij obrazy do Domer AI Video Generator. System przeanalizuje charakterystyczne cechy twarzy, proporcje i detale.
Krok 3: Generuj nowe sceny
Podczas tworzenia kolejnych scen, wskazuj, że mają używać "twojej" postaci. AI zachowa jej wygląd, nawet gdy zmienisz tło, oświetlenie czy kąt kamery.
Krok 4: Iteruj i udoskonalaj
Jeśli rezultat nie jest idealny, dodaj więcej obrazów referencyjnych lub doprecyzuj prompty. GPT Image 2 świetnie radzi sobie z utrzymywaniem szczegółów.
Najlepsze praktyki
- Obrazy referencyjne powinny mieć tę samą rozdzielczość i podobne oświetlenie
- Unikaj obrazów, gdzie twarz jest częściowo zasłonięta
- Używaj różnorodnych ujęć — im więcej kątów AI zobaczy, tym lepiej zrozumie trójwymiarową strukturę twarzy
- Testuj na krótkich sekwencjach przed długimi projektami
Częste błędy
- Za mało obrazów referencyjnych (minimum to 3, lepiej 5-7)
- Obrazy referencyjne różniące się stylem (np. jedno zdjęcie realistyczne, drugie kreskówkowe)
- Zbyt skomplikowana fryzura lub dodatki, które AI trudno odtworzyć
- Ignorowanie tła — jeśli wszystkie obrazy referencyjne mają podobne tło, AI może je błędnie skojarzyć z postacią
Zastosowania
- Seriale animowane i web series
- Reklamy z markową maskotką
- Materiały edukacyjne z wirtualnym prowadzącym
- Treści na social media z powtarzalną postacią
Podsumowanie
Multi-Image Fusion eliminuje największą bolączkę twórców AI — niespójność postaci. Dzięki tej technice możesz budować światy i historie, w których postacie pozostają sobą od pierwszej do ostatniej sceny. Zacznij od Domer AI i przekonaj się, jak płynna może być narracja AI.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.