
تثبيت الشخصيات في الفيديو بالذكاء الاصطناعي: تقنيات الدمج المتقدم للصور
Aug 4, 2026
المشكلة التي تواجه كل صانع محتوى
تبدأ بفكرة رائعة لمسلسل فيديو. تصنع المشهد الأول — الشخصية الرئيسية تبدو مذهلة. تنتقل للمشهد الثاني — الوجه تغير قليلاً. المشهد الثالث — الملابس اختلفت. وعند المشهد الرابع، لم يعد المشاهد يتعرف على بطلك.
هذه هي مشكلة انجراف الهوية (Identity Drift)، وهي التحدي الأكبر في إنتاج الفيديو بالذكاء الاصطناعي. لكن الحل موجود: تقنية دمج الصور المتعددة.
ما هي تقنية دمج الصور المتعددة؟
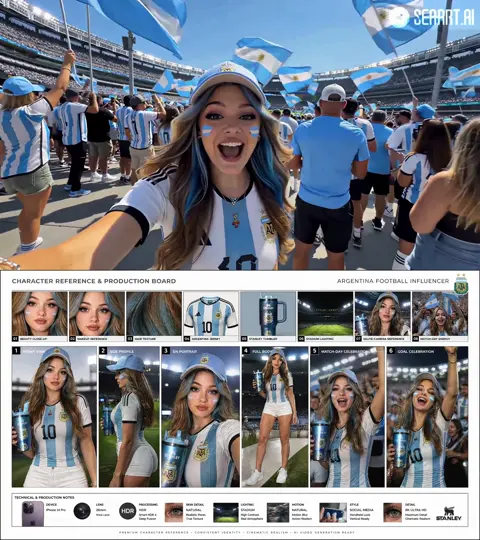
باختصار، هي طريقة لتعليم الذكاء الاصطناعي الشكل الدقيق لشخصيتك باستخدام عدة صور مرجعية. بدلاً من الاعتماد على وصف نصي واحد، تقوم بتزويده بـ 5-7 صور للشخصية من زوايا مختلفة. النتيجة: الذكاء الاصطناعي يبني بصمة رقمية للشخصية يستخدمها في كل مرة يولد فيها مشهداً جديداً.
كيف تطبق هذه التقنية
الخطوة 1: إعداد الصور المرجعية
اجمع 5-7 صور للشخصية: 3 زوايا مختلفة للوجه، 3 تعابير وجه مختلفة، صورتان على الأقل بإضاءة مختلفة. استخدم مولد الصور بالذكاء الاصطناعي لإنشاء صور مرجعية عالية الجودة.
الخطوة 2: تحديد الصورة الرئيسية
اختر صورة واحدة لتكون المرجع الرئيسي (Master Reference). هذه الصورة هي المعيار الذهبي الذي ستقارن به كل مشهد جديد.
الخطوة 3: كتابة الأوامر النصية بذكاء
لكل مشهد جديد، استخدم قالباً ثابتاً: وصف الشخصية من المرجع الرئيسي (ثابت لا يتغير) + الحركة المطلوبة + البيئة + زاوية الكاميرا.
الخطوة 4: الفحص الدقيق
قارن كل مشهد جديد بالمرجع الرئيسي. ركز على: العينين، الأنف، شكل الفك، تفاصيل الشعر.
لماذا هذا مهم لعملك؟
- للعلامات التجارية: الثبات البصري يبني الثقة
- لصناع المسلسلات: كل حلقة متماسكة بصرياً
- لمنصات التواصل: الاستمرارية تبني قاعدة جماهيرية
أخطاء شائعة وتصحيحها
- تغير الوجه بين المشاهد: استخدم 7 صور مرجعية على الأقل
- اختلاف ألوان الملابس: اذكر الألوان صراحة في النص
- تشوه الملامح في الحركة: أضف "حركة بطيئة وطبيعية"
تمرين عملي (30 دقيقة)
- اختر شخصية واحدة
- اصنع 7 صور مرجعية بزوايا وتعابير مختلفة مع GPT Image 2
- اختر الصورة الرئيسية
- اصنع 3 مشاهد اختبارية
- قارن النتائج وسجل ملاحظاتك
النماذج الجديدة مثل Seedance 2.0 تدمج تقنيات الثبات في صميمها. استكشف جميع أدوات Domer للذكاء الاصطناعي وابدأ رحلتك نحو فيديوهات احترافية.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.