
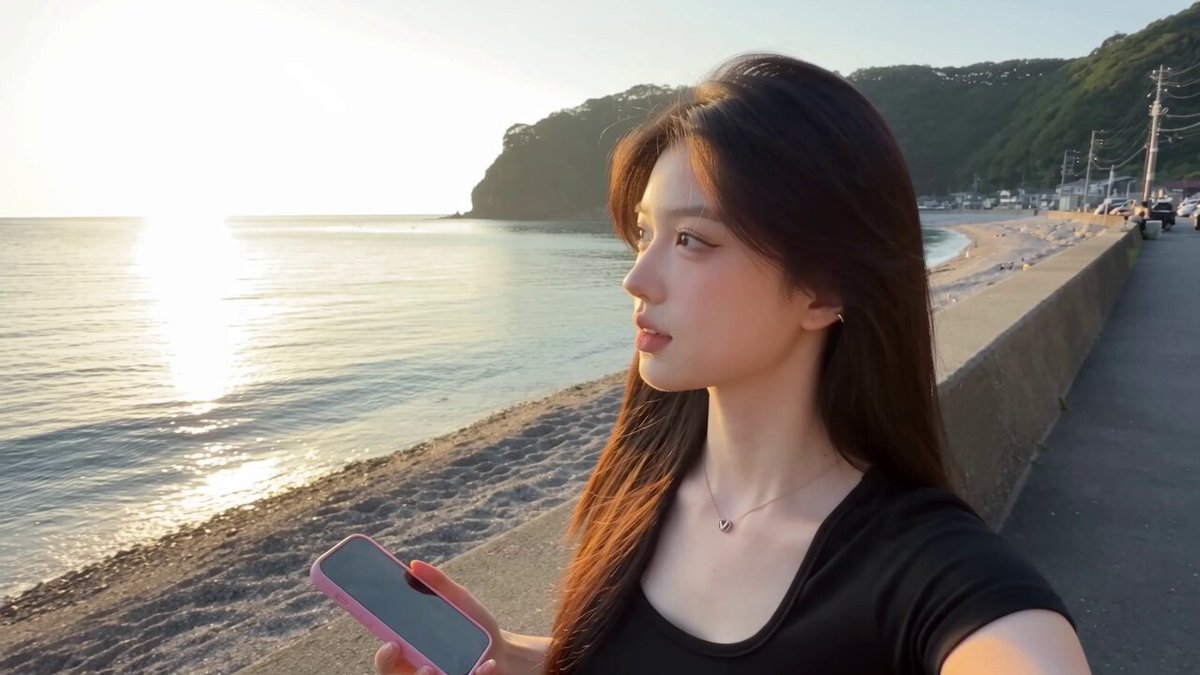
Von Fotos zu Bewegung: Image-to-Video mit modernster KI-Technologie
Aug 4, 2026
Die Fähigkeit, aus einem einzigen Foto ein bewegtes Video zu erstellen, gehört zu den beeindruckendsten Fortschritten der generativen KI. Was früher aufwendige Animationstechniken und teure Software erforderte, ist heute mit wenigen Klicks möglich.
Wie funktioniert Image-to-Video?
Moderne Image-to-Video-Systeme arbeiten mit Diffusionsmodellen, die um zeitliche Aufmerksamkeitsmechanismen erweitert wurden. Das Ausgangsbild wird in einen komprimierten latenten Raum überführt, wo Bewegungsvektoren berechnet werden, die natürliche Übergänge zwischen den Einzelbildern erzeugen.
Der entscheidende Unterschied zur reinen Bildgenerierung liegt in der zeitlichen Kohärenz: Die KI muss verstehen, wie sich Objekte über mehrere Frames hinweg physikalisch korrekt verhalten. Eine Hand, die sich hebt, muss in jedem Frame die gleiche Anatomie, Textur und Beleuchtung aufweisen.
Wenn Sie selbst mit KI-gestützter Bilderstellung experimentieren möchten, bietet der Domer AI Image Generator einen hervorragenden Einstiegspunkt für hochwertige Ausgangsbilder, die Sie anschließend in Bewegung versetzen können.
Die wichtigsten Technologien im Überblick
Diffusionsmodelle und temporale Verarbeitung
Das Fundament bilden Latent Diffusion Models (LDMs), die Bilddaten schrittweise entrauschen. Für Videos wird dieser Prozess um eine zeitliche Dimension erweitert: Anstatt jeden Frame unabhängig zu verarbeiten, koordiniert das Modell den Entrauschungsvorgang über die gesamte Zeitachse, um flackernde Übergänge zu vermeiden.
Kamera- und Bewegungskontrolle
Moderne Systeme interpretieren nicht nur das Motiv, sondern auch Kamerabewegungen. Prompt-Anweisungen wie "Kamera fährt langsam zurück" oder "Nahaufnahme mit leichtem Schweben" werden direkt in cinematische Parameter übersetzt. Einige Plattformen bieten sogar explizite Objektivsteuerungen für Tiefenschärfe und Brennweite.
Konsistenz über längere Sequenzen
Die größte Herausforderung bleibt die Charakterkonsistenz: Ein Gesicht, das in Sekunde 1 lächelt, sollte in Sekunde 5 identisch aussehen. Fortschrittliche Multi-Reference-Techniken lösen dies, indem sie mehrere Referenzbilder desselben Motivs als Ankerpunkte nutzen.
Für anspruchsvolle Video-Generierung mit Charakterkonsistenz empfehlen wir einen Blick auf den Domer AI Video Generator, der speziell für kohärente Bewegtbildsequenzen optimiert ist.
Praktische Anwendungsbereiche
Marketing und Werbung
Marketingteams können aus einem einzigen Produktfoto Dutzende dynamischer Anzeigenvarianten generieren. Ein statisches Kampagnenbild wird zur Grundlage für kurze Videospots, die auf verschiedene Plattformen und Zielgruppen zugeschnitten sind. Die Zeitersparnis gegenüber traditionellen Videoproduktionen ist erheblich.
Content Creation und Social Media
Für Creator, die regelmäßig frischen Content benötigen, ist Image-to-Video ein Gamechanger. Ein gut komponiertes Bild kann innerhalb von Minuten in einen ansprechenden Kurzclip für TikTok, Instagram Reels oder YouTube Shorts verwandelt werden.
Spieleentwicklung und Asset-Erstellung
In der Spieleindustrie beschleunigt die Technologie die Erstellung von Charakteranimationen und Umgebungseffekten. Ein statisches Konzeptbild kann sofort in eine Laufanimation oder eine Umgebungsbewegung umgesetzt werden.
Modelle und ihre Stärken
Verschiedene KI-Modelle haben unterschiedliche Spezialisierungen:
- Fotorealistische Szenen: Einige Modelle sind auf höchste Bildtreue und natürliche Texturwiedergabe optimiert – ideal für Produktvisualisierungen und Architekturdarstellungen.
- Stilisierte Animationen: Andere Modelle glänzen bei künstlerischen und animierten Stilen, von Anime bis Comic.
- Schnelle Iterationen: Leichtere Modellvarianten ermöglichen schnelles Prototyping und A/B-Testing verschiedener Bewegungsstile.
Wer fotorealistische Resultate anstrebt, findet mit leistungsfähigen Modellen wie GPT Image 2 auf Domer eine starke Basis für Ausgangsbilder, die dann in Bewegung umgesetzt werden können.
Tipps für optimale Ergebnisse
- Bildqualität ist entscheidend: Je hochwertiger und schärfer das Ausgangsbild, desto besser das Bewegungsergebnis.
- Klare Prompts formulieren: Beschreiben Sie die gewünschte Bewegung präzise – "sanftes Schweben" erzeugt andere Resultate als "hektisches Wackeln".
- Einfache Hintergründe wählen: Komplexe Hintergründe können zu Artefakten in der Bewegung führen.
- Mehrere Referenzbilder nutzen: Wenn möglich, liefern Sie dem Modell 2-3 Ansichten desselben Motivs für bessere Konsistenz.
- Iterativ arbeiten: Betrachten Sie die erste Generation als Ausgangspunkt und verfeinern Sie durch angepasste Prompts.
Grenzen und Herausforderungen
Trotz beeindruckender Fortschritte gibt es Einschränkungen: Sehr lange Videosequenzen (über 10 Sekunden) können an Kohärenz verlieren. Schnelle, komplexe Bewegungen führen häufiger zu Artefakten. Und die physikalische Plausibilität – etwa wie ein Stoff fällt oder Wasser spritzt – ist noch nicht in allen Fällen perfekt.
Die Technologie entwickelt sich jedoch rasant weiter. Wer heute mit Seedance 2.0 auf Domer arbeitet, profitiert bereits von deutlichen Verbesserungen in Bewegungsdynamik und Szenenkohärenz.
Häufig gestellte Fragen
Kann ich jedes beliebige Foto in ein Video verwandeln?
Grundsätzlich ja, aber die Qualität des Ergebnisses hängt stark von Bildschärfe, Komposition und Motiv ab. Porträts und klare Objektaufnahmen funktionieren am besten.
Wie lang können die generierten Videos sein?
Aktuell sind 3-8 Sekunden realistisch bei hoher Qualität. Längere Sequenzen erfordern oft das Aneinanderfügen mehrerer Clips.
Brauche ich technische Vorkenntnisse?
Nein, moderne Plattformen bieten intuitive Benutzeroberflächen. Grundlegendes Verständnis von Bildkomposition hilft jedoch bei den Prompts.
Kann ich die Ergebnisse kommerziell nutzen?
Das hängt von der jeweiligen Plattform und deren Lizenzbedingungen ab. Prüfen Sie die Nutzungsrechte vor kommerziellem Einsatz.
Fazit
Image-to-Video ist keine Zukunftsmusik mehr, sondern ein produktiv einsetzbares Werkzeug. Die Technologie demokratisiert die Videoproduktion und ermöglicht es Einzelpersonen und kleinen Teams, Bewegtbildinhalte zu erstellen, die früher nur mit großem Budget realisierbar waren. Der Schlüssel zum Erfolg liegt in der Kombination aus hochwertigen Ausgangsbildern, präzisen Anweisungen und dem richtigen Modell für die jeweilige Aufgabe.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.