
静止画のAI生成はここ数年で飛躍的な進化を遂げ、写真のような画像を数秒で作れるようになりました。しかし、その先にある「動画生成」となると、もうひとつの壁が立ちはだかります。それが「キャラクターの一貫性」です。同じ人物やオブジェクトが、別のシーンやカットに登場した瞬間、顔つきや服装が変わってしまう──。この問題を解決する鍵として注目されているのが、複数のAI画像を融合させる「マルチイメージ融合」という手法です。
本記事では、AI画像から高品質な動画を生成するためのマルチイメージ融合の仕組みと、実際の制作ワークフローへの組み込み方を解説します。DomerのAI画像生成で作成した静止画を、AI動画生成に活かしたい方に向けて、具体的な手順とポイントをまとめました。
なぜ複数画像の融合が動画の品質を左右するのか
テキストだけでは再現できない「見た目」の固定
従来のテキスト・トゥ・ビデオでは、プロンプトの記述が少し変わるだけでキャラクターの顔や衣装が変わってしまう「ドリフト」が頻発していました。「黒髪の女性」と指定しても、ショットごとに髪型や目の色が微妙にずれてしまうのです。これは、テキストだけでは情報が不足するためです。
そこで使われるのが、参照画像です。複数のアングル・表情・照明条件の画像をAIモデルに入力すると、モデルはキャラクター固有の「ID情報」を抽出します。このID情報が動画全体で共有されることで、シーンが変わっても顔立ちや衣装、質感が安定します。Domerのimage-to-video機能を使えば、このID情報を維持したまま、静止画に自然な動きを与えることが可能です。
マルチイメージ融合の3つの要素
マルチイメージ融合は、次の3つの要素から成り立ちます。
- ID埋め込みの分離: キャラクターの顔や服といった永続的な特徴と、ポーズや背景といった一時的な要素を分離して抽出します。
- 時間的コヒーレンスの確保: 動画のフレーム間で、動き・照明・影の変化が自然に連続するようにします。
- 参照画像の重み付け: 複数の参照画像のうち、どの画像を重視するかを調整します。たとえば「表情」を固定したいなら、その表情の画像に高い重みを与えます。
この3つを適切にコントロールすることで、単なるスライドショーではなく、物語性のある高品質な映像シーケンスが生まれます。特に時間的コヒーレンスは、カメラが動いたときの背景の流れや、キャラクターが歩くときの影のつき方にも影響するため、映像全体の自然さを左右する重要な要素です。
高品質な動画を生成するための実践ワークフロー
ステップ1: 参照画像セットを準備する
まず、キャラクターの「決定的なルック」を定義する画像を複数枚用意します。理想的なのは、正面・横顔・表情違い・全身・服装のディテールが分かる画像の組み合わせです。それぞれの画像が互いに矛盾しないよう、照明の方向や画質を揃えておくことが重要です。
DomerのAI画像生成でキャラクターを作る場合は、同じプロンプトのシード値からバリエーションを生成すると、参照画像間の統一感を保ちやすくなります。また、GPT Image 2のような高精細なモデルを使って生成した画像は、動画化した際のディテール再現性が高い傾向にあります。
ステップ2: モデルを選択し、融合パラメータを調整する
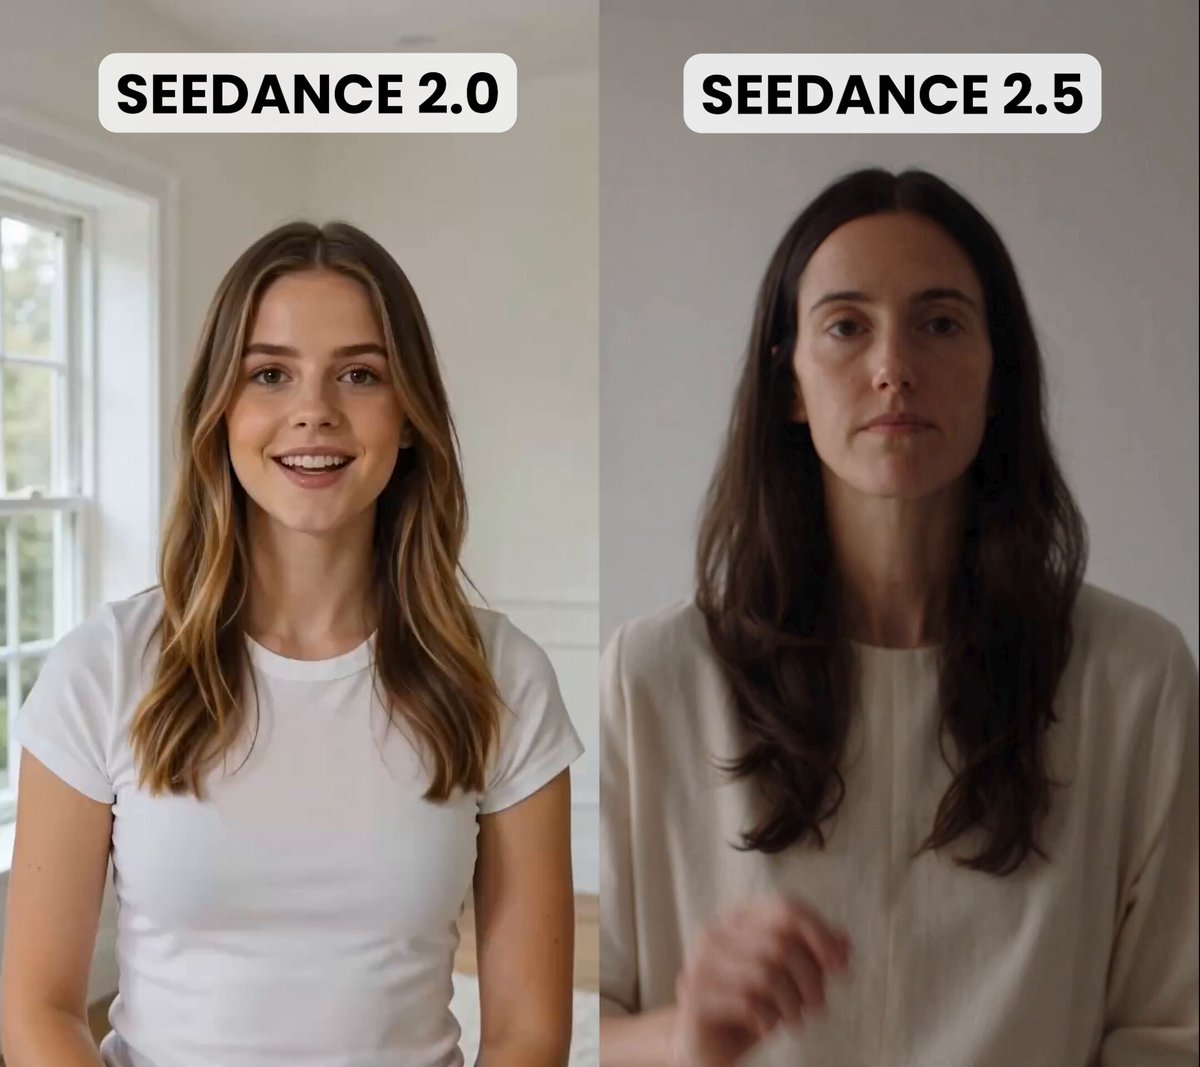
参照画像が揃ったら、動画生成モデルを選択します。Domerでは、Seedance 2.0やKling 3.0など、シーン理解に優れたモデルを利用できます。これらのモデルは、複数の参照画像を同時に扱うことができ、キャラクターの一貫性を保ちながらカメラワークや動きを生成できます。
重み付けの調整では、以下のような戦略が有効です。
- 顔を固定したい場合: 顔のクローズアップ画像に高い重みを設定する
- 衣装を固定したい場合: 全身のテクスチャが分かる画像を参照フレームの中心に置く
- 背景を活かしたい場合: 背景の参照情報は重みを下げ、キャラクターIDの抽出に集中する
また、参照画像に写り込んだ照明の角度がバラバラだと、動画内の影の落ち方も不安定になります。参照画像を撮影する段階で、ライティングの方向を統一しておくと、後から調整する手間が大幅に減ります。
ステップ3: 生成結果を評価しフィードバックする
生成後は、ランダムにフレームを抽出して参照画像と比較しましょう。顔立ちや服のディテールにズレがないかを確認し、問題があれば参照画像の組み合わせや重み付けを変更して再生成します。このフィードバックループを繰り返すことで、動画の品質は劇的に向上します。
特に注目したいのは、キャラクターが動きながら振り返るシーンや、カメラが寄るシーンです。こうした動きの大きいカットでは、輪郭や髪の毛の処理が不安定になりやすいため、複数回のチェックが必要になります。
マルチイメージ融合の活用シーン
ブランド動画と広告
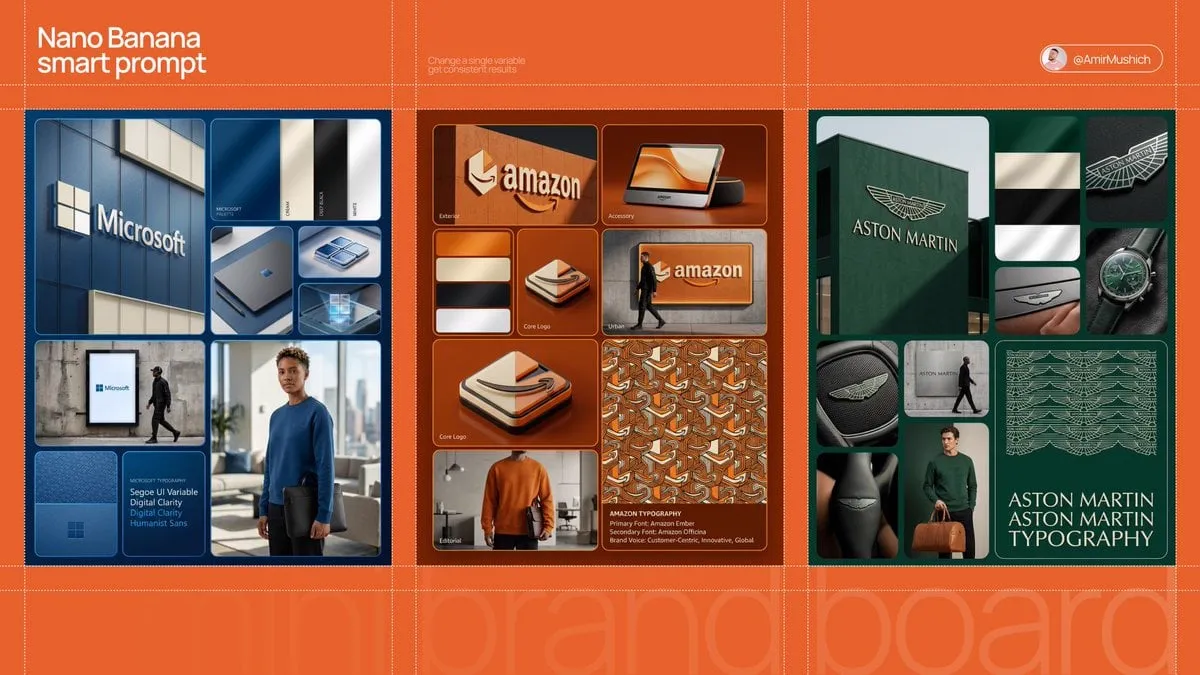
広告キャンペーンでは、製品のロゴやパッケージ、ブランドキャラクターが全カットで同じ見た目であることが求められます。マルチイメージ融合を使えば、製品写真を参照画像として指定し、プロモーション動画全体でそのデザインを維持できます。特に、商品の色味や質感を正確に伝えたいECサイトの動画や、ブランドの世界観を統一したいSNS広告との相性がよいです。
アニメーションとセルルック
アニメーション制作では、線画の太さや塗りのスタイルがキャラクターごとにブレないことが重要です。キャラクター設定資料(キャラクターシート)を複数枚アップロードすることで、動きのあるシーンでも絵柄が安定します。Domerのtext-to-videoなどと組み合わせれば、企画段階からアニメーションのルックを検証することも可能です。
さらに、アニメーション背景の美術設定を参照画像に含めることで、キャラクターと背景の光の方向を揃えることもできます。背景とキャラクターを別々に生成するのではなく、同じライティング情報を共有するのがポイントです。
VFXと特殊効果
複雑なVFXショットでは、小道具やエフェクトの軌跡を安定させる必要があります。火花や煙、水しぶきといった時間変化するエフェクトを、キャラクターやオブジェクトに追従させる際にも、融合されたID情報が役立ちます。金属やガラスなど反射の強い素材では、シーンごとに映り込みが変化しても、参照画像の質感情報をもとに、物理的に自然な反射を保つことができます。
まとめ:AI画像から動画へ、一貫性こそが次のステージ
AI画像生成の技術はすでに十分に成熟しています。次のステージは、その静止画に「時間」と「物語」を加えることです。マルチイメージ融合は、単に複数の画像を1本の動画にまとめる技術ではありません。キャラクターのアイデンティティを守りながら、高品質な映像体験を作り出すための、いわば「翻訳機」のような存在です。
まずは手元にあるAI画像を、DomerのAI動画生成に入力してみてください。参照画像の組み合わせを少し変えるだけで、映像のクオリティが大きく変わることを実感できるはずです。今後の映像制作において、この一貫性を操るスキルは、クリエイターにとって欠かせない武器になるでしょう。
