
作成
Görüntüden Videoya Dönüşümde Tutarlılık: Çoklu Görüntü Füzyon Teknolojisi
Aug 3, 2026
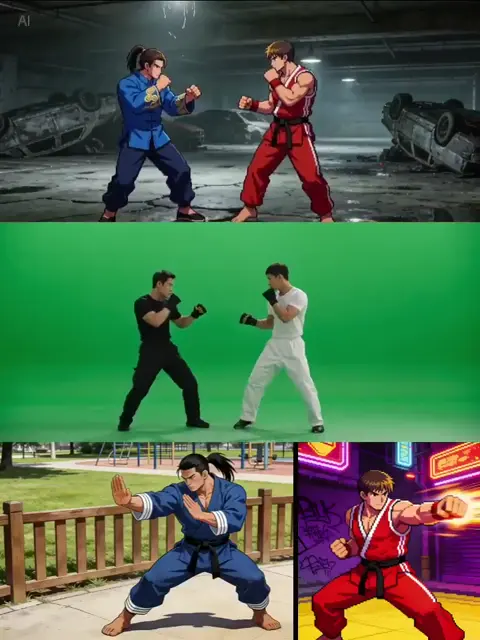
Tutarlılık: AI Video Üretiminin Kutsal Kasesi
Görüntüden videoya dönüşümün en büyük sorunu tutarlılıktır. Bir karakterin bir sahnede yeşil ceket giyerken, sonraki sahnede aynı görünmesi — bu, uzun süredir AI'nın aşamadığı bir engeldi. Kullanıcıların %70'i AI videolarda en çok karakter tutarlılığı konusunda hayal kırıklığı yaşıyor.
Çoklu Görüntü Füzyonu Nedir?
Çoklu görüntü füzyonu, birden fazla referans görüntüsünü (farklı açılar, farklı ifadeler) analiz ederek ortak bir "kimlik vektörü" oluşturur. Bu vektör, tüm video karelerine enjekte edilir ve karakterin temel görsel DNA'sı korunur.
Nasıl Çalışır?
Referans Görüntüleri
AI image generator ile karakterinizin önden, profilden ve üç-çeyrek açıdan görüntülerini oluşturun. Ne kadar çok referans, o kadar iyi tutarlılık.
Füzyon Algoritması
Sistem, görüntülerdeki ortak özellikleri — yüz şekli, ten rengi, kıyafet detayları — çıkarır ve birleştirir. Sonuç: hangi sahnede olursa olsun aynı görünen bir karakter.
Çapraz Model Tutarlılığı
En etkileyici özellik: farklı AI modelleri arasında bile tutarlılık sağlanabilir. Text-to-video ile oluşturulan bir sahne ile image-to-video ile oluşturulan başka bir sahnede karakter aynı kalır.
Profesyonel Kullanım Alanları
Dijital Hikaye Anlatımı
Uzun formatlı içeriklerde karakter tutarlılığı, izleyicinin hikayeye bağlanması için kritiktir. Her sahnede farklı görünen bir karakter, anlatıyı baltalar.
Marka Kampanyaları
Bir reklam kampanyasında aynı karakterin farklı mekanlarda tutarlı görünmesi gerekir. Füzyon teknolojisi, yeniden çekim maliyetlerini ortadan kaldırır.
Eğitim İçerikleri
Eğitim videolarında tutarlı bir sunucu karakteri, profesyonellik ve güven inşa eder.
En İyi Uygulamalar
- Yüksek kaliteli referans görüntüleri kullanın: AI video generator ne kadar iyi referans alırsa, o kadar iyi sonuç verir
- Farklı açılardan görüntü sağlayın: Ön, profil, üç-çeyrek — ne kadar çeşitli, o kadar iyi
- Prompt'ta tutarlılık isteyin: "Önceki sahnedeki karakterin aynısı" gibi ifadeler ekleyin
Premium Çözümler
Profesyonel projeler için:
- GPT Image 2: Referans görüntüler için üstün kalite
- Seedance 2.0: Füzyon destekli video üretimi
Sonuç
Tutarlılık, AI video üretiminde profesyonel ile amatörü ayıran çizgidir. Çoklu görüntü füzyon teknolojisi bu çizgiyi aşmanın en etkili yoludur.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.