
为什么要把静态图片变成视频
短视频平台对动态内容的流量倾斜是显而易见的。同样一组照片,做成幻灯片和做成有运镜、有转场的短片,播放量可能差10倍。
过去做这件事需要专业的视频编辑技能。现在,AI让一切简单了很多。你只需要上传一张或多张图片,选择一个模型,几分钟就能得到一个带动态效果的视频片段。
图像转视频的核心原理
AI图像转视频(Image-to-Video,简称I2V)的工作原理可以简单理解为:模型分析你的静态图片,理解其中的物体、景深和构图,然后「想象」出这张图片之外的可能运动和视角变化。
比如一张人物肖像,AI可以添加自然的眨眼、微表情变化和镜头缓慢推进的效果。一张风景照,AI可以模拟云层流动、水面波纹或镜头平移。
Domer的图像转视频功能就提供这样的能力——上传图片,选择运动强度和风格参数,快速生成动态视频。
实用操作流程
第一步:准备素材
选择清晰、构图完整的图片效果最好。避免过于杂乱或主体不明确的照片。如果你想做一个连贯的故事短片,建议准备3-5张同主题、同风格的照片。
第二步:选择生成模式
大多数AI工具提供几种运动模式:
- 微动模式: 适合人像或产品展示,只有细微的眨眼或镜头微移
- 标准模式: 适度的运镜和物体运动
- 动态模式: 大幅度的镜头运动和场景变化
先用标准模式测试,不满意再调整。
第三步:设置参数并生成
一般需要设置的参数包括运动强度、视频时长(通常5-15秒)、输出分辨率。一次生成不满意很正常,调整图片或参数后重新生成即可。
进阶技巧:多图融合叙事
如果你想让一个角色在不同场景中保持形象一致,可以采用多图融合策略:
- 首先生成一张高质量的角色形象图(可以用Domer的AI图像生成器来创建)
- 再生成同一角色在不同场景、不同服装的变体图
- 逐个将每张图转为短视频片段
- 用剪辑软件拼接,保持角色一致性
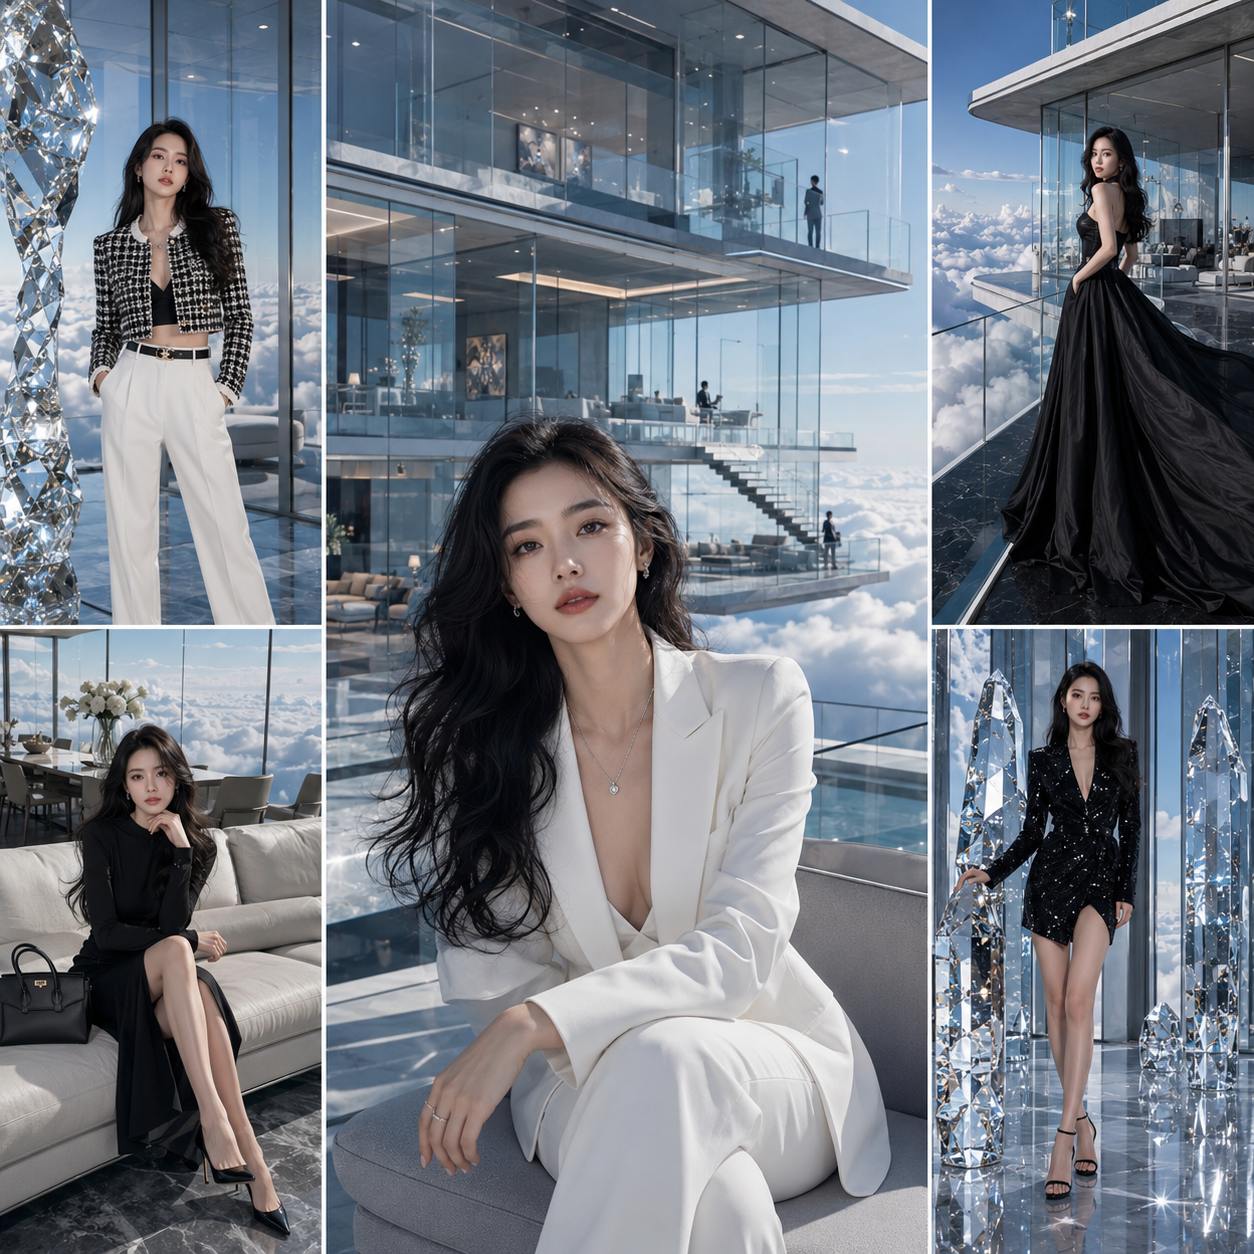
这样就能打造出角色统一的短故事片。市面上像GPT Image 2这样的模型,在角色一致性方面表现相当不错。
常见问题与解决
画面抖动怎么办? 降低运动强度参数,或换一个更稳定的模型。
角色变形了? 这说明当前模型对图片的理解有偏差。换一张构图更简单、主体更清晰的图片试试。
生成速度太慢? 视频生成本身就是高计算量的任务。降低分辨率或缩短时长可以加速。
总结
图像转视频技术已经到了一个好用的阶段。它不能替代专业视频制作,但对于社交媒体内容、产品展示和个人创作来说,已经足够实用了。关键是:先动手试,在反复测试中找到适合你素材的最佳参数组合。
