
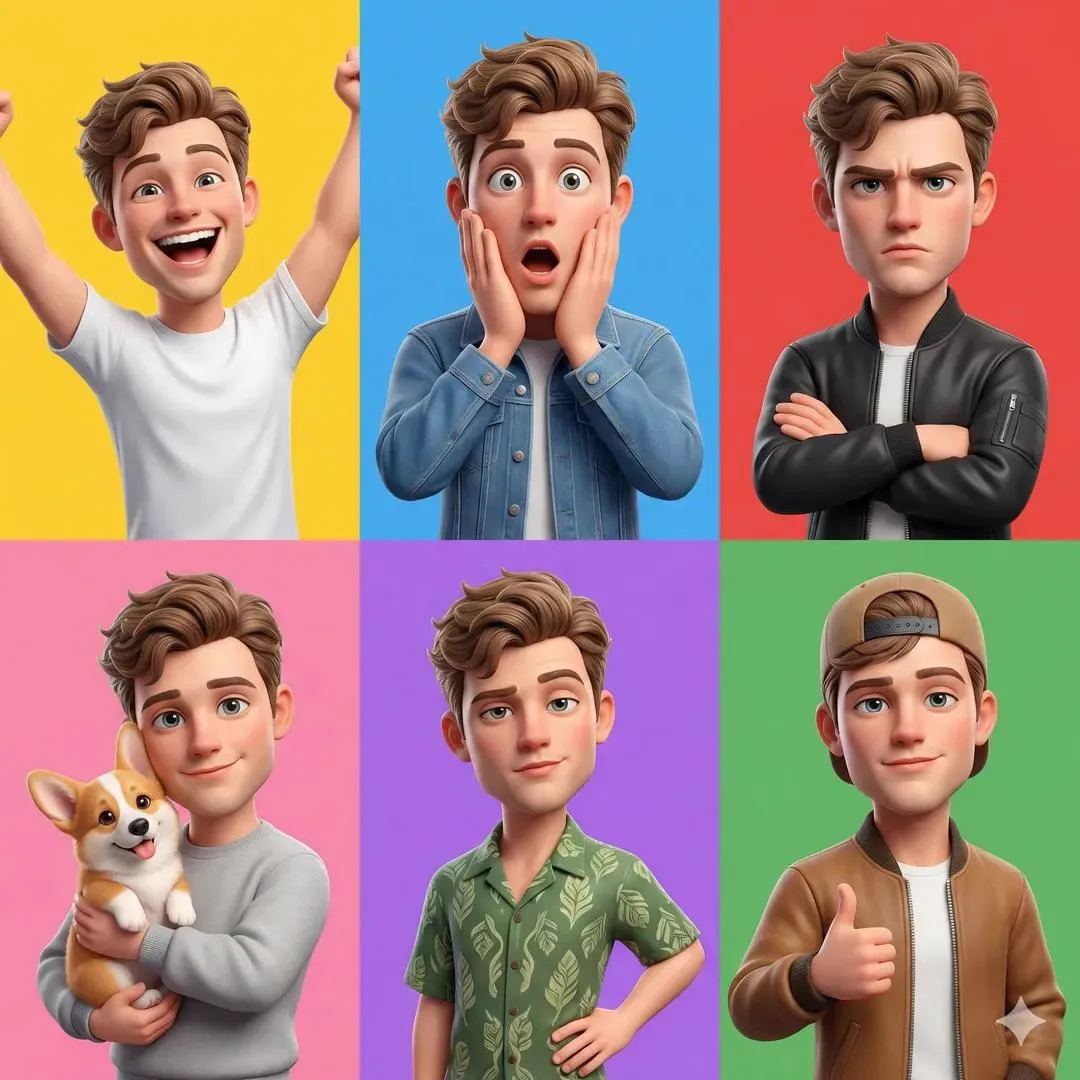
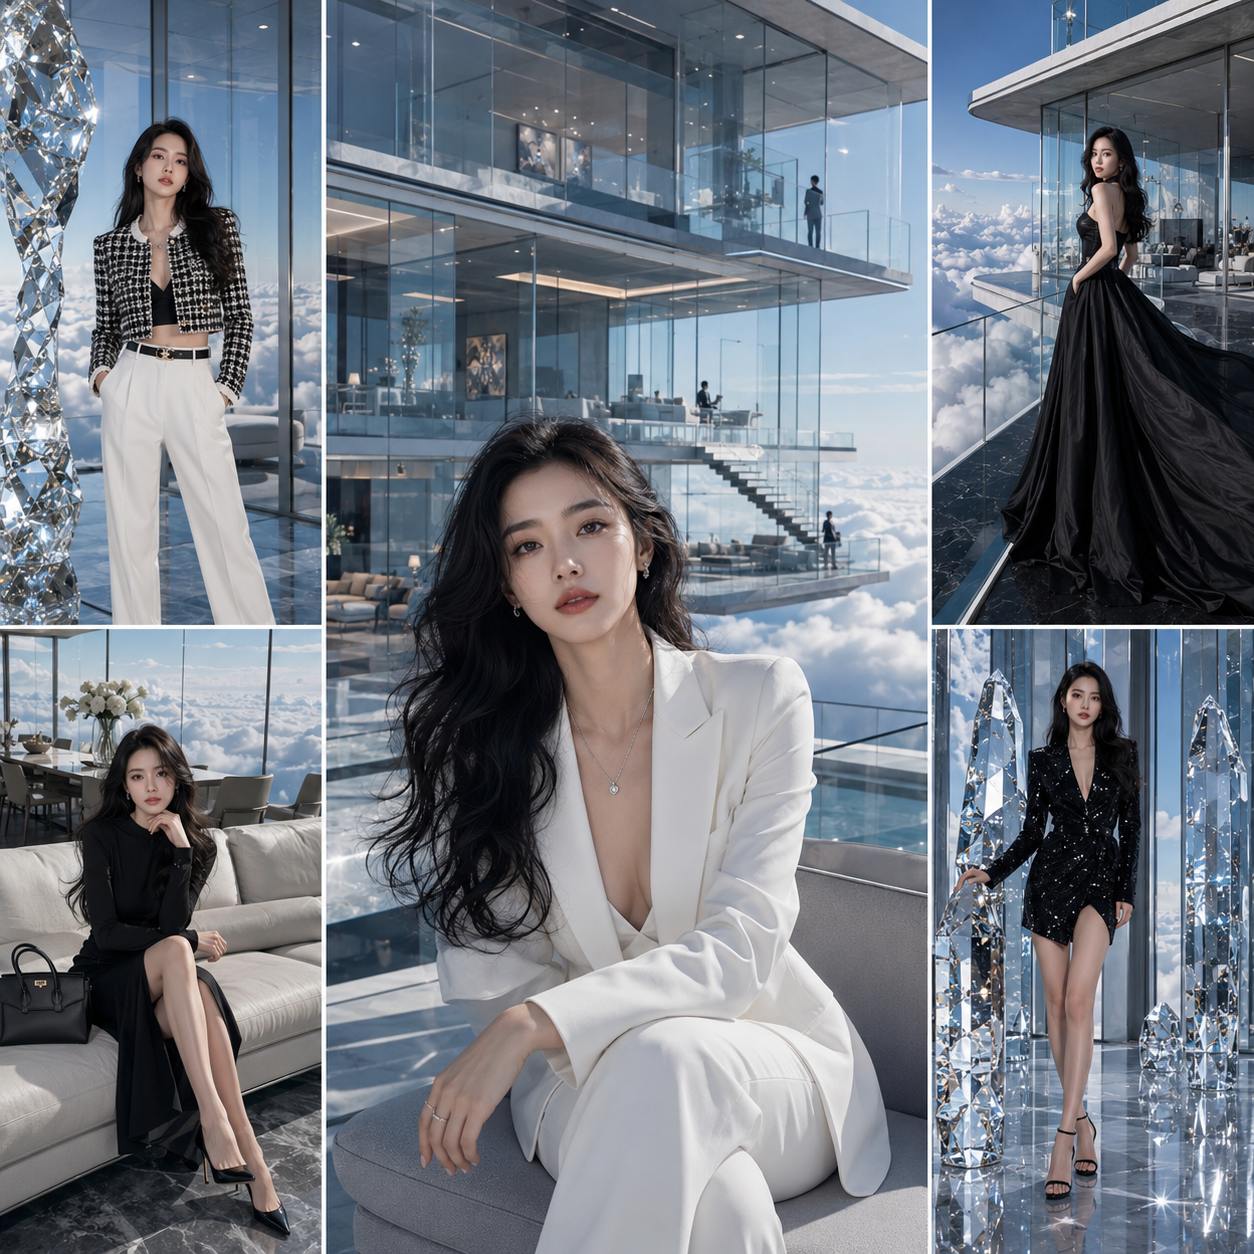
Generowanie wideo z tekstu przestało być jedynie eksperymentem. W 2025 roku twórcy, marketerzy i filmowcy oczekują od modeli AI nie tylko realistycznego ruchu, ale przede wszystkim pełnej spójności wizualnej między kolejnymi ujęciami. To właśnie utrzymanie ciągłości postaci i scenografii przez całą sekwencję stanowi dziś największe wyzwanie i zarazem kluczowy miernik dojrzałości technologii text-to-video.
W tym artykule przyjrzymy się, jak działa fuzja obrazów (image fusion) oraz jakie techniki pozwalają osiągnąć stabilność narracyjną. Omówimy też, dlaczego wybór odpowiedniego modelu i kontrola klatek kluczowych mają fundamentalne znaczenie dla końcowego efektu.
Czym jest fuzja obrazów i dlaczego napędza spójność wideo AI?
Fuzja obrazów w kontekście generowania wideo to proces łączenia danych wizualnych z wielu źródeł – zdjęć referencyjnych, wygenerowanych klatek czy stylów artystycznych – w celu wymuszenia stałych atrybutów wizualnych na sekwencji tworzonej przez model dyfuzyjny. Zamiast polegać wyłącznie na opisie słownym, system analizuje dostarczone obrazy i wyodrębnia z nich wektory cech: kształt twarzy, kolor włosów, charakterystyczne detale ubioru czy fakturę tła. Te wektory są następnie wstrzykiwane do przestrzeni latentnej modelu generującego, dzięki czemu każda kolejna klatka zachowuje kluczowe elementy tożsamości wizualnej.
Rozwiązania dostępne na rynku, takie jak Domer AI image generator czy Domer AI video generator, pokazują, jak duże znaczenie ma precyzyjna kontrola nad referencjami. Dzięki zaawansowanym mechanizmom multi-reference użytkownik może dostarczyć kilka obrazów naraz – jeden dla postaci, drugi dla tła, trzeci dla stylu – a algorytm sam zadba o ich spójne połączenie.
Mechanizmy wymuszania tożsamości postaci
Pierwszym krokiem w budowaniu spójnej narracji jest ekstrakcja wektorów tożsamości. Analizując zestaw referencji, system koduje najważniejsze cechy bohatera: proporcje twarzy, kolor oczu, charakterystyczne znaki, a nawet detale garderoby. Powstały wektor tożsamości staje się punktem odniesienia dla każdego kroku generowania.
Następnie wektor ten jest wstrzykiwany do przestrzeni latentnej modelu wideo. Działa to jak kompas – podczas procesu de-noisingu mechanizmy uwagi nadają wyższą wagę cechom zdefiniowanym przez użytkownika, co zapobiega „dryfowaniu” wyglądu postaci. To kluczowe zwłaszcza przy zmianach kąta kamery czy oświetlenia: twarz musi pozostać rozpoznawalna, nawet jeśli sceneria diametralnie się zmienia.
W praktyce najlepsze efekty daje połączenie fuzji obrazów z uczieniem transferowym. Zamiast zmuszać ogólny model do zapamiętania detali, trenowany jest mały, specjalistyczny model na unikalnym zestawie klatek kluczowych. Taki fine-tuning pozwala uzyskać znacznie wyższą precyzję niż próba sterowania ogólnym modelem samym promptem tekstowym.
Rola agentów reżyserskich w utrzymaniu scenografii
O ile fuzja obrazów dba o spójność postaci, to spójność scenografii i kinematografii wymaga dodatkowego poziomu inteligencji. Tu z pomocą przychodzą agenci reżyserscy AI – automatyczne systemy, które analizują prompt i samodzielnie decydują o ustawieniu kamery, ogniskowej, oświetleniu czy głębi ostrości. Dzięki temu wszystkie ujęcia sekwencji wyglądają, jakby nakręcono je tym samym sprzętem i w tym samym stylu.
Agenci ci prowadzą także tzw. mapę przestrzenną sceny. Jeśli bohater przechodzi z punktu A do punktu B, system pilnuje, aby zmiana perspektywy nie powodowała gwałtownych przeskoków w tle. To niweluje jeden z najczęstszych błędów starszych systemów T2V, gdzie co kilka klatek sceneria zmieniała się niekontrolowanie.
Dobrym przykładem mogą być modele z rodziny Seedance 2.0, które oferują zaawansowaną kontrolę nad strukturą sceny, lub Kling 2.6, znany z naturalnego odwzorowania ruchu. Wybór odpowiedniego modelu ma ogromne znaczenie – jeden lepiej poradzi sobie z fotorealistycznymi postaciami, inny ze stylizowaną animacją. Nowoczesne platformy, takie jak Domer text-to-video, umożliwiają dynamiczne przełączanie między modelami w trakcie produkcji, co pozwala łączyć mocne strony różnych rozwiązań.
Zaawansowane techniki fuzji dla nieprzerwanej narracji
Kontrola klatek kluczowych
Klatki kluczowe to szkielet każdej sekwencji wideo. Zamiast generować całą scenę na podstawie jednego promptu, użytkownik może zdefiniować kilka punktów charakterystycznych – początek, środek i koniec – z precyzyjnie określonymi atrybutami. System interpoluje ruch między nimi, trzymając się zdefiniowanych punktów zakotwiczenia wizualnego.
Nowoczesne modele, takie jak Alibaba Wan Series, są projektowane wokół koncepcji first-last-frame control. Pozwala to uniknąć niepożądanych transformacji obiektów i zapewnia płynne przejścia. Warto też wspomnieć o automatycznych audytach spójności czasowej – jeśli różnice między klatkami przekroczą ustalony próg, zadanie jest automatycznie przesyłane do ponownego renderowania z wyższymi parametrami stabilizacji.
Adaptacja tekstur i oświetlenia w wielu scenach
Spójna narracja wymaga nie tylko powtarzalności postaci, ale także logicznego świata przedstawionego. Jeśli bohater przechodzi z jasnego, słonecznego dnia do ciemnego magazynu, zmiana oświetlenia musi być płynna i motywowana fabularnie. Dlatego platformy separują warstwy generacyjne: moduł fuzji obrazów koncentruje się na postaciach, a osobny mechanizm zarządza środowiskiem.
Użytkownik może zdefiniować wektor stylu środowiska – paletę barw, nasycenie cieni, rodzaj światła. Ten wektor działa równolegle do wektora tożsamości postaci, dzięki czemu zachowanie spójności nie ogranicza kreatywności. Przykładowo, jeśli scenariusz wymaga zachodzącego słońca, system replikuje ten sam typ światła w różnych ujęciach, nawet gdy tło ulega zmianie. Takie podejście stosują chociażby modele GPT Image 2, gdzie precyzyjna kontrola parametrów obrazu przekłada się na lepsze rezultaty w późniejszym montażu.
Wykorzystanie modeli multi-reference
Coraz więcej modeli, takich jak PixVerse V4.5 czy Vidu Q1, wspiera jednoczesne przetwarzanie wielu obrazów referencyjnych. To otwiera nowe możliwości: możemy dostarczyć osobno referencję dla wyglądu bohatera, tła, stylu artystycznego, a nawet wzorca ruchu. System składa te warstwy w jedną spójną sekwencję, minimalizując nieprzewidywalność.
Kluczem jest świadoma selekcja referencji. Jeśli priorytetem jest unikalny kostium, obraz tego kostiumu musi być wyraźny i izolowany. Gdy zależy nam na ruchu, można wykorzystać klip wideo jako referencję dynamiki. Taka wielowarstwowa fuzja jest bardziej obciążająca obliczeniowo, dlatego platformy muszą inteligentnie mapować zadania na odpowiednie modele bazowe. Właśnie tutaj liczy się elastyczność infrastruktury – dobra architektura systemowa potrafi efektywnie zarządzać kolejką zadań i zasobami GPU.
Podsumowanie
Fuzja obrazów to dziś fundament każdego poważnego narzędzia text-to-video. Bez niej generowane sekwencje pozostają jedynie zbiorem efektownych, ale niespójnych klipów. Dopiero połączenie wieloreferencyjnych wektorów tożsamości, kontroli klatek kluczowych i inteligentnych agentów reżyserskich pozwala tworzyć pełnoprawne narracje wizualne.
Niezależnie od tego, czy dopiero zaczynasz przygodę z generatywnym wideo, czy szukasz narzędzi do profesjonalnej produkcji, warto eksperymentować z różnymi modelami i technikami fuzji. Spójność to przewaga, którą odbiorca od razu zauważy – zarówno w marketingu, edukacji, jak i rozrywce. A jeśli chcesz poznać więcej praktycznych aspektów, zajrzyj do naszego bloga lub porównaj dostępne narzędzia w sekcji AI tools.
