
创作
Personaggi Coerenti nei Video con l’IA: Fusioni Multi-Immagine e Flusso di Lavoro
Aug 3, 2026
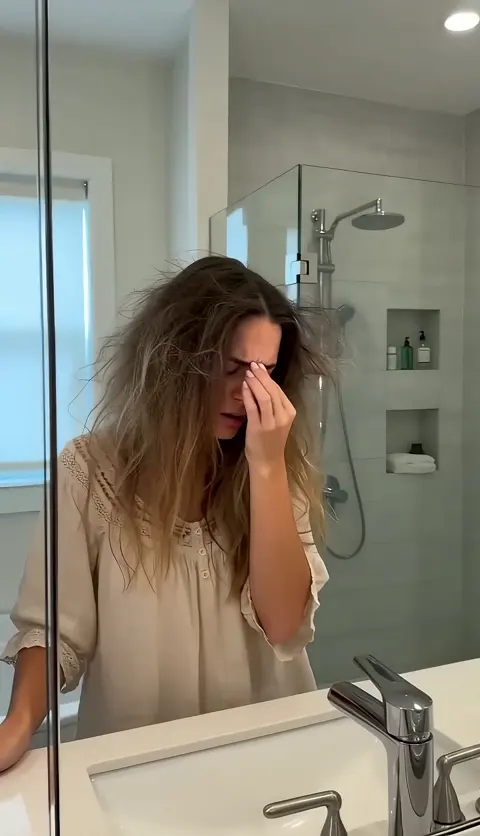
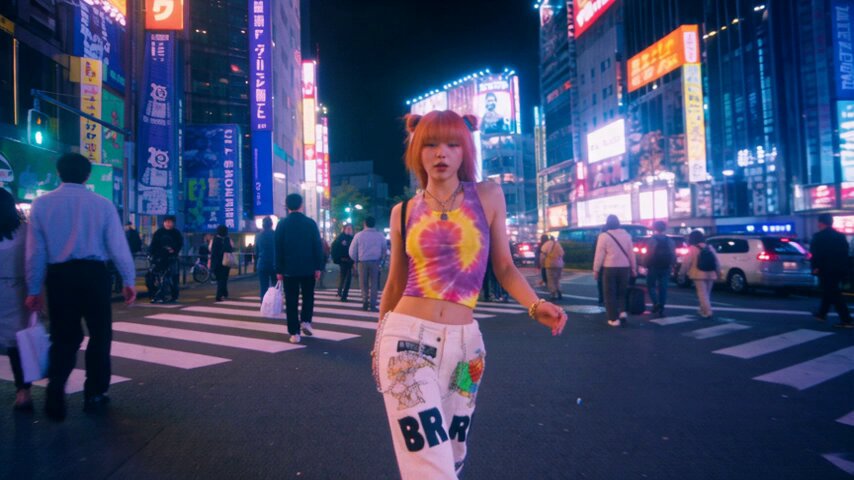
Creare video con l’intelligenza artificiale è diventato sorprendentemente accessibile. Bastano pochi input per ottenere scene spettacolari, atmosfere cinematografiche e movimenti fluidi. Eppure, chi lavora seriamente con la generazione video conosce bene il problema più frustrante: il personaggio che cambia volto, abbigliamento o tratti somatici tra una scena e l’altra. Questa "deriva del personaggio" è il motivo per cui molti contenuti AI sembrano belli solo come singoli fotogrammi, ma falliscono quando devono raccontare una storia continua. La buona notizia è che esistono tecniche e strumenti specifici per risolvere questo limite, e oggi vediamo come usarli al meglio su piattaforme come Domer, che mette a disposizione modelli avanzati per immagini e video.
Il problema della deriva del personaggio
Quando si genera un video con l’IA, ogni scena viene prodotta in modo semi-indipendente dalle altre. Anche se il prompt descrive lo stesso soggetto, il modello può interpretare i dettagli in modo diverso: il colore degli occhi cambia, la giacca perde un bottone, l’acconciatura subisce variazioni sottili ma evidenti. Per produzioni lunghe o serie episodiche, questo diventa un ostacolo enorme. La soluzione non è solo scrivere prompt migliori, ma adottare un approccio di fusione multi-immagine: caricare più riferimenti dello stesso personaggio e usarli come ancora visiva per ogni generazione.
Su Domer puoi combinare questa strategia con un ai-image-generator pensato per mantenere alta fedeltà ai riferimenti. Il sistema non si limita a copiare un’immagine, ma estrae i tratti essenziali del personaggio e li applica in contesti diversi. In questo modo, il volto, i vestiti e lo stile restano riconoscibili anche quando l’ambiente cambia radicalmente.
Come funzionano le fusioni multi-immagine
Il principio è simile a quello che farebbe un character designer: si raccolgono più viste del personaggio — frontale, laterale, in azione, con espressioni diverse — e si chiede al modello di rispettare quelle coordinate visive. Le piattaforme più avanzate permettono di caricare queste immagini come riferimento diretto, senza dover descrivere tutto a parole. È molto più efficace di un prompt testuale: un’immagine vale mille token.
Per ottenere il massimo, puoi usare lo strumento image-to-image per rifinire i frame generati, oppure partire da un’immagine per creare un video con image-to-video. In entrambi i casi, il personaggio mantiene una continuità visiva molto superiore rispetto alla generazione testuale pura. Questa tecnica è particolarmente utile per i cortometraggi, le serie animate e i video con personaggi ricorrenti.
Strumenti e modelli per mantenere l’identità visiva
Non tutti i modelli si comportano allo stesso modo quando si tratta di coerenza. Alcuni eccellono nel fotorealismo, altri nello stile animato, altri ancora nella resa delle texture. La scelta del modello giusto è parte fondamentale del flusso di lavoro. Sulla piattaforma Domer puoi trovare modelli specifici per esigenze diverse, come gpt-image-2 per immagini altamente dettagliate o seedance-2-0 per la generazione video con una buona stabilità temporale.
Se invece lavori con animazioni stilizzate o vuoi un controllo più artistico, vale la pena esplorare anche kling-2-6 e kling-3-0, noti per la resa fluida dei movimenti e la capacità di mantenere il soggetto al centro della scena. Avere più modelli a disposizione non è un lusso: è una necessità. Ogni progetto ha esigenze diverse, e provare e confrontare è il modo migliore per trovare la combinazione vincente.
Flusso di lavoro pratico per personaggi coerenti
Ecco un metodo semplice ma efficace che puoi applicare subito:
- Crea una scheda personaggio. Genera 3-5 immagini del tuo personaggio in pose e luci diverse. Salva quelle che ti convincono di più. Questa sarà la tua reference bank.
- Usa le reference come input. Carica le immagini direttamente nella generazione video o immagine. Su Domer puoi combinare più riferimenti per dare al modello una comprensione completa del soggetto.
- Blocca il prompt di stile. Oltre alle immagini, usa un prompt che descriva l’abbigliamento, i colori e i tratti principali in modo ripetitivo e identico per ogni scena. La coerenza tra prompt e riferimenti è fondamentale.
- Genera e confronta. Non accontentarti del primo risultato. Genera più varianti e confronta i frame. Se qualcosa cambia, modifica le reference o aggiungi una nuova immagine di riferimento per quel dettaglio specifico.
- Rifinisci con l’image-to-image. Se un frame ha un piccolo errore, non rigenerare tutto: usa una trasformazione mirata per correggere solo il dettaglio, mantenendo il resto intatto.
Questo approccio richiede un po’ di organizzazione all’inizio, ma ripaga in termini di qualità e tempo risparmiato nelle fasi successive. Puoi approfondire altre tecniche simili nel blog di Domer, dove vengono pubblicati aggiornamenti e tutorial su come sfruttare al meglio gli strumenti di generazione.
Errori comuni e come evitarli
Il primo errore è usare una sola immagine di riferimento. Un singolo scatto non basta per catturare l’essenza di un personaggio sotto diverse angolazioni. Meglio caricarne almeno tre, anche se non sono perfette.
Il secondo errore è cambiare il prompt tra una scena e l’altra. Anche piccole variazioni di wording possono far deragliare il modello. Crea un blocco di testo fisso da copiare sempre, modificando solo gli elementi che devono davvero cambiare (es. l’azione, l’ambiente).
Il terzo errore è ignorare il modello. Non tutti i modelli sono adatti alla coerenza. Se noti che un modello produce frequenti drift, prova a cambiare modello invece di insistere con parametri sempre più complessi. La piattaforma Domer offre una lista di strumenti e modelli consultabile nella sezione AI tools, utile per orientarsi.
Infine, non dimenticare l’importanza della risoluzione e della qualità delle immagini di riferimento. Immagini piccole, compresse o con filtri pesanti confondono il modello. Usa immagini nitide, ben illuminate e con dettagli chiari.
Prospettive future della coerenza visiva
La tecnologia sta avanzando rapidamente. Sempre più modelli integrano il controllo dei keyframe, ovvero la possibilità di indicare che in un determinato frame il personaggio deve essere in una certa posizione o con una certa espressione. Questo apre la strada a produzioni video molto più complesse, con dialoghi, interazioni e inquadrature multiple.
Strumenti come il text-to-video e il text-to-image di Domer stanno già incorporando alcune di queste funzionalità in modo semplice e accessibile. La direzione è chiara: non basta più generare clip isolate, ma costruire piccoli universi narrativi con personaggi stabili e riconoscibili.
Per chi vuole restare aggiornato sulle novità, la pagina pricing di Domer mostra anche i modelli più recenti disponibili, così puoi scegliere il piano e gli strumenti più adatti al tuo progetto. E se vuoi sperimentare subito, il consiglio è di iniziare con un personaggio semplice, creare una piccola sequenza di tre scene e testare la coerenza prima di lanciarti in produzioni più ambiziose.
La coerenza del personaggio è il confine che separa i video amatoriali da quelli professionali. Con le tecniche giuste e gli strumenti adatti, non è più un sogno irraggiungibile: è solo questione di metodo. Sperimenta, confronta e trova il flusso di lavoro che funziona per te. Il tuo prossimo personaggio — quello che non cambierà mai volto — è già a portata di click.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.