
Fusion d'Images Multiples : Créez des Personnages Cohérents avec l'IA
Aug 4, 2026
Le Défi de la Cohérence des Personnages en Vidéo IA
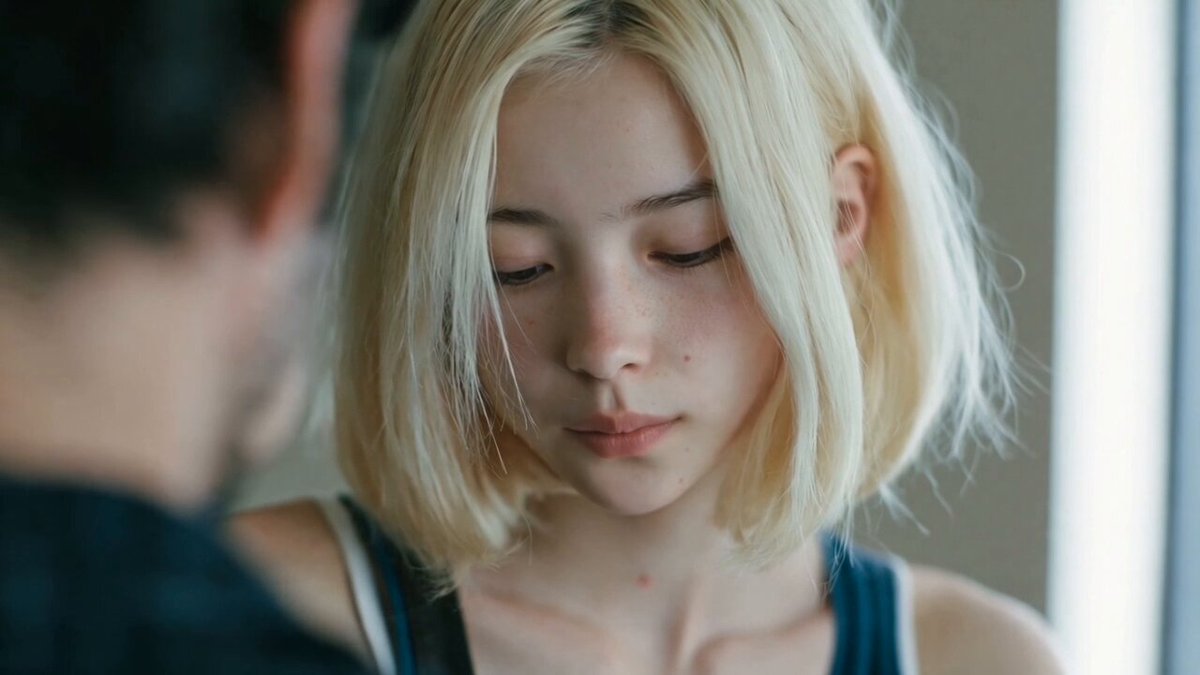
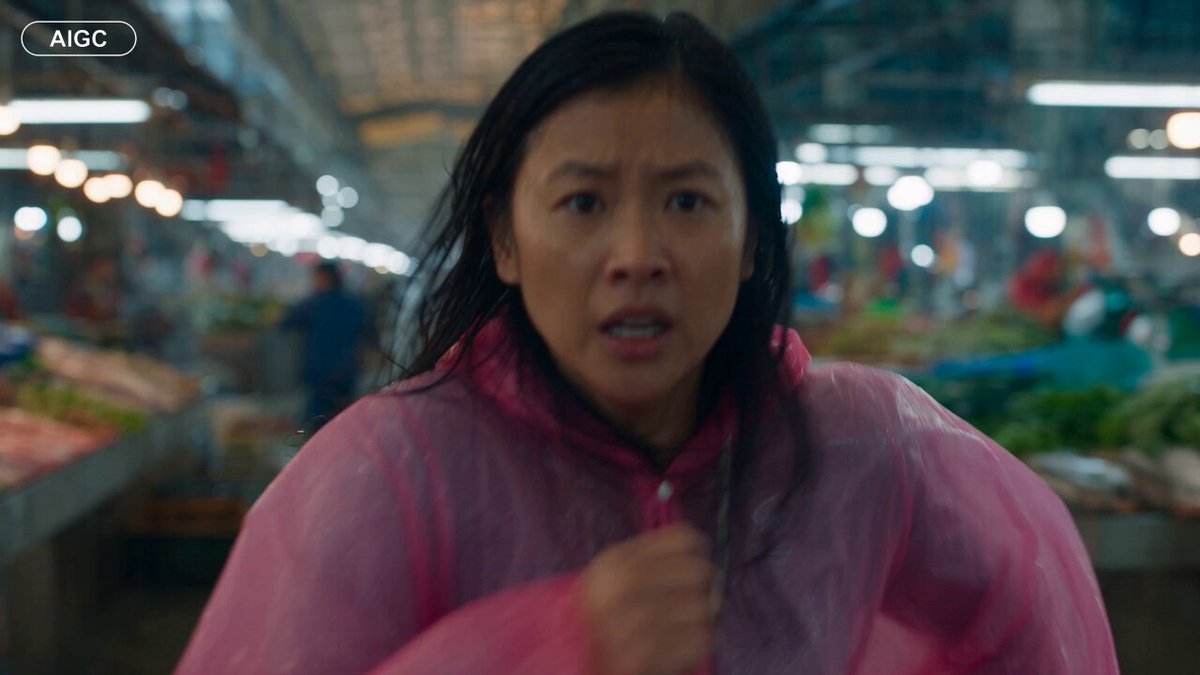
Créer un personnage qui reste visuellement identique d'une scène à l'autre est l'un des plus grands défis de la génération vidéo par IA. Combien de fois avez-vous généré une séquence magnifique, pour découvrir que votre protagoniste a changé de visage, de coiffure ou de tenue entre deux plans ?
La fusion d'images multiples (multi-image fusion) est la solution qui change la donne. Cette technologie permet de maintenir une cohérence visuelle parfaite en utilisant plusieurs images de référence comme guide pour l'IA. Si vous travaillez sur des projets visuels, notre AI image generator intègre des fonctionnalités avancées de cohérence.
Comment Fonctionne la Fusion d'Images Multiples
Le Principe de Base
La fusion d'images multiples fonctionne sur un principe simple mais puissant : au lieu de générer un personnage à partir d'une simple description textuelle, l'IA reçoit plusieurs images de référence montrant le personnage sous différents angles, expressions et conditions d'éclairage.
Le modèle analyse ensuite :
- Les traits distinctifs du visage
- La structure corporelle
- Les textures et couleurs des vêtements
- Les proportions et la posture caractéristique
Ces informations sont "fusionnées" en une représentation cohérente que l'IA utilise pour toutes les générations suivantes.
L'Architecture Technique
Les systèmes modernes de fusion utilisent des réseaux de neurones spécialisés dans l'extraction et la comparaison de caractéristiques visuelles. Le processus se déroule en trois étapes :
- Extraction : chaque image de référence est analysée pour en extraire les caractéristiques clés
- Fusion : les caractéristiques sont combinées en un profil de personnage unifié
- Génération : le profil guide la création de nouvelles images où le personnage apparaît de manière cohérente
Ce qui rend cette approche révolutionnaire, c'est qu'elle ne se contente pas de copier-coller des éléments — elle comprend l'essence du personnage et la reproduit de manière créative.
Applications Pratiques
Séries Vidéo et Contenu Narratif
Pour les créateurs de séries ou de contenu narratif, la cohérence des personnages est non négociable. La fusion d'images multiples permet de :
- Maintenir l'apparence du protagoniste sur plusieurs épisodes
- Assurer la continuité visuelle entre les scènes
- Créer des univers visuels cohérents avec des personnages récurrents
Imaginez produire une mini-série entière où votre héros est parfaitement reconnaissable du premier au dernier plan — c'est désormais possible sans équipe de design.
Marketing et Branding
Pour les marques, un personnage mascotte cohérent est un atout marketing puissant. La fusion d'images permet de :
- Décliner la mascotte dans différentes situations tout en gardant son identité
- Créer des campagnes publicitaires visuellement unifiées
- Adapter le personnage à différents formats (réseaux sociaux, affichage, vidéo)
Prototypage de Jeux Vidéo et Animation
Les développeurs indépendants peuvent utiliser cette technologie pour prototyper rapidement des personnages et tester différentes directions artistiques sans passer des semaines en design. GPT Image 2 offre des capacités exceptionnelles pour ce type d'application.
Guide Pratique : Créer Votre Premier Personnage Cohérent
Étape 1 : Préparez Vos Images de Référence
La qualité des références détermine la qualité du résultat. Idéalement, fournissez 3 à 7 images montrant :
- Le visage de face, de profil et de trois-quarts
- Différentes expressions (neutre, souriant, sérieux)
- Le personnage en pied pour la silhouette complète
- Des conditions d'éclairage variées
Étape 2 : Choisissez le Bon Modèle
Tous les modèles IA ne gèrent pas la fusion d'images de la même manière. Les modèles les plus récents offrent généralement de meilleurs résultats. Privilégiez ceux qui mentionnent explicitement le support multi-référence.
Étape 3 : Rédigez des Prompts Précis
Même avec des références, le prompt reste crucial. Décrivez précisément :
- L'action ou la pose souhaitée
- L'environnement
- L'éclairage et l'ambiance
- Tout changement souhaité (nouvelle tenue, accessoire)
Étape 4 : Itérez et Affinez
La première génération est rarement parfaite. Utilisez-la comme base pour affiner vos prompts et éventuellement ajouter une image de référence supplémentaire. Le processus créatif avec l'IA est itératif.
Pièges à Éviter
Références Trop Différentes
Si vos images de référence montrent des personnages trop différents (coiffure radicalement changée, âge différent, style vestimentaire incompatible), l'IA aura du mal à créer une fusion cohérente. Restez dans des variations naturelles.
Surcharge de Références
Plus n'est pas toujours mieux. Au-delà de 7-8 images, les modèles peuvent avoir du mal à prioriser les caractéristiques importantes. La qualité prime sur la quantité.
Oublier le Contexte
Un personnage cohérent dans le vide n'est pas suffisant. Pensez à comment il interagit avec son environnement. L'IA doit comprendre non seulement à quoi ressemble le personnage, mais comment il se comporte dans l'espace.
L'Avenir de la Cohérence Visuelle
Au-delà des Images Fixes
La prochaine frontière est la cohérence en mouvement. Les modèles émergents commencent à maintenir non seulement l'apparence mais aussi la gestuelle caractéristique et les patterns de mouvement d'un personnage à travers les séquences vidéo.
Personnages Interactifs
Imaginez un personnage IA qui peut apparaître dans différents contextes tout en maintenant sa personnalité visuelle. Les applications dans le jeu vidéo, la réalité augmentée et les assistants virtuels sont immenses.
Création Collaborative
Les plateformes évoluent vers des écosystèmes où les créateurs partagent leurs profils de personnages, créant des bibliothèques réutilisables d'avatars cohérents.
Conclusion
La fusion d'images multiples n'est pas qu'une fonctionnalité technique — c'est un changement de paradigme créatif. Elle libère les créateurs de la frustration de l'incohérence et ouvre la voie à des productions visuelles ambitieuses.
Que vous soyez storyteller, marketeur ou game designer, la maîtrise de cette technique vous donnera un avantage compétitif décisif. Commencez à expérimenter avec notre AI video generator et découvrez la puissance de la cohérence visuelle par IA.
Seedance 2.0 repousse encore plus loin les limites avec ses capacités avancées de génération vidéo cohérente.

Alexander
More Blogs
Read MoreVidu Q4 Alternatives: 4K AI Video Models Compared (2026)
Vidu Q4 alternatives compared: Kling 4.0, Seedance 2.5, Wan 3.0, and Runway Gen-4 — 4K support, input modes, durations, audio, and what each costs in credits on Domer.
Top 4K AI Image Generators in 2026: 5 Models Compared on Real Costs
The top 4K AI image generators on Domer compared: Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, GPT Image 2, and Nano Banana Pro — 4K credit costs, reference limits, and speed.
Nano Banana 2.1 vs GPT Image 2.5: Which Image Model Should You Use? (2026)
Nano Banana 2.1 vs GPT Image 2.5 Flare compared: credit costs per resolution, aspect ratios, reference images, text rendering, and which tasks fit each model.