
Spójność wizualna w filmach AI: kompletny przewodnik
Oct 1, 2026
Spójność wizualna w wideo AI: na czym naprawdę polega problem
Spójność wizualna oznacza, że bohater, scenografia, paleta barw i język kamery pozostają rozpoznawalne przez wiele ujęć — mimo że każde ujęcie powstaje w osobnym przebiegu generatora. Brzmi jak oczywistość, a jest najczęstszym źródłem frustracji w produkcji z użyciem generatywnego wideo.
Problem nie polega na tym, że modele tworzą słabe obrazy. Pojedyncze ujęcie potrafi zachwycić detalem, światłem i płynnością ruchu. Trudność zaczyna się, gdy potrzebujemy ciągłości: ta sama postać w trzech scenach, ten sam płaszcz, ta sama blizna nad brwią, to samo światło o zmierzchu. Generator za każdym razem interpretuje opis od nowa i przy każdej interpretacji podejmuje dziesiątki decyzji, których nie kontrolujemy.
Widz nie zawsze potrafi nazwać, co mu przeszkadza, ale wyczuwa niespójność. Twarz bohatera delikatnie się zmienia między ujęciami, kolor kurtki dryfuje od granatu do szarości, a wnętrze, które w pierwszej scenie miało wysokie okna, w trzeciej ma już tylko jedno. Ten efekt nazywamy dryfem wizualnym i to on decyduje o tym, czy materiał wygląda profesjonalnie, czy amatorsko.
Dobra wiadomość jest taka, że spójności nie osiąga się jednym magicznym ustawieniem. To proces inżynieryjny: referencje, klatki kluczowe, kontrola ruchu i konsekwentna weryfikacja. Poniższy przewodnik pokazuje ten proces od początku do końca, wraz z decyzjami, które trzeba podejmować na każdym etapie.
Dlaczego same prompty tekstowe nie wystarczają
Tekstowy prompt to opis, nie specyfikacja. Model traktuje go jako inspirację i wypełnia luki własną estetyką. Im dłuższy prompt, tym większa szansa, że część informacji zostanie zignorowana lub zinterpretowana inaczej w kolejnym przebiegu.
Dryf semantyczny: każdy przebieg to nowa interpretacja
Nawet identyczny prompt z identycznym ziarnem losowości nie gwarantuje identycznego rezultatu, jeśli zmieni się choćby jeden element otoczenia — długość ujęcia, rozdzielczość, liczba klatek animacji. Model podejmuje decyzje lokalnie, więc opis taki jak „postać w długim płaszczu, zimowe światło, port miejski” może w jednym ujęciu dać płaszcz wełniany, a w drugim skórzany. To nie błąd modelu, lecz konsekwencja probabilistycznej natury generowania.
Brak pamięci między ujęciami
Większość generatorów wideo nie przechowuje stanu projektu. Każde ujęcie jest osobnym światem. Nie ma wspólnej pamięci o tym, jak wyglądała twarz bohatera w poprzedniej scenie, jaki był kierunek padania światła ani gdzie stała kamera. Ciągłość trzeba więc wprowadzić z zewnątrz — przez referencje i klatki kluczowe.
Zmiana modelu zmienia styl
Różne modele mają różne domyślne estetyki: jeden preferuje miękkie, filmowe światło, inny ostry, cyfrowy kontrast. Jeśli animujesz kolejne ujęcia w różnych narzędziach, styl zaczyna się rozjeżdżać nawet przy perfekcyjnym opisie. Wniosek jest prosty: albo konsekwentnie używaj jednego modelu w obrębie sekwencji, albo zaplanuj etap ujednolicania wyglądu w postprodukcji.
Biblia wizualna projektu: dokument, który robi różnicę
Najskuteczniejszy trik nie jest techniczny. To dokument, który tworzysz przed pierwszym uruchomieniem generatora. Biblia wizualna to zbiór referencji i reguł, do których wracasz przy każdym ujęciu. Bez niej każda decyzja jest improwizacją, a improwizacja w kilkudziesięciu ujęciach zawsze prowadzi do chaosu.
Karta postaci
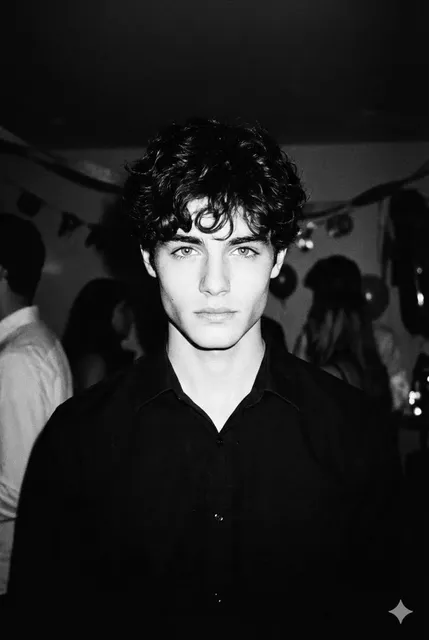
Zbierz od trzech do sześciu ujęć bohatera: portret frontalny przy neutralnym świetle, profil, ujęcie z ukosa oraz zbliżenie na charakterystyczny detal — bliznę, tatuaż, biżuterię, kształt nosa. Do tego ustal stałe cechy: wzrost względem innych postaci, kolor włosów, typ sylwetki, dominujący strój. Wszystko zapisz w jednym miejscu, najlepiej razem z referencjami, żeby w trakcie pracy nie szukać plików po dyskach.
Karta scenografii i palety
Scenografia dryfuje najczęściej dlatego, że opisywana jest ogólnie. „Nowoczesne biuro” w każdym ujęciu będzie inne. „Biuro z betonowymi kolumnami, oknami od podłogi do sufitu po lewej stronie i szarym dywanem” jest już specyfikacją. Do tego dochodzi paleta: trzy kolory dominujące, jeden akcent, temperatura barwowa i poziom kontrastu. Paleta to najtańszy sposób na spójność całej sekwencji — nawet jeśli detale się różnią, widz odbiera materiał jako jednorodny.
Karta kamery i światła
Ustal zasady języka wizualnego: ogniskową, wysokość kamery, kierunek ruchu, kierunek światła głównego oraz styl cieni. Sekwencja, w której kamera raz jest na wysokości oczu, a raz przy podłodze, może być zamierzona, ale musi być zamierzona. Przypadkowe zmiany perspektywy między ujęciami tej samej sceny są jednym z najczęstszych powodów, dla których zmontowany materiał wygląda niechlujnie.
Kotwiczenie wieloobrazowe zamiast opisów słownych
Największy skok jakości pojawia się, gdy przestajesz opisywać wygląd słowami, a zaczynasz go pokazywać. Współczesne narzędzia pozwalają podać kilka obrazów referencyjnych jednocześnie — portret postaci, zdjęcie kostiumu, kadr scenografii i próbkę kolorystyczną. Model łączy te sygnały i generuje materiał osadzony w konkretnej rzeczywistości wizualnej, a nie w interpretacji przymiotników.
Ile referencji wystarczy
Praktyczna zasada: trzy do pięciu obrazów na jedno ujęcie. Jedna referencja twarzy, jedna stroju, jedna scenografii, jedna światła lub kolorystyki. Więcej referencji nie zawsze znaczy lepiej — zbyt wiele sprzecznych sygnałów powoduje, że model zaczyna wybierać losowo i wynik staje się mniej przewidywalny niż przy prostym opisie.
Priorytety i wagi referencji
Jeśli narzędzie pozwala ustawić siłę wpływu poszczególnych obrazów, przypisz najwyższą wagę temu elementowi, który jest dla sceny krytyczny. W zbliżeniu będzie to twarz, w panoramie — architektura. Zbyt mocna waga referencji scenografii w ujęciu portretowym potrafi zdominować kompozycję i wypchnąć postać na drugi plan. Testuj na dwóch klatkach, zanim wygenerujesz całą serię.
Klatki kluczowe i ciągłość ruchu
Referencje ustalają wygląd, ale nie ruch. Ciągłość akcji wymaga kontroli klatek: pierwszej, ostatniej oraz ewentualnych punktów pośrednich.
Pierwsza i ostatnia klatka ujęcia
Wygeneruj statyczną klatkę początkową i końcową, a następnie zleć modelowi interpolację ruchu między nimi. Ta metoda daje ogromną przewidywalność: wiesz, gdzie scena się zaczyna i gdzie się kończy, a generator odpowiada wyłącznie za płynność przejścia. Świetnie sprawdza się w ujęciach dialogowych, wejściach postaci w kadr i prostych akcjach fizycznych.
Łączenie ujęć i przejścia
Jeśli dwie sceny mają tworzyć wrażenie ciągłego ruchu, użyj ostatniej klatki ujęcia pierwszego jako bazy dla pierwszego kadru drugiego. Zachowasz nie tylko kostium i światło, ale także kierunek ruchu, co eliminuje efekt przeskoku, który widzowie odbierają jako amatorski montaż. W scenach ciętych zmieniaj jednocześnie nie więcej niż dwie rzeczy: kąt kamery i odległość planu.
Workflow produkcyjny krok po kroku
Krok 1: rozbicie sceny na ujęcia
Zacznij od scenopisu i rozbij go na ujęcia trwające od trzech do ośmiu sekund. Każde ujęcie opisuj w jednym zdaniu: kto, co robi, gdzie stoi kamera, jakie jest światło. Ten format wymusza konkret i od razu pokazuje, które ujęcia dzielą te same warunki i mogą korzystać z tych samych referencji.
Krok 2: generowanie klatek bazowych
Wygeneruj klatki statyczne dla wszystkich ujęć, zanim uruchomisz animację. Statyczna klatka jest tania, szybka i łatwa do porównania. Ustaw je obok siebie w siatce i sprawdź, czy bohater wygląda jak ta sama osoba, czy paleta jest zgodna i czy scenografia się nie rozjechała. Poprawki na tym etapie kosztują minuty; na etapie gotowej animacji — godziny.
Krok 3: animacja i kontrola ruchu
Dopiero teraz animuj ujęcia, korzystając z klatek kluczowych i referencji obrazowych. Animuj partiami po trzy do pięciu ujęć z tej samej sceny, żeby utrzymać te same parametry techniczne. Notuj ustawienia, które zadziałały — przy dwudziestu ujęciach pamięć jest zawodna, a przypadkowa zmiana parametru potrafi zepsuć całą serię.
Krok 4: weryfikacja i poprawki
Złóż wszystko na osi czasu i obejrzyj bez dźwięku. Spójność ocenia się inaczej w ciszy: oko wyłapuje wtedy zmiany kontrastu, temperatury barwowej i pozycji bohatera w kadrze. Dopiero potem dodaj dźwięk i sprawdź, czy rytm montażu nie eksponuje różnic w ruchu między ujęciami.
Hybrydowy zestaw narzędzi: kiedy jeden model to za mało
Różne narzędzia mają różne mocne strony: jedne lepiej radzą sobie z realizmem twarzy, inne z ruchem kamery, jeszcze inne z abstrakcyjnymi stylami. Sensowna strategia to dobór narzędzia do zadania, ale w obrębie jednej scenki konsekwentne trzymanie się jednego modelu. Inaczej styl dryfuje, a Ty spędzasz czas na ujednolicaniu zamiast na opowiadaniu historii.
Poza generatorem wideo warto mieć w zestawie narzędzie do generowania i edycji klatek statycznych, prosty edytor do korekcji koloru oraz arkusz do notowania parametrów. To niewielki stack, ale jego brak jest najczęstszą przyczyną sytuacji, w której po tygodniu pracy nikt nie pamięta, jak powstało najlepsze ujęcie.
Kiedy spójność pęka: typowy troubleshooting
Twarz dryfuje między ujęciami
Najczęstsza przyczyna to opis twarzy w promptach zamiast referencji obrazowej. Dodaj portret referencyjny o wysokiej rozdzielczości, ustaw go jako główne źródło tożsamości i skróć opis słowny do cech, których obraz nie przekazuje — wieku, emocji, kierunku spojrzenia.
Tło się rozjeżdża
Zwykle wynika to ze zbyt ogólnego opisu scenografii albo z braku kadru referencyjnego wnętrza. Wygeneruj jeden dobry kadr tła i używaj go jako referencji we wszystkich ujęciach tej samej lokalizacji. Jeśli scena ma zmieniać kąt, zmieniaj tylko pozycję kamery, nie architekturę.
Ruch jest nienaturalny
Problemy z ruchem najczęściej biorą się z ujęć zbyt długich i zbyt ambitnych. Podziel akcję na krótsze segmenty, dodaj klatkę końcową i unikaj zlecania modelowi jednocześnie chodzenia, gestykulacji i pracy kamery. Jeden ruch na ujęcie to dobra zasada robocza.
Kolor i ziarno nie pasują
Nawet przy spójnych ujęciach materiały z różnych narzędzi różnią się ziarnem i przestrzenią barw. Rozwiązaniem jest warstwa korekcji koloru na końcu montażu: wyrównaj balans bieli, nałóż wspólny LUT i dodaj jednolite ziarno. Ten etap potrafi uratować sekwencję, która w surowym eksporcie wyglądała niejednorodnie.
Checklista kontroli jakości przed eksportem
Przed publikacją przejrzyj materiał według krótkiej listy. Czy bohater ma spójne rysy twarzy i strój we wszystkich ujęciach? Czy paleta barw i temperatura światła są zgodne w obrębie sceny? Czy kierunek ruchu i pozycja bohatera w kadrze nie skaczą między cięciami? Czy ziarno i ostrość są jednorodne? Czy scenografia nie zmienia układu bez powodu narracyjnego? Jeśli któryś punkt budzi wątpliwość, cofnij się o jeden etap i popraw u źródła — poprawianie w postprodukcji jest zawsze droższe.
FAQ
Jak długo powinno trwać pojedyncze ujęcie w generatywnym wideo?
W większości przypadków od trzech do sześciu sekund. Krótsze ujęcia są bardziej przewidywalne, łatwiej je też zmontować w rytmiczną sekwencję. Dłuższe ujęcia zwiększają ryzyko dryfu wyglądu pod koniec klipu.
Czy da się zachować spójność bez referencji obrazowych?
Częściowo, jeśli używasz bardzo precyzyjnych opisów i jednego modelu w całej sekwencji. W praktyce jednak referencje obrazowe skracają liczbę poprawek o rząd wielkości, zwłaszcza gdy w projekcie występują twarze.
Ile klatek kluczowych warto przygotować?
Minimum dwie: początkową i końcową. Przy dynamicznych akcjach warto dodać jedną klatkę pośrednią, która wyznacza trajektorię ruchu i zapobiega niekontrolowanym zmianom kompozycji.
Czy można mieszać modele w jednym projekcie?
Tak, ale najlepiej na poziomie scen, nie ujęć. Jeden model na sekwencję, potem korekcja koloru i ziarna jako etap ujednolicania. Mieszanie modeli w obrębie tej samej scenki niemal zawsze kończy się widocznym rozjazdem stylu.
Co zrobić, gdy po tygodniu chcę powtórzyć udane ujęcie?
Prowadź dziennik produkcji: referencje, parametry, długość ujęcia, użyty model i numer wersji klatki bazowej. Bez tego rekonstrukcja dobrego wyniku jest zgadywaniem, a nie powtarzalnym procesem.
Jak ocenić spójność obiektywnie?
Zrób siatkę miniatur wszystkich ujęć sceny i obejrzyj ją z odległości. Jeśli bohater i paleta wyglądają spójnie w małym formacie, prawdopodobnie będą spójne także na ekranie. Dodatkowo obejrzyj sekwencję bez dźwięku — uwaga wzrokowa działa wtedy ostrzej.
Spójność wizualna nie jest cechą modelu, lecz cechą procesu. Referencje ustalają tożsamość, klatki kluczowe kontrolują ruch, a dyscyplina w notowaniu parametrów pozwala powtarzać dobre wyniki. Kiedy te trzy elementy pracują razem, generatywne wideo przestaje być loterią, a staje się przewidywalnym narzędziem produkcji.

Alexander
More Blogs
Read MoreThumbnail efficaci per TikTok e YouTube: guida pratica
Come progettare thumbnail che fermano lo scroll: strumenti, workflow, criteri di test e ottimizzazione per TikTok e YouTube, con esempi pratici.
Cómo descargar portadas de Reels de Instagram con criterio
Guía práctica para descargar, elegir y reutilizar portadas de Reels de Instagram sin perder calidad, con flujos de trabajo, errores y consejos de diseño.
AI Voiceover and Music Workflows for Better Video Sound
Build a repeatable workflow for AI voiceover and generated music: script prep, voice selection, mixing levels, loudness targets, and QA checks.