
AI動画生成の現在地:基盤技術から生成モデルへ
生成AIによる動画制作は、この数年で「実験的なデモ」から「実務で使える工程」へと急速に移行しました。初期のディープラーニングフレームワークが切り開いた機械学習の基盤は、静止画生成、そして時系列を扱う動画生成へと応用範囲を広げ、いまでは画像拡散モデルとTransformer系アーキテクチャを組み合わせた設計が主流になっています。フレーム間のつながりを保つためのアテンション機構や、物理的な動きをある程度再現する学習が進んだことで、数秒から十数秒のクリップであれば、大がかりな撮影機材なしでも説得力のある映像を作れるようになりました。
一方で、課題もはっきりしています。第一に、長尺の一貫性です。同じ人物が複数のショットに登場すると、顔立ち・髪型・服装・照明の色味が少しずつずれていく現象は、いまもっとも多くの制作者が悩むポイントです。第二に、意図した動きの制御です。「ゆっくり歩きながら振り返る」といった複合的な動きは、テキストだけでは伝わりにくく、参照画像やキーフレーム、構図の指定を組み合わせる必要があります。第三に、音声との統合です。映像が美しくても、リップシンクや効果音、BGMのバランスが崩れていれば、作品としての完成度は上がりません。
技術の流れを整理する
かつては汎用の機械学習フレームワーク上でモデルを一から組み立てるのが当たり前でしたが、現在の動画生成は「基盤モデルをどう使い分けるか」という段階に移っています。汎用の画像生成モデルを時系列に拡張した系統、動画専用に設計された系統、そしてオープンウェイトで配布されローカル環境でも動かせる系統の三つが併存しているのが特徴です。制作の現場では、これらを一つのツールで済ませるよりも、用途に応じて組み合わせる方が現実的です。
モデル選定の判断基準:品質・速度・制御性・再現性
ツールを選ぶときに最初に決めるべきは「何を作りたいか」ではなく「何を優先するか」です。以下の四つの軸で整理すると、判断がぶれにくくなります。
評価軸の整理
- 品質:解像度、質感、ライティングの自然さ、人間の描写の破綻の少なさ。広告や映像作品では最優先になります。
- 制御性:参照画像、キーフレーム、カメラワーク、モーション指定など、意図を反映できる度合い。
- 速度と反復回数:1本の生成にかかる時間と、何回試行できるか。SNS運用では反復回数がそのまま成果に直結します。
- 再現性:同じ条件で近い結果が得られるか、プロジェクトを後から再開できるか。チーム制作では必須の条件です。
代表的な選択肢の使い分け
| 系統 | 得意な用途 | 注意点 |
|---|---|---|
| 高品質な汎用モデル | 広告、短編映像、コンセプト映像 | 生成ごとの揺れが大きく、試行回数が必要 |
| 動画特化モデル | 人物の動き、シネマティックな構図 | ショット設計の自由度はモデル依存 |
| オープンウェイト系 | 大量試作、社内検証、独自の追加学習 | 環境構築とGPUの準備が必要 |
| 画像生成+動画化 | キャラクター一貫性が重要なシリーズ | 動きの自然さは動画化ツール依存 |
近年は、一つのプロジェクト内で「人物が映るショットはA、風景はB、動きの激しい場面はC」というように分担させる手法が定着しています。すべてを単一モデルで賄おうとすると、どこかで妥協が生まれます。
予算ではなく工数の視点で考える
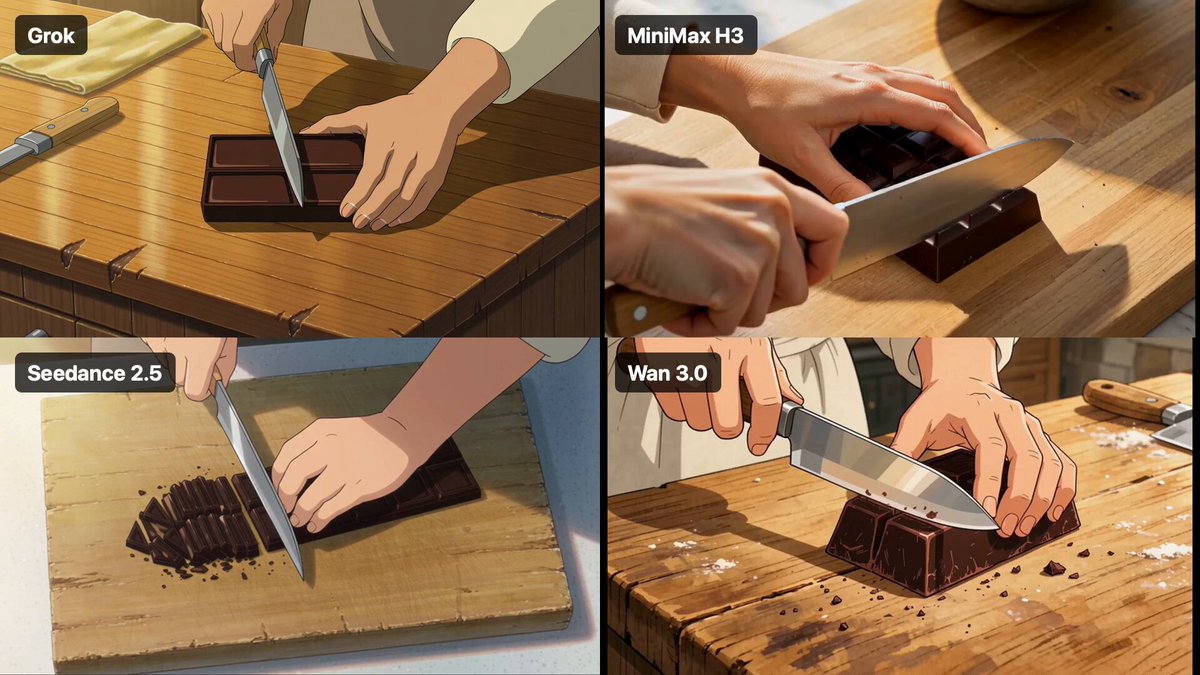
制作コストを考えるとき、多くの人がAPIの従量課金だけを見がちですが、実際に効いてくるのは「1本の完成に何回の生成と何時間の編集が必要か」です。高品質なモデルで10回試して1本採用できる場合と、軽量なモデルで50回試して1本採用できる場合、掛かる時間は大きく違います。まずは小さな検証セット(同じプロンプトで3モデル×3回)を作り、採用率を測るのがおすすめです。
制作ワークフロー全体像:企画から納品まで
AI動画制作は、魔法のボタンを押す作業ではありません。撮影を伴う従来の映像制作と同様に、企画、設計、素材生成、編集、仕上げという工程を踏みます。違うのは、撮影の代わりに生成と選別の工程が入る点です。
ステップ1:企画と絵コンテ
目的、尺、公開先、トーンを最初に固めます。15秒の縦型動画と3分の横型動画では、必要なショット数もプロンプトの粒度も変わります。この段階で、AIで作るべきショットと実写・既存素材で対応するショットを切り分けておくと、後の手戻りが減ります。人物の手元アップや商品の質感など、生成が苦手な領域は最初から別案を用意しておきましょう。
ステップ2:ショットリストとキーフレーム
ショットリストには、番号、尺、ショットサイズ、カメラの動き、被写体の動き、セリフや効果音の有無を書き出します。次に、各ショットの基準となる静止画(キーフレーム)を画像生成で作ります。ここで構図とライティングを確定させておくと、動画生成の成功率が目に見えて上がります。
ステップ3:生成と選別
キーフレームを入力にして動画を生成し、複数候補から採用テイクを選びます。選別の観点は「奇麗さ」ではなく「つながり」です。前後のショットと並べたときに、被写体の位置や視線の方向が自然につながるかを確認します。
ステップ4:編集・音声・カラー
編集ソフトに素材を並べ、テンポを整えます。生成クリップは尺が揃わないことが多いため、速度調整やトリミングで呼吸を合わせます。その後、ナレーション、効果音、BGMを重ね、最後にカラー調整と書き出しを行います。
一貫性を守る技術:キャラクター・照明・カメラ
一貫性は「うまく出す」ではなく「設計で守る」ものです。以下の四つを固定するだけで、シリーズものの品質は安定します。
参照画像を設計する
キャラクターの参照画像は1枚ではなく、正面・斜め・横の3方向を用意します。服装、髪型、アクセサリーの位置まで揃えた画像セットを作り、すべてのショットで同じセットを使います。照明条件が異なる参照画像を混ぜると、モデルはどちらを基準にすべきか判断できず、顔つきがぶれます。
シードとプロンプトを固定する
同じショット内で複数回生成する場合は、乱数シードを固定し、変更する要素を一度に一つだけにします。プロンプトとシードを同時に変えると、どの変更が結果に効いたのか分からなくなります。プロジェクト管理表に、ショット番号、使用モデル、プロンプト、シード、採用テイクを記録しておくと、後からの再生成が容易になります。
照明とカラーをそろえる
「夕方の逆光」「室内の蛍光灯」「曇天の拡散光」など、照明条件をショットリストの時点で言語化しておきます。編集時にまとめてカラー調整する前提で、あえて少しフラットに生成するのも有効です。
つなぎの設計
ショット間のつながりは、視線、動作の方向、画面内の位置で作ります。前のショットで人物が画面左から右へ歩き始めたら、次のショットも同じ方向に動かす。この原則を守るだけで、生成物の粗さが目立ちにくくなります。
プロンプト設計の実践:カメラワークを言語化する
動画生成のプロンプトは、情景の説明ではなく「撮影指示書」として書きます。順序を固定すると再現性が上がります。
基本の型
- 被写体と状況(誰が、どこで、何をしているか)
- ショットサイズ(クローズアップ、ミディアム、ロング)
- カメラの動き(固定、パン、ティルト、ドリー、手持ち)
- レンズと被写界深度(広角、望遠、浅いボケ)
- 照明と時間帯
- 質感と雰囲気(フィルムグレイン、クリーンなデジタル感)
- 避けたい要素(指の崩れ、文字の混入、余計な人物)
動きは「一つの動詞」に絞る
「走りながら振り返って手を振る」のように動きを詰め込むと、モデルはどれかを省略します。1ショット1アクションを原則にし、複雑な動きはショットを分けてつなぐ方が結果が良くなります。
ネガティブ指定の使いどころ
手指の崩れ、顔の歪み、余分な手足、画面内の文字、ロゴの混入などは、生成のたびに発生しやすい代表例です。ネガティブ指定である程度は抑えられますが、完全には消えません。重要なショットでは、生成後に部分的な差し替えや静止画での補正を前提にしておきましょう。
音声・音楽・字幕:作品として仕上げる工程
映像だけでは作品になりません。音の設計は、AI生成映像の粗さを最も効果的に隠せる工程でもあります。
ナレーションとリップシンク
ナレーション原稿は、耳で聞いて理解できる長さに調整します。1文を短くし、息継ぎの位置を指定すると、合成音声でも自然に聞こえます。人物が話すショットでは、音声を先に作り、その波形に合わせて映像を選ぶ方が、逆方向で合わせるよりも破綻が少なくなります。
効果音とBGM
シーン転換、動作の強調、無音の間。この三つを使い分けるだけで、素人っぽさが大きく減ります。特に「無音」は強力で、生成映像の継ぎ目に一瞬の無音を置くと、視聴者の違和感が薄れます。
字幕とテロップ
縦型動画では字幕が事実上必須です。読みやすい太さ、背景とのコントラスト、1行あたりの文字数を固定し、テンプレート化しておくと作業が速くなります。
チーム運用とリソース配分:持続可能な制作体制の作り方
個人制作なら問題になりませんが、チームでAI動画を回すと、必ずボトルネックが生まれます。多くの場合、それは生成そのものではなく、素材の管理と承認の工程です。
役割分担の例
- ディレクター:企画、ショットリスト、最終判断
- プロンプト設計:モデルごとの書き分け、検証
- 生成オペレーター:大量生成と選別、記録
- 編集:つなぎ、音、カラー、書き出し
少人数なら兼務になりますが、「誰が最終判断をするか」だけは決めておきます。生成のたびに方向性が変わると、素材が散らかって収拾がつかなくなります。
素材管理のルール
命名規則を決めます。たとえば ショット番号_モデル_テイク番号_日付 のように統一し、採用テイクには印を付けます。クラウドストレージ上でフォルダをショット単位に切り、プロンプトとシードをテキストファイルで同梱しておくと、数か月後の修正依頼にも対応できます。
計算リソースの見積もり
ローカル環境でオープンウェイトのモデルを動かす場合、GPUメモリと生成時間が計画の鍵になります。まずは解像度を落として構図だけを検証し、採用が決まったショットだけ高解像度で再生成する二段構えが効率的です。クラウド側の従量課金を使う場合も、「検証は安い手段、本番は高い手段」と役割を分けると同じ考え方が当てはまります。
用途別の実践パターン:広告・SNS・教育・エンタメ
広告・プロモーション
尺が短く、訴求点が明確なほどAI生成と相性が良い領域です。商品そのものの質感再現は苦手なので、商品は実写またはCGで作り込み、周辺の世界観や人物のリアクションを生成で補う分業が現実的です。
SNSショート動画
反復回数が命です。1本に時間をかけず、複数案を同時に作り、反応を見て伸ばす運用が向いています。冒頭1秒で視聴者を引きつける構図を固定し、後半だけを差し替えるテンプレート運用が効果的です。
教育・研修
正確さが優先される領域では、生成映像は「イメージカット」に限定し、手順の説明は画面収録や図解で補います。ナレーションと字幕を整えるだけでも、研修教材としての完成度は十分に高くなります。
エンタメ・ショートフィルム
物語の一貫性が最重要になります。登場人物の設定資料、色設計、ショットのリズムを先に決め、生成はその設計に従わせます。AIは演出の代行ではなく、演出を実現するための道具として扱うのが、結果的に作品の質を上げます。
よくある失敗とトラブルシューティング
- 同じ人物が別人に見える:参照画像の照明条件をそろえ、正面・斜め・横のセットを使い回す。編集で顔のトーンを合わせる。
- 動きが不自然に速い/遅い:プロンプトの動詞を一つに絞り、ショットを分割。編集で速度を微調整する。
- 手や指が崩れる:手が画面に大きく映る構図を避ける。どうしても必要なら、手前に物を置いて隠す。
- 画面内に意味不明な文字が入る:看板や本など、文字が入りやすい小道具を構図から外す。ネガティブ指定も併用する。
- ショットの色味がばらつく:編集ソフトでトーンを統一する。生成時にあえてフラットに寄せる。
- 生成結果が毎回違いすぎる:シードを固定し、変更要素を一度に一つにする。
- 書き出しで画質が落ちる:ビットレートとコーデックを確認。アップロード先の推奨設定に合わせる。
- 権利関係が不明確になる:利用規約と商用利用の可否を確認し、人物の肖像や既存キャラクターに似せない。
FAQ:AI動画制作のよくある疑問
Q1. どのモデルから始めるべきですか
まずは無料または低コストで試せるものを一つ選び、短いクリップを10本作ってみてください。そのうえで、品質・制御性・速度のどこに不満を感じたかを基準に、次に試すモデルを決めると失敗が少なくなります。
Q2. 撮影はもう不要になりますか
短いカットや雰囲気づくりの映像は生成で十分に代替できますが、商品の質感、手元の繊細な動作、特定の人物の表情などは、実写の方が速く正確なことが多いです。両者を組み合わせる前提で企画を立てるのが現実的です。
Q3. 生成した映像の権利はどうなりますか
モデルごとに利用条件が異なります。商用利用の可否、生成物の扱い、学習データに関する記載を確認し、社内で判断基準を文書化しておきましょう。
Q4. 長尺の動画は作れますか
数分以上の作品は、短いクリップをつないで構成する方法が一般的です。1ショットあたり5〜10秒を基本単位とし、編集でテンポを作る方が、長いクリップを一発生成するよりも安定します。
Q5. 人物の一貫性を保つコツはありますか
参照画像のセット化、シードの固定、照明条件の統一、ショット間の動線設計。この四つが基本です。加えて、編集段階でのカラー調整と、必要に応じた部分的な静止画補正を組み合わせます。
Q6. 音声はどう作ればいいですか
ナレーションは原稿を先に整え、合成音声で読み上げます。人物が話す場面では、音声を先に作り、それに合わせて映像を選ぶ方が破綻しにくくなります。
Q7. プロンプトは英語の方が良いですか
モデルによって得意な言語は異なります。同じ内容を日英両方で試し、結果を比較してから統一するのが確実です。チーム内では表記ゆれを防ぐため、用語集を作っておくと役立ちます。
Q8. 精度が出ないときはどうすればいいですか
解像度を下げて構図を検証し、採用が決まったショットだけを高品質で再生成する二段構えに切り替えてください。また、プロンプトを短くして要素を絞る、参照画像を差し替える、といった基本の見直しが効果的です。
Q9. 学習に使われたくない場合は
公開設定や学習への利用可否に関する項目を確認し、必要に応じてオフにします。機密性の高い素材は、ローカル環境で動かせるモデルを検討するのも選択肢です。
Q10. どのくらいの期間で習得できますか
ツールの操作自体は数日で慣れますが、思った通りの映像を安定して出せるようになるには、数十本の制作経験が必要です。まずは1分以内の短い作品を完成させることを目標にすると、学習の効率が上がります。
まとめ:設計力が成果を決める
AI動画生成の技術は、この先も速度を落とさず進化し続けるでしょう。新しいモデルが登場するたびに、できることの範囲は広がります。しかし、出来上がる作品の質を決めるのは、モデルの性能だけではありません。企画の解像度、ショット設計の丁寧さ、一貫性を守る仕組み、そして音と編集の積み上げ。これらは技術が変わっても価値が落ちません。
まずは小さな作品を一本、最後まで作り切ってください。生成、選別、編集、書き出しという一連の流れを一度経験すると、どの工程に時間が掛かり、どこを改善すべきかが見えてきます。そしてその経験こそが、次のプロジェクトで最も頼りになる判断基準になります。
