
Czym są awatary AI i wideo konwersacyjne
Awatar AI to cyfrowa reprezentacja osoby – twarzy, sylwetki i głosu – którą można animować za pomocą tekstu lub nagrania mowy. Wideo konwersacyjne to natomiast format, w którym bohater zwraca się bezpośrednio do widza, prowadzi z nim rozmowę i reaguje na kontekst: imię odbiorcy, jego wcześniejsze wybory, dane z formularza albo pytanie zadane w czasie rzeczywistym. Granica między tymi dwoma pojęciami jest płynna, ale właśnie ona definiuje cały współczesny workflow produkcji wideo.
W praktyce wyróżniamy trzy poziomy wdrożenia. Pierwszy to zwykłe nagranie z awatarem – wygenerowany klip montowany jak każdy inny materiał. Drugi to wideo spersonalizowane, gdzie ten sam szablon renderuje się w setkach wariantów, różniących się tekstem, głosem i scenografią. Trzeci to awatar interaktywny, który odpowiada w czasie zbliżonym do rzeczywistego, łącząc rozpoznawanie mowy, model językowy i syntezę głosu.
Trzy poziomy realizmu
- Stylizowany – wyraźnie animowany, ilustracyjny, często 3D. Najbardziej wybaczający dla niedoskonałości, świetny w szkoleniach i tłumaczeniu zawiłych procesów.
- Fotorealistyczny – realistyczna twarz i skóra, ale z odrobiną "cyfrowego" charakteru. Dobry kompromis między wiarygodnością a kosztem produkcji.
- Hiperealistyczny – próba pełnego złudzenia obecności człowieka. Najbardziej ryzykowny, bo każdy błąd w mimice, oczach i oddechu natychmiast wywołuje efekt uncanny valley.
Gdzie to działa najlepiej
Szkolenia wewnętrzne, onboarding, instrukcje produktowe, obsługa klienta w wielu językach, materiały sprzedażowe, kursy online, treści dla social mediów oraz lokalizacja istniejących nagrań na języki, których nie obsługuje zespół. We wszystkich tych przypadkach kluczowa jest powtarzalność: ten sam wykładowca, ten sam ton, nieskończona liczba wersji.
Jak działa pipeline produkcji: od briefu do eksportu
Produkcja wideo z awatarem przypomina klasyczną produkcję filmową, ale trzy etapy są zupełnie nowe: projektowanie tożsamości postaci, generowanie ruchu twarzy oraz synchronizacja ust. Reszta – scenariusz, dźwięk, montaż, kolor – pozostaje znajoma.
- Brief i cel – dla kogo jest materiał, jaka decyzja ma po nim zapaść, gdzie będzie odtwarzany.
- Scenariusz – podzielony na ujęcia, z długością wypowiedzi w sekundach.
- Tożsamość awatara – twarz, sylwetka, ubranie, paleta, tło.
- Głos – nagranie własne, klonowanie barwy lub synteza.
- Animacja – generowanie mówiącej głowy albo całego ciała.
- Kompozycja – podłożenie teł, grafiki, napisów, przejść.
- Kontrola jakości – przegląd ujęcie po ujęciu w zwolnionym tempie.
- Eksport i wersje – format poziomy, pionowy, kwadratowy, napisy i wersje językowe.
Co decyduje o jakości końcowej
Kolejność wpływu jest zaskakująco stała: scenariusz, dźwięk, mimika, oświetlenie, dopiero potem rozdzielczość. Widz wybaczy 1080p, ale nie wybaczy dźwięku, w którym zdania zlewają się w jeden ciąg bez oddechów. Dlatego w każdym projekcie warto najpierw dopracować tekst i głos, a dopiero potem walczyć o piksele.
Gdzie znika większość godzin
Nie w generowaniu. Najwięcej czasu pochłaniają poprawki spójności – gdy w piątym ujęciu awatar ma inną brodę, inne światło albo inną długość włosów. Rozwiązanie jest organizacyjne, nie technologiczne: zamrożenie referencji na starcie i trzymanie się ich przez cały projekt.
Projektowanie spójnej tożsamości wizualnej awatara
Awatar bez karty postaci to awatar, który rozjedzie się po trzecim ujęciu. Zanim wygenerujesz pierwszy kadr, przygotuj dokument opisujący postać w sposób, który da się powtarzać w promptach.
Karta postaci
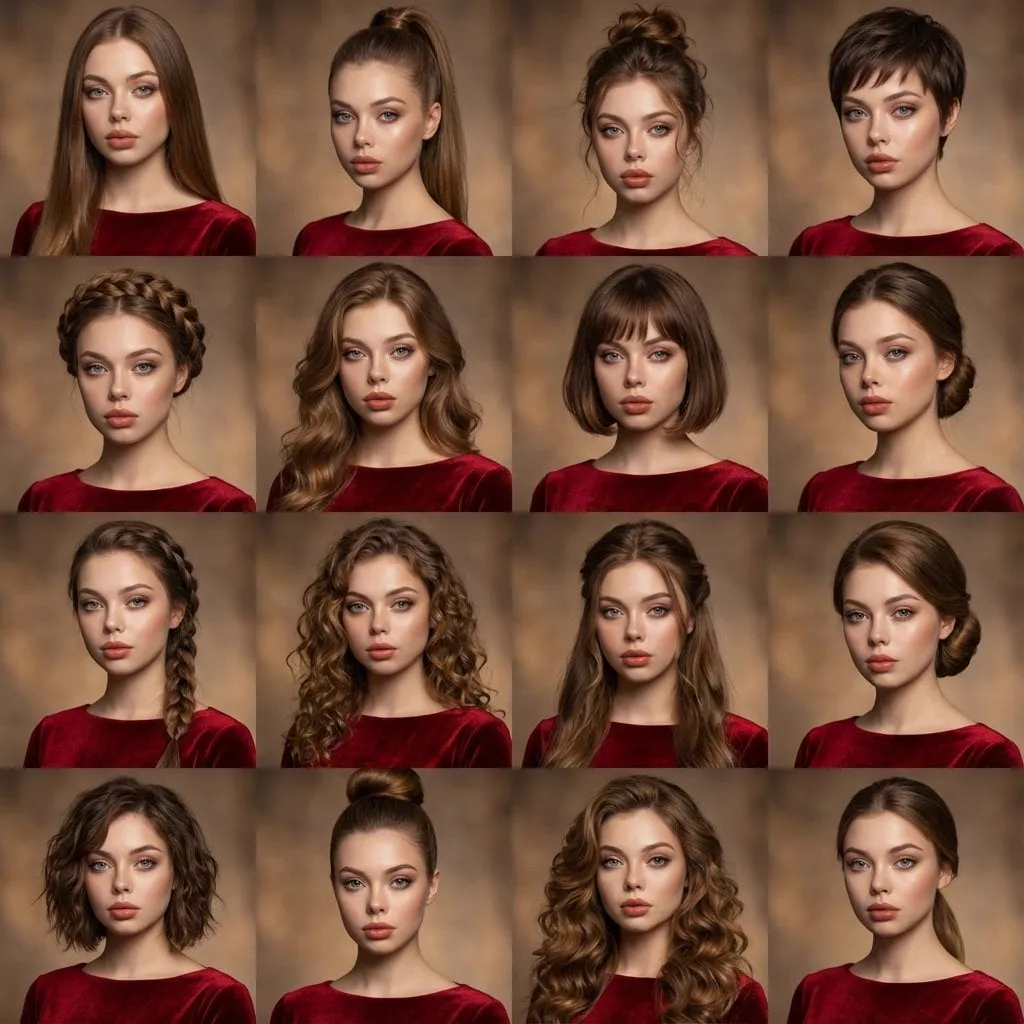
- Wiek wizualny i typ urody, forma włosów (długość, kolor, upięcie).
- Kształt twarzy, brwi, linia żuchwy, ewentualne znaki szczególne (piegi, blizna, okulary).
- Typ sylwetki i postawa, wysokość względem kadru.
- Dwie lub trzy stylizacje z dokładnym opisem ubrań i kolorów.
- Paleta barw marki i zasada jej stosowania w tle oraz w grafice.
- Zasady oświetlenia: miękki klucz z lewej, kontra z prawej, temperatura barwowa.
Spójność twarzy w praktyce
Najskuteczniejsze podejście to zestaw referencji: 5–15 zdjęć twarzy z różnych kątów, w neutralnym oświetleniu i bez mocnego makijażu. Na ich podstawie można wytrenować niewielki adapter stylu lub embedding, który będzie powtarzalny między sesjami. Jeśli nie chcesz trenować niczego, trzymaj stały seed, stały prompt bazowy i tę samą rozdzielczość generowania – zmiana rozdzielczości potrafi zmienić proporcje twarzy bardziej niż zmiana modelu.
Ubranie, tło i oświetlenie
Ubierz awatara raz, a potem zmieniaj tylko wtedy, gdy wymaga tego narracja. Widz zapamiętuje twarz razem z kolorem koszuli; nagła zmiana stroju w środku zdania czyta się jak błąd montażowy. Tło traktuj jak scenografię: biuro, studio, abstrakcyjny gradient – jedno na jedną serię materiałów. Oświetlenie musi pasować do tego samego kierunku we wszystkich ujęciach, inaczej postać wygląda, jakby była wklejona.
Modele i narzędzia: kryteria wyboru
Rynek narzędzi dzieli się na kilka rodzin, z których każda ma inny profil mocnych stron. Zamiast szukać "najlepszego", warto dopasować narzędzie do typu ujęcia.
| Typ narzędzia | Do czego się nadaje | Na co uważać |
|---|---|---|
| Generator wideo z tekstu | Ujęcia otwierające, b-roll, scenki bez dialogu | Trudna kontrola twarzy mówiącej, zmienność postaci |
| Generator obrazu w wideo | Animowanie konkretnego kadru, precyzyjny start | Ograniczona długość klipu, dryf stylu |
| Platforma awatarów mówiących | Wypowiedzi do kamery, szkolenia, prezentacje | Mniejsza swoboda inscenizacji, powtarzalny kadr |
| Silnik mowy | Lektor, klonowanie barwy, wersje językowe | Licencje na głos, wymowa nazw własnych |
| Narzędzie do montażu i kompozycji | Sklejanie, napisy, kolor, miks dźwięku | Ręczna praca przy wielu wariantach |
Sześć kryteriów decyzyjnych
- Kontrola – czy możesz wskazać klatkę początkową i końcową, ustawić ruch kamery, powtórzyć ten sam wynik.
- Spójność – jak zachowuje się twarz przy zmianie ujęcia i odległości od kamery.
- Czas iteracji – ile trwa jeden cykl generowania i czy można go przetestować taniej na niskiej rozdzielczości.
- Zgodność prawna – prawa do wykorzystania twarzy, głosu i muzyki w projekcie komercyjnym.
- Eksport i formaty – kanały alfa, wersje pionowe, pliki audio osobno.
- Współpraca – czy zespół może pracować równolegle nad tekstem, głosem i grafiką.
Kiedy łączyć kilka narzędzi
Najlepsze efekty daje hybryda: awatar mówiący generuje usta i mimikę, generator wideo dostarcza scenografie i b-roll, a montaż spina wszystko w całość. Trzeba tylko pilnować wspólnej palety i wspólnego oświetlenia, inaczej materiał będzie wyglądał jak kolaż z różnych produkcji.
Scenariusz i reżyseria wideo konwersacyjnego
Wideo konwersacyjne rządzi się swoimi prawami. Nie jest to wykład ani reklama – to rozmowa, w której jedna strona mówi, a druga ma wrażenie, że jest adresowana osobiście.
Struktura, która działa
- Pierwsze 3 sekundy: pytanie lub stwierdzenie dotyczące konkretnej sytuacji odbiorcy.
- Kolejne 15 sekund: obietnica wartości i kontekst, dlaczego to ważne teraz.
- Środek: dwa lub trzy punkty, każdy z konkretnym przykładem.
- Zakończenie: jedno jasne wezwanie do działania i informacja, co stanie się dalej.
Pisanie pod syntezę mowy
Syntezatory czytają świetnie zdania krótkie, a słabo – wielokrotnie złożone. Trzymaj się zasady: jedno zdanie, jedna myśl. Unikaj homografów i skrótów, które mogą zostać odczytane błędnie (np. "itd.", "np." – lepiej rozwinąć). Liczby zapisuj słownie, jeśli mają być czytane naturalnie. Wstawiaj przecinki w miejscach, gdzie chcesz pauzę, i kropki tam, gdzie chcesz oddech.
Notacja ujęć i prompty reżyserskie
Każde ujęcie opisz w jednej linii: typ planu, ruch kamery, emocja, długość. Przykład: "plan średni, kamera statyczna, ton spokojny, 6 s". Taki zapis można niemal dosłownie przenieść do promptu, a przy okazji staje się on listą kontrolną dla montażysty i dla osoby generującej wideo.
Audio, głos i lip-sync
Dźwięk to najczęstsze miejsce, w którym amatorska produkcja z awatarem rozsypuje się całkowicie. Nawet perfekcyjna mimika nie uratuje nagrania, w którym głos brzmi płasko, tempo jest zbyt szybkie, a usta nie trafiają w spółgłoski.
Własny głos, klonowanie czy synteza
Własny głos daje największą wiarygodność, ale wymaga dobrego nagrania – cichego pomieszczenia, mikrofonu pojemnościowego i konsekwentnej odległości od mikrofonu. Klonowanie barwy pozwala zachować rozpoznawalność przy produkcji masowej, jednak trzeba zadbać o zgodę osoby użyczającej głosu i o zapis tej zgody. Synteza jest najszybsza i najlepsza do wersji wielojęzycznych, ale wymaga starannego doboru barwy do tematu.
Dlaczego lip-sync się psuje
- Zbyt szybkie tempo – powyżej około 160 słów na minutę usta zaczynają się rozjeżdżać.
- Brak oddechów – mowa bez pauz brzmi mechanicznie, a animacja nie ma się o co zaczepić.
- Głosy z mocnym akcentem – model uczony na jednym typie wymowy może zniekształcać inne.
- Plozje i dźwięki wybuchowe – "p", "b", "m" wymagają widocznego zbliżenia warg, więc przy zbyt małym kadrze twarzy wyglądają sztucznie.
- Kompresja audio przed animacją – generuj usta z pliku WAV, nie z mocno skompresowanego MP3.
Miks i normalizacja
Docelowa głośność zależy od platformy, ale bezpieczny zakres dla materiałów internetowych to około -14 LUFS zintegrowanej głośności i szczyty nieprzekraczające -1 dBTP. Do tego delikatna kompresja, redukcja szumów i – jeśli materiał ma być odtwarzany w hałaśliwym otoczeniu – lekkie podbicie pasma 2–5 kHz dla zrozumiałości.
Kontrola klatki kluczowej, ruch i spójność między ujęciami
Kontrola klatki kluczowej to najprostszy sposób na zdyscyplinowanie generatora. Zamiast opisywać wszystko słowami, dostarczasz obraz pierwszej klatki – a generator tylko domyśla się resztę ruchu.
Trzy techniki, które warto znać
- Obraz do wideo – klatka startowa plus prompt ruchu. Idealne do pojedynczych, dopracowanych ujęć.
- Wideo do wideo – zachowanie ruchu z nagrania referencyjnego przy zmianie stylu lub postaci. Świetne do przenoszenia gestów.
- Pędzel ruchu – wskazanie obszaru, który ma się poruszać, i kierunku tego ruchu. Przydatny przy tle i elementach graficznych.
Jak utrzymać tę samą postać
Trzymaj jedną bibliotekę referencji, jeden seed, jeden prompt bazowy i jedną rozdzielczość. Nie zmieniaj dwóch rzeczy naraz – jeśli musisz poprawić światło, nie zmieniaj przy okazji fryzury. Generuj najpierw wersje testowe w niskiej jakości, zatwierdź kompozycję, a dopiero potem renderuj finał. To jedna z niewielu zasad, które realnie oszczędzają godziny.
Workflow krok po kroku: 60-sekundowy klip z awatarem
Poniższy scenariusz opisuje produkcję jednego minutowego materiału – na przykład wprowadzenia do produktu albo lekcji szkoleniowej.
- Brief na jednej stronie. Cel, grupa odbiorców, jeden komunikat główny, platforma docelowa.
- Scenariusz w sekundach. Podziel tekst na ujęcia po 4–8 sekund. Sześćdziesiąt sekund to zwykle osiem do dziesięciu ujęć.
- Karta postaci. Spisz wygląd, strój, tło i oświetlenie. Zapisz plik referencyjny w jednym folderze z projektem.
- Próbka głosu. Nagraj lub wygeneruj 30 sekund tekstu i odsłuchaj na słuchawkach oraz na telefonie.
- Animatik. Złóż wszystkie ujęcia z prowizorycznym dźwiękiem, żeby sprawdzić tempo i długość.
- Generowanie ujęć. Renderuj po jednym ujęciu, zapisując dla każdego prompt, seed i numer wersji.
- Selekcja. Odrzuć wszystko, co ma niepoprawną mimikę, rozmyte dłonie albo dryf twarzy.
- Lip-sync. Wygeneruj usta z pliku WAV o docelowym tempie mowy.
- Kompozycja. Dołóż napisy, elementy graficzne, delikatne przejścia i animacje tekstu.
- Miks dźwięku. Muzyka w tle maksymalnie 20 dB poniżej głosu, plus normalizacja.
- Kontrola jakości. Obejrzyj całość bez dźwięku, potem z dźwiękiem, potem w zwolnionym tempie na fragmentach z ustami.
- Eksport i wersje. Format poziomy, pionowy i kwadratowy, z napisami i bez, plus plik audio osobno.
Jeśli ten sam materiał ma powstać w pięciu językach, wszystkie kroki po szóstym powtarzasz wyłącznie dla ścieżki dźwiękowej i animacji ust – reszta pozostaje bez zmian.
Interaktywne wideo konwersacyjne: personalizacja i wdrożenia
Interaktywność to naturalne rozszerzenie formatu. Zamiast jednego nagrania publikujesz system, który odpowiada na pytania i dostosowuje treść.
Jak wygląda architektura
Nagranie użytkownika trafia do rozpoznawania mowy, tekst do modelu językowego, a odpowiedź do syntezy głosu i animacji awatara. Cała pętla musi zmieścić się w kilku sekundach, inaczej rozmowa traci naturalność. Najczęściej stosuje się trik z gotowymi klipami dla najczęstszych pytań i generowaniem na żywo tylko dla reszty – to radykalnie skraca opóźnienie i obniża koszt obliczeń.
Personalizacja, która nie jest nachalna
Imię, nazwa firmy, branża i wcześniejsze wybory to wystarczający zestaw zmiennych. Zbyt wiele zmiennych rozbija spójność wizualną i utrudnia kontrolę jakości. Bezpieczna zasada: maksymalnie pięć zmiennych w jednym szablonie, każda z krótką listą dopuszczalnych wartości.
Prywatność, zgody i etyka
Trzy rzeczy trzeba uregulować przed startem. Po pierwsze, pisemna zgoda każdej osoby, której twarz lub głos został użyty. Po drugie, jasna informacja dla widza, że materiał został wygenerowany. Po trzecie, zasady przechowywania nagrań i danych osobowych – zwłaszcza jeśli system przetwarza pytania użytkowników. Warto też zadbać o możliwość szybkiego wycofania materiału z obiegu, gdyby pojawiły się wątpliwości.
Skalowanie produkcji
Gdy jeden format działa, warto go uporządkować: biblioteka teł, biblioteka przejść, szablony napisów, gotowe warianty wezwań do działania i lista sprawdzonych promptów. Dzięki temu kolejne materiały powstają w godzinach, a nie w dniach – i to jest realna przewaga, jaką dają awatary AI.
Typowe błędy, checklista i FAQ
Osiem błędów, które psują najwięcej materiałów
- Generowanie bez karty postaci i bez referencji.
- Zmiana rozdzielczości i seeda w połowie projektu.
- Zbyt długie zdania w scenariuszu.
- Brak oddechów i pauz w ścieżce głosu.
- Usta animowane z pliku MP3 po ciężkiej kompresji.
- Światło w tle niezgodne z kierunkiem światła na twarzy.
- Zmiana stroju lub fryzury między ujęciami bez powodu fabularnego.
- Publikacja bez testu na telefonie i bez napisów.
Checklista przed eksportem
- Czy pierwsze trzy sekundy zawierają konkretną obietnicę?
- Czy tempo mowy mieści się w przedziale 130–160 słów na minutę?
- Czy twarz awatara jest identyczna we wszystkich ujęciach?
- Czy dłonie i przedmioty nie ulegają deformacji w ruchu?
- Czy napisy są czytelne na małym ekranie i nie zasłaniają ust?
- Czy głośność jest znormalizowana, a muzyka nie zagłusza głosu?
- Czy zgody na użycie twarzy i głosu są zapisane?
FAQ
Ile trwa produkcja minutowego materiału z awatarem?
Przy gotowym scenariuszu i karcie postaci realistyczny czas to od trzech do ośmiu godzin, licząc iteracje generowania, selekcję i montaż. Pierwszy projekt w nowym narzędziu zwykle zajmuje dwa razy dłużej.
Czy potrzebuję własnego wideo, żeby zrobić awatara?
Nie zawsze. Jeśli chcesz odwzorować konkretną osobę, potrzebujesz materiału referencyjnego i zgody. Jeśli tworzysz postać fikcyjną, wystarczy opis i wygenerowane zdjęcia referencyjne.
Dlaczego usta nie trafiają w dźwięk?
Najczęstsze przyczyny to zbyt szybkie tempo mowy, brak pauz, kompresja audio przed animacją oraz zbyt mały kadr twarzy, w którym nie widać pracy warg.
Czy awatar może mówić po polsku bez akcentu?
Tak, jeśli dobierzesz silnik mowy z rodzimym głosem i sprawdzisz wymowę nazw własnych oraz liczb. Warto przygotować listę trudnych słów i przetestować je przed pełnym renderem.
Jaki format pliku audio dawać do animacji ust?
Bezstratny lub o wysokim bitrate, mono, 48 kHz. Plik WAV znacząco poprawia precyzję ruchu warg w porównaniu z mocno skompresowanym MP3.
Jak uniknąć efektu sztuczności?
Miksuj realistyczne elementy – naturalne oddechy, drobne ruchy głowy, mruganie, lekkie odchylenia od idealnej symetrii – i unikaj perfekcyjnie równego tempa wypowiedzi.
Czy można użyć tej samej postaci w kilku kampaniach?
Tak, pod warunkiem że trzymasz się tej samej karty postaci i biblioteki referencji. Spójność postaci jest dziś silniejszym elementem rozpoznawalności niż samo logo.
Awatary AI i wideo konwersacyjne przestały być ciekawostką technologiczną, a stały się normalnym narzędziem produkcji. Wygrywają ci, którzy traktują je jak proces: krótki scenariusz, konsekwentna postać, dopracowany dźwięk i uporządkowana biblioteka zasobów. Zacznij od jednego minutowego materiału, zamroź referencje, zapisz każdy prompt razem z seedem – a drugi i dziesiąty klip powstaną już znacznie szybciej.
