
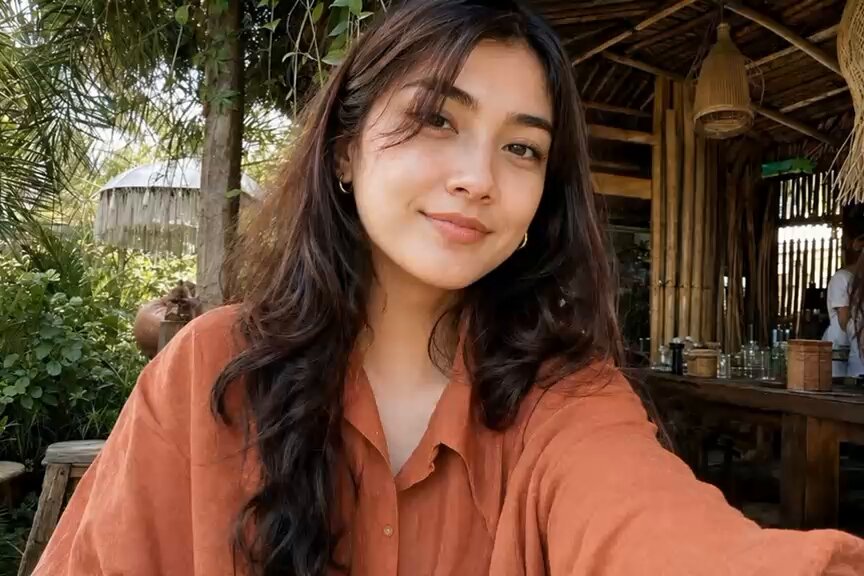
Le vrai obstacle : la persistance d'identité
Passer d'une idée à une vidéo générée par IA est aujourd'hui facile sur un plan isolé de dix secondes. Tenir le même visage, la même coiffure, la même veste et la même morphologie sur vingt plans relève en revanche d'un travail d'ingénierie. Un modèle génératif n'a pas de mémoire : chaque inférence repart d'un bruit aléatoire et reconstruit le monde à partir du prompt et des images fournies. Ce qui paraît identique à l'œil humain — une fossette, une mèche rebelle, la couture d'une manche — n'est qu'une reconstruction probabiliste, différente à chaque passage.
Trois conséquences en découlent, et elles structurent tout le reste de cet article :
- La cohérence se construit dans les données d'entrée bien plus que dans les mots du prompt.
- Un personnage stable coûte surtout du temps de préparation, pas du temps de génération.
- La qualité perçue d'une vidéo narrative est presque toujours limitée par la cohérence, jamais par le niveau de détail photoréaliste.
La bonne nouvelle : le problème est soluble avec une méthode reproductible. La mauvaise : improviser plan par plan ne fonctionne pas. Il faut traiter la cohérence comme une chaîne de production, avec des étapes, des points de contrôle et des critères d'acceptation.
Construire la fiche d'identité visuelle avant de générer
Avant d'ouvrir le moindre outil de génération vidéo, préparez un document que nous appellerons la fiche d'identité visuelle. C'est le référentiel unique du personnage : sans lui, chaque essai réintroduit une interprétation différente.
Choisir les bonnes images de référence
Une référence utile n'est pas une belle image, c'est une image informatique : elle doit décrire la structure du personnage sous un angle que le modèle ne connaît pas encore.
- Face neutre, lumière douce : indispensable comme ancre principale.
- Trois-quarts gauche et trois-quarts droit : le modèle apprend la profondeur du visage.
- Profil : verrouille le nez, la mâchoire, l'implantation des cheveux.
- Plan large du corps entier : stabilise les proportions et la silhouette.
- Détail vestimentaire : matière, couleur exacte, accessoires récurrents.
Cinq à huit images suffisent. Au-delà de dix, les modèles multi-références commencent à mélanger les traits et à produire des visages composites. En dessous de trois, l'identité reste flottante.
Normaliser lumière, cadrage et arrière-plan
Le piège classique : quatre références prises dans quatre ambiances différentes. Le modèle interprète alors les variations d'éclairage comme des différences physiques et fabrique un personnage qui change de carnation entre deux plans.
Normalisez au maximum :
- Même température de couleur sur toutes les références.
- Même distance focale apparente, pour éviter les déformations de perspective.
- Fond neutre ou uni, sans élément qui pourrait être recopié par erreur.
- Expression neutre, bouche fermée, regard caméra sur au moins une image.
Rédiger une description canonique courte
La fiche contient aussi un bloc de texte de 40 à 70 mots, réutilisé mot pour mot dans chaque prompt. Exemple :
Femme d'environ trente ans, cheveux châtain foncé mi-longs attachés en queue basse, peau claire légèrement olive, yeux noisette, visage ovale, mâchoire douce, petite cicatrice de deux centimètres au-dessus du sourcil droit. Veste en toile bleu nuit, col droit, boutons métalliques mats. Aucun bijou.
Ce bloc est votre contrat. Ne le reformulez jamais d'un plan à l'autre : les synonymes dérivent, et chaque dérive se voit à l'écran.
Comprendre ce que fait réellement une fusion multi-images
La fusion multi-images consiste à fournir au modèle plusieurs vues d'un même sujet pour qu'il en déduise une représentation interne stable, puis à générer une vidéo qui respecte cette représentation. Le mécanisme se décompose en trois temps.
Encodage et alignement des références
Chaque image est encodee dans un espace latent. Le modèle tente ensuite d'aligner ces latents sur des points d'intérêt communs : contours du visage, lignes des épaules, position des yeux. Si les images sont incohérentes entre elles, l'alignement échoue silencieusement et le résultat devient une moyenne floue.
C'est pourquoi une référence mal cadrée peut contaminer tout le lot. Testez toujours un lot de références sur un plan court avant de lancer une séquence complète.
Fusion conditionnelle et pondération implicite
Le modèle attribue un poids à chaque référence. Ce poids dépend de la netteté, de la frontalité et de la taille relative du sujet dans l'image. Une photo de groupe où le personnage occupe 15 % du cadre aura beaucoup moins d'influence qu'un portrait serré. Si vous voulez qu'un détail précis — une coiffure, une texture de tissu — soit respecté, isolez-le dans une référence dédiée.
Multi-références contre image-vers-vidéo simple
| Approche | Force | Limite | Quand l'utiliser |
|---|---|---|---|
| Image-vers-vidéo simple | Très stable localement | Aucune mémoire entre les plans | Plans uniques, inserts, gros plans |
| Fusion multi-images | Identité persistante | Sensible à la qualité des références | Séries de plans avec le même héros |
| Référence unique + description | Rapide à mettre en place | Dérive après quelques plans | Prototypes et storyboards animés |
La règle pratique : dès qu'un personnage revient dans plus de deux plans, passez en fusion multi-images.
Le pipeline en cinq étapes, du concept à l'écran
Voici une méthode qui fonctionne quel que soit l'outil, parce qu'elle ne dépend pas d'une interface mais d'un ordre d'opérations.
Étape 1 — Découpage et inventaire des plans
Listez chaque plan avec quatre informations : durée, cadrage, action, présence du personnage. Ce tableau révèle immédiatement les plans à risque, généralement les profils, les arrière-plans chargés et les mouvements rapides. Traitez-les en priorité, pas à la fin.
Étape 2 — Génération des images clés fixes
Avant l'animation, produisez une image fixe validée pour chaque plan. Comparer vingt images fixes est infiniment plus rapide que comparer vingt vidéos. C'est ici que vous corrigez l'identité : vous itérez sur les références, la description canonique et les paramètres de style jusqu'à obtenir une planche cohérente.
Point de contrôle : placez les images côte à côte. Si vous devez hésiter pour reconnaître le personnage, ne passez pas à l'étape suivante.
Étape 3 — Animation plan par plan
Animez à partir de l'image validée, jamais depuis un prompt texte seul. Chaque plan doit hériter de la même image d'ancrage ou de la même grappe de références. Limitez l'amplitude du mouvement : les rotations de tête supérieures à 45 degrés et les passages rapides devant la caméra sont les premiers générateurs d'incohérence.
Étape 4 — Continuité entre les plans
Deux techniques complémentaires :
- Raccord par dernière image : utilisez la dernière image d'un plan comme première image du suivant. La continuité devient mécanique.
- Raccord par keyframe partagée : définissez une image intermédiaire commune que les deux plans doivent traverser.
La seconde méthode coûte plus de calcul mais élimine les sauts de costume et d'éclairage.
Étape 5 — Contrôle qualité et reprises ciblées
Ne régénérez jamais un plan entier pour un défaut de main ou de bouche. Recadrez le problème : un plan de deux secondes suffit souvent à vérifier un détail. Reprenez par ordre de gravité visible : visage, mains, textile, arrière-plan.
Prompt engineering : écrire pour la stabilité, pas pour l'effet
Les prompts spectaculaires produisent des images spectaculaires et des séquences incohérentes. En production, la sobriété gagne.
La structure en quatre blocs
- Bloc identité : la description canonique, copiée à l'identique.
- Bloc action : un seul verbe principal, une seule direction de mouvement.
- Bloc caméra : cadrage, focale perçue, mouvement d'appareil.
- Bloc lumière et décor : deux ou trois éléments maximum.
Exemple de formulation stable :
[Bloc identité]. Elle marche lentement vers la gauche, tête légèrement tournée vers l'appareil. Plan poitrine, focale 50 mm, caméra en léger travelling latéral. Fin d'après-midi, lumière douce latérale, mur de briques flou en arrière-plan.
Le style transfert inversé
Quand vous partez d'une vidéo existante pour retrouver son étalonnage, travaillez en sens inverse : décrivez d'abord la lumière, puis la palette, puis le grain. Un ordre inverse — grain avant lumière — produit des rendus contradictoires. Retenez trois adjectifs par catégorie, pas plus. Au-delà, le modèle tire au hasard dans la liste.
Les mots qui déstabilisent
Certains termes sont à éviter dans un pipeline où l'identité compte : transforme, métaformose, devient, change de, évolue vers. Ils autorisent le modèle à modifier la structure du sujet. Gardez-les pour un effet volontaire, jamais dans un plan neutre.
Keyframes et contrôle temporel du mouvement
Le contrôle temporel est ce qui distingue un amateur d'un professionnel. Une keyframe est un état visuel imposé à un instant précis. Bien utilisée, elle transforme une animation aléatoire en chorégraphie.
Trois façons d'utiliser les keyframes
- Keyframe de départ : verrouille la pose initiale. Utile pour les entrées de champ.
- Keyframe intermédiaire : impose un passage obligé, par exemple la main qui atteint la poignée.
- Keyframe de fin : garantit que le plan se termine sur une image exploitable pour le montage suivant.
Calibrer l'amplitude
Comptez en secondes et en degrés. Un plan de cinq secondes supporte confortablement un déplacement de deux pas ou une rotation de tête de 30 degrés. Un plan de deux secondes ne supporte presque rien : c'est un plan d'insert, pas un plan d'action. La plupart des incohérences viennent d'une action trop complexe placée dans une durée trop courte.
Travailler le mouvement de caméra
Le mouvement d'appareil doit être décrit séparément du mouvement du sujet, et un seul des deux doit dominer. Sujet qui marche plus caméra qui tourne plus zoom plus changement de focale : quatre variables simultanées, c'est une garantie d'échec. Choisissez-en une principale, éventuellement une secondaire très discrète.
Choisir le modèle selon la scène, pas selon la mode
Les modèles disponibles ont des profils différents. Plutôt que de chercher un classement absolu, évaluez chaque option sur les critères qui comptent pour votre projet.
| Besoin dominant | Profil de modèle à privilégier |
|---|---|
| Réalisme physique, mouvements crédibles | Modèles orientés simulation et cohérence gravitaire |
| Sujet unique répété sur plusieurs plans | Modèles multi-références avec forte fidélité d'entrée |
| Style graphique marqué, animation | Modèles à stylisation forte et contrôle de start frame |
| Plans longs sans coupe | Modèles à mémoire temporelle étendue |
| Rapidité d'itération | Modèles légers, résolution modérée |
Critères de décision concrets
- Fidélité d'entrée : le modèle respecte-t-il les références ou invente-t-il un visage voisin ?
- Stabilité temporelle : le visage se déforme-t-il au bout de trois secondes ?
- Contrôle : pouvez-vous fournir une image de départ, une image de fin, une keyframe ?
- Résolution native : évitez d'upscaler, cela lisse les traits et casse l'identité.
- Reproductibilité : le même prompt redonne-t-il un résultat proche ?
Testez toujours avec la même grappe de références sur trois modèles. Le classement obtenu sur votre personnage précis vaut mieux que n'importe quelle comparaison générique.
Les erreurs fréquentes et leurs correctifs
Le visage change entre deux plans
Cause la plus probable : références incohérentes en éclairage. Correctif : reconstruire un lot normalisé, puis retester sur un plan court. Si le problème persiste, la description canonique contient un terme trop vague, souvent une couleur ou une coiffure.
Les mains deviennent des formes floues
Les mains restent un point faible général. Correctif : cadrez plus serré, évitez les mains en avant-plan, réduisez la vitesse du geste, ou utilisez un plan de coupe qui masque l'action.
Le costume change de teinte
Cause : la lumière de la scène modifie l'interprétation de la couleur par le modèle. Correctif : nommez la couleur dans la description canonique et répétez-la dans le bloc lumière du prompt.
L'arrière-plan se met à bouger
Cause : trop d'éléments décrits. Correctif : trois éléments maximum, dont un seul animé. Le reste doit rester explicitement statique.
La séquence devient molle
Cause inverse : vous avez tellement verrouillé la stabilité que le mouvement a disparu. Correctif : ajoutez un micro-mouvement précis au sujet — respiration, pas, rotation d'épaule — plutôt qu'un mouvement de caméra ample.
Le personnage rétrécit ou grandit
Cause : changement de focale perçue entre deux plans. Correctif : fixez une focale par séquence et indiquez la distance caméra-sujet dans la fiche d'identité.
FAQ : cohérence de personnage et fusion multi-images
Combien d'images de référence faut-il vraiment ?
Cinq est un bon point de départ, huit un plafond raisonnable. La qualité et la cohérence du lot comptent plus que la quantité.
Faut-il générer les images fixes avec le même modèle que la vidéo ?
Pas nécessairement, mais il faut que le rendu final soit compatible. Un écart de grain ou de colorimétrie entre la référence et le style cible se traduit toujours par une perte de fidélité.
Le prompt négatif aide-t-il ?
Pour l'identité, peu. Il est plus utile pour écarter des artefacts récurrents — mains déformées, texte parasite, membres supplémentaires.
Peut-on mélanger plusieurs modèles dans une même séquence ?
Oui, à condition de passer par des raccords d'images. Sans image de liaison, le spectateur perçoit immédiatement la rupture de rendu.
Combien de temps faut-il prévoir ?
Comptez environ 60 % du temps total sur la préparation des références et des images fixes, 25 % sur l'animation, 15 % sur les reprises.
Comment gérer deux personnages dans la même scène ?
Traitez-les comme deux grappes de références distinctes, et réservez une référence par personnage pour le plan de groupe. Les scènes à deux personnages restent le cas le plus difficile : limitez leurs interactions physiques et privilégiez les champs-contrechamps.
Faut-il upscaler les plans générés ?
Le moins possible. Un upscale agressif lisse la peau, gomme les micro-détails distinctifs et réduit la reconnaissance du personnage. Privilégiez une résolution native suffisante dès la génération.
Checklist de production à garder sous les yeux
- Fiche d'identité visuelle rédigée et gelée avant toute génération.
- Cinq à huit références normalisées, sans variation d'éclairage.
- Description canonique de 40 à 70 mots, copiée à l'identique.
- Images fixes validées plan par plan avant l'animation.
- Une seule action principale et une seule variable de caméra par plan.
- Keyframes de départ et de fin définies pour les plans de liaison.
- Focale perçue constante dans une même séquence.
- Reprises ciblées sur des extraits courts, jamais sur la séquence entière.
- Contrôle final : avez-vous reconnu le personnage sans hésiter sur chaque plan ?
La cohérence n'est pas un réglage magique, c'est une discipline de préparation. Les équipes qui obtiennent des séquences crédibles ne disposent pas d'un meilleur modèle : elles disposent d'un meilleur référentiel, d'un pipeline ordonné et de points de contrôle stricts. Une fois cette structure en place, la fusion multi-images devient un outil fiable plutôt qu'une loterie, et le passage du concept à l'écran cesse d'être un pari pour devenir un processus reproductible semaine après semaine.
