
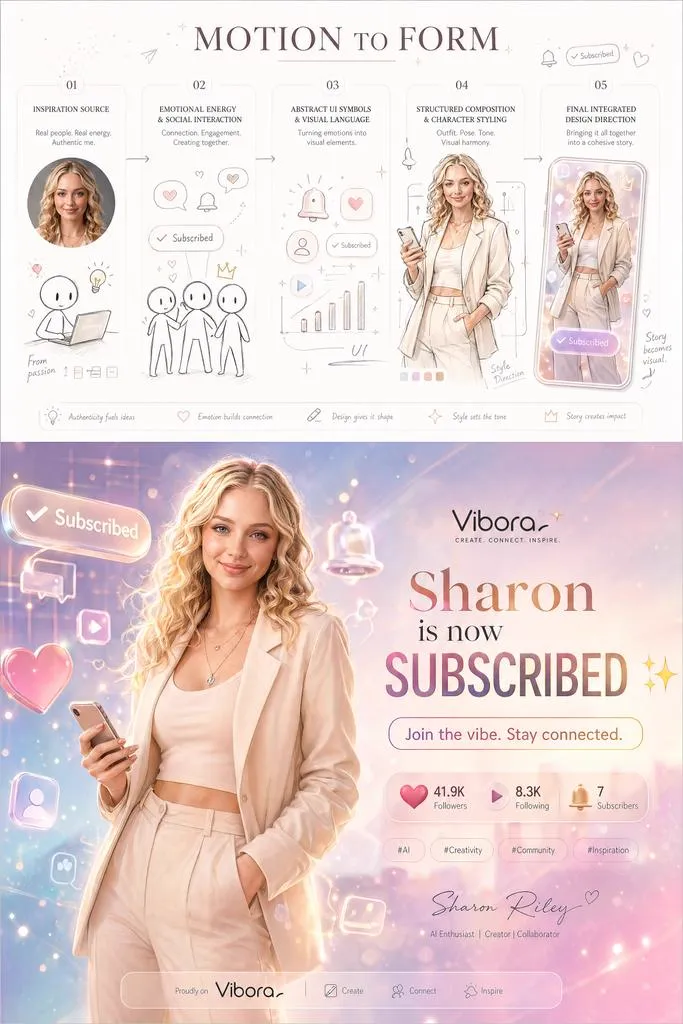
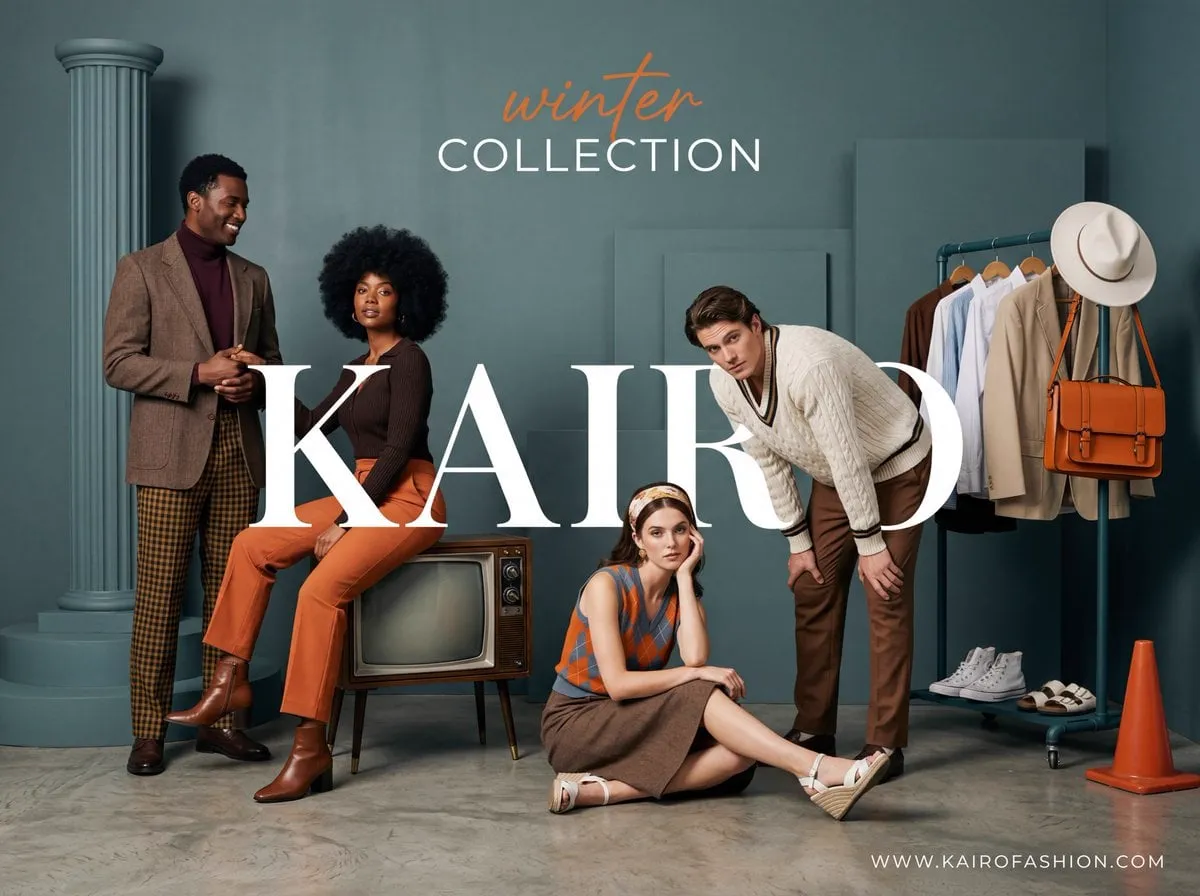
La creación de vídeo con inteligencia artificial ha alcanzado un nivel en el que ya no basta con generar un clip aislado impresionante. El verdadero reto profesional es mantener la identidad de un personaje a lo largo de múltiples planos, escenas y secuencias. Cuando el rostro, la ropa o el estilo cambian entre tomas, la narrativa pierde credibilidad. Este artículo explica cómo lograr consistencia de personajes mediante técnicas de fusión de imágenes, flujos de trabajo reproducibles y criterios de decisión prácticos.
Por qué falla la consistencia de personajes en vídeo IA
La deriva de identidad (identity drift) es el fenómeno por el cual un personaje generado por IA cambia sutilmente de un plano a otro. En un primer plano, el personaje puede tener ojos verdes y una cicatriz en la ceja; en un plano medio, los ojos se vuelven marrones y la cicatriz desaparece. Este tipo de inconsistencia rompe la inmersión y delata que el vídeo está generado por máquina.
Las causas son múltiples. La más común es la falta de anclaje visual: el modelo recibe una descripción textual, pero no una referencia concreta del rostro. Otra causa frecuente es el cambio de semilla aleatoria entre generaciones. La semilla controla el ruido inicial; si cambia, el modelo parte de un estado latente distinto y la identidad se desplaza. También influyen los prompts contradictorios, la iluminación inconsistente y la mezcla de estilos artísticos.
La coherencia no es solo facial. Incluye vestuario, peinado, proporciones corporales, edad aparente, textura de piel y paleta de color. Si el personaje lleva una chaqueta roja en el plano 1 y azul en el plano 3, el espectador lo nota. Lo mismo ocurre con el peinado: una coleta alta que se convierte en melena suelta sin explicación narrativa.
Existe además la coherencia temporal dentro de un mismo plano. Los modelos de vídeo pueden producir parpadeos, morphing o cambios de forma en la cara mientras el personaje se mueve. Esto se debe a que el modelo intenta mantener la continuidad del movimiento, pero no tiene suficiente información sobre la identidad. La fusión multi-imagen ayuda a reducir este problema al proporcionar varios puntos de referencia estables.
Para diagnosticar el problema, conviene revisar fotograma a fotograma. Si la deriva ocurre en los extremos del encuadre, probablemente falten referencias de perfil. Si ocurre con movimientos rápidos, el modelo necesita más peso en la referencia o menos intensidad de movimiento. Si ocurre al cambiar de escenario, el prompt de fondo está contaminando la identidad del personaje.
Fundamentos técnicos de la fusión multi-imagen
La fusión multi-imagen es el proceso de combinar varias imágenes de referencia en una representación que el modelo utiliza como condición. En lugar de depender de una sola foto, se aportan varios ángulos, expresiones y detalles. Esto reduce la ambigüedad y permite que el modelo infiera qué rasgos son esenciales y cuáles son accidentales.
A nivel técnico, existen tres enfoques principales. El primero es la concatenación de entradas: se pasan varias imágenes como canales adicionales y el modelo aprende a extraer características comunes. El segundo es la fusión a nivel de características: se calculan embeddings de cada imagen y se combinan mediante atención cruzada. El tercero es la fusión latente: se mezclan los vectores latentes antes de la difusión. Herramientas como IP-Adapter, ControlNet, ReferenceNet y FaceID implementan variantes de estos enfoques.
En vídeo, la fusión multi-imagen puede aplicarse de dos maneras. La primera es como keyframes: se proporcionan imágenes clave en momentos concretos y el modelo interpola. La segunda es como condición global: la referencia se aplica a todos los fotogramas. La segunda opción es más estable para la identidad, pero puede limitar la expresividad. La primera permite más variación, pero exige un control cuidadoso de las transiciones.
Otro concepto clave es la fuerza de referencia (reference strength). Este parámetro controla cuánto influye la imagen de referencia en la generación. Un valor bajo permite más creatividad del modelo, pero arriesga la identidad. Un valor alto mantiene el parecido, pero puede producir rigidez o artefactos. Lo habitual es empezar en 0.7 y subir hasta 0.9 si es necesario.
La semilla (seed) también importa. Fijar la misma semilla entre planos ayuda a mantener la estructura general, pero no garantiza la identidad. La semilla controla el ruido, no el contenido semántico. Por eso, la combinación de semilla fija más referencias multi-imagen es más robusta que cualquiera de las dos por separado.
La coherencia de estilo es otro pilar. No basta con que el personaje sea el mismo; la iluminación, la paleta, el grano y la profundidad de campo deben ser consistentes. Si un plano tiene luz cálida de atardecer y el siguiente tiene luz fría de fluorescente, el espectador sentirá un salto. Para evitarlo, conviene definir un look visual y aplicarlo en todos los prompts.
Cómo afecta la resolución y el formato
Las imágenes de referencia deben tener una resolución suficiente. Si son demasiado pequeñas, el modelo no podrá extraer detalles finos como el color de ojos o la forma de la nariz. Se recomienda un mínimo de 1024×1024 píxeles. El formato ideal es PNG sin pérdida o JPEG de alta calidad. Evita capturas de pantalla comprimidas o imágenes con marcas de agua.
El papel del prompt textual
El prompt textual sigue siendo importante. La referencia visual no sustituye la descripción; la complementa. Un prompt bien estructurado incluye: nombre o identificador del personaje, edad, etnia, color y estilo de pelo, color de ojos, complexión, vestuario, expresión, acción, entorno, tipo de plano y lente. Mantén esta estructura idéntica en todos los planos y cambia solo la acción y el entorno.
Cómo preparar un kit de referencias de personaje
Un kit de referencias bien construido es la base de la consistencia. No necesitas cientos de imágenes; con cuatro a seis bien elegidas suele ser suficiente. La clave está en la variedad controlada: diferentes ángulos, pero misma identidad.
Primero, reúne las siguientes tomas: frontal neutro, perfil izquierdo, perfil derecho, tres cuartos, cuerpo completo y una expresión sonriente. Si el personaje tiene un peinado que cambia según la escena, añade una referencia por peinado. Si lleva gafas o sombrero, incluye una toma con y otra sin el accesorio para que el modelo aprenda a separar identidad de vestuario.
Segundo, cuida la iluminación. Usa luz suave y uniforme, preferiblemente de estudio o de ventana difusa. Evita sombras duras que oculten rasgos. El fondo debe ser neutro y limpio, sin elementos que distraigan. Un fondo gris claro o blanco roto funciona bien.
Tercero, evita accesorios que tapen el rostro. Gafas de sol, bufandas altas, mascarillas o flequillos extremos dificultan la extracción de rasgos. Si el personaje los lleva en la historia, crea una referencia separada para esas escenas.
Cuarto, crea una ficha de personaje. Incluye nombre, edad, etnia, altura, complexión, color de pelo, tipo de peinado, color de ojos, rasgos distintivos (cicatrices, lunares, tatuajes), vestuario principal y paleta de color. Esta ficha se convertirá en la base de todos los prompts.
Quinto, prueba la consistencia. Genera diez variaciones con la misma referencia y compáralas visualmente. Si la identidad se mantiene en al menos ocho, el kit es sólido. Si no, añade más ángulos o mejora la calidad de las imágenes.
Ejemplo de ficha de personaje
Nombre: Ana. Edad: 30 años. Etnia: caucásica. Pelo: castaño, recogido en coleta baja. Ojos: verdes. Complexión: media, atlética. Rasgo distintivo: pequeña cicatriz en la ceja derecha. Vestuario principal: chaqueta de jean azul, camiseta blanca, vaqueros oscuros. Paleta: azules fríos, blancos, marrones suaves. Estilo visual: realista cinematográfico, grano fino, lente 35mm.
Con esta ficha, el prompt base puede ser: «Ana, 30 años, caucásica, pelo castaño en coleta baja, ojos verdes, cicatriz en ceja derecha, chaqueta de jean azul, camiseta blanca, vaqueros oscuros, iluminación suave, fondo neutro, 35mm». A partir de ahí, solo cambias la acción y el entorno.
Flujo de trabajo paso a paso para escenas coherentes
Un flujo reproducible evita improvisaciones. Estos son los pasos que puedes seguir.
Paso 1: Genera el personaje base con texto a imagen. Usa una semilla fija y un prompt detallado. Itera hasta obtener un rostro que te satisfaga. Guarda la imagen y la semilla.
Paso 2: Refina con imagen a imagen. Usa una fuerza de denoising baja (0.3-0.5) para mantener la identidad mientras ajustas iluminación o expresión. Genera varias versiones: frontal, perfil, tres cuartos. Estas serán tus referencias.
Paso 3: Exporta las referencias finales en alta calidad. Nómbralas de forma clara: ana_frontal.png, ana_perfil.png, etc.
Paso 4: Configura el modelo de vídeo. Sube las referencias en el panel de personaje o como imágenes de entrada. Ajusta la fuerza de referencia entre 0.7 y 0.9. Fija la semilla si el modelo lo permite.
Paso 5: Escribe el prompt de la escena. Mantén la descripción del personaje idéntica al prompt base. Añade la acción, el entorno, el tipo de plano y la lente. Por ejemplo: «Ana, 30 años, caucásica, pelo castaño en coleta baja, ojos verdes, cicatriz en ceja derecha, chaqueta de jean azul, camiseta blanca, vaqueros oscuros, sentada en una cafetería junto a la ventana, luz natural, plano medio, 35mm».
Paso 6: Genera clips cortos de 3 a 5 segundos. Revisa el resultado. Si hay deriva, aumenta la fuerza de referencia o reduce la intensidad de movimiento. Si el personaje se ve rígido, baja ligeramente la fuerza de referencia.
Paso 7: Para planos más largos, divide la acción en tomas más pequeñas y únelas en edición. Usa transiciones que no llamen la atención: cortes directos, fundidos suaves o barridos.
Paso 8: Aplica interpolación de fotogramas si es necesario. Esto suaviza el movimiento y reduce el parpadeo. Muchos editores de vídeo incluyen esta función.
Paso 9: Realiza una corrección de color final. Unifica la paleta, el contraste y la temperatura de color. Añade grano o viñeteado si forma parte del estilo.
Ajustes recomendados
CFG scale: 6-8. Un valor demasiado alto puede producir artefactos; demasiado bajo, poca adherencia al prompt. Motion strength: 0.4-0.7. Para escenas de acción, sube a 0.8. Steps: 30-50. Más pasos no siempre mejoran; a partir de 50 el retorno es mínimo. Reference strength: 0.7-0.9. Seed: fija siempre que sea posible.
Herramientas y modelos para fusionar imágenes y mantener identidad
Existen varias opciones en el mercado. Cada una tiene fortalezas y limitaciones. La elección depende de tu nivel de control, presupuesto computacional y tipo de proyecto.
Midjourney ofrece una función de referencia de personaje que permite mantener rasgos faciales y de vestuario. Es útil para generar stilts y luego animarlos en otro modelo. Su punto fuerte es la calidad estética; su punto débil, el control granular.
Stable Diffusion con ComfyUI es la opción más flexible. Permite usar IP-Adapter, ControlNet OpenPose, FaceID y otros nodos. Puedes construir un pipeline personalizado que combine múltiples referencias. Requiere curva de aprendizaje y una GPU potente, pero ofrece control total.
Kling AI ha incorporado referencias de personaje y elementos. Permite subir varias imágenes y mantener la identidad en escenas generadas. Es rápido y accesible desde la nube. Ideal para creadores que no quieren configurar infraestructura local.
Runway Gen-3 ofrece imagen a vídeo con coherencia aceptable. Su interfaz es sencilla y los resultados son cinematográficos. Para consistencia estricta, conviene combinarlo con referencias externas.
Pika permite usar ingredientes de escena e imágenes de referencia. Es útil para prototipos rápidos y animaciones estilizadas.
Luma Dream Machine trabaja bien con keyframes. Puedes proporcionar un fotograma inicial y otro final, y el modelo interpola. Esto ayuda a controlar la identidad en transiciones.
Otros modelos como Sora, Veo o Haiper avanzan rápidamente. Algunos permiten descripciones muy detalladas y coherencia de personaje en planos largos. La recomendación es probar varios y quedarte con el que mejor se adapte a tu flujo.
Un enfoque híbrido suele dar los mejores resultados: genera los stilts del personaje en un modelo de imagen (Midjourney, Stable Diffusion), refínalos en un editor, y luego anima en un modelo de vídeo con referencias. Para el estilo final, aplica una etapa de corrección de color en un editor tradicional.
Criterios de decisión para elegir un enfoque
No existe una solución única. Estos son los factores que debes considerar.
Nivel de realismo: si buscas fotorrealismo extremo, necesitarás modelos con alta fidelidad facial y posiblemente entrenar un LoRA. Si el estilo es ilustrado o estilizado, las referencias multi-imagen son suficientes.
Control granular: si necesitas ajustar cada fotograma, Stable Diffusion + ComfyUI es la mejor opción. Si prefieres rapidez, un modelo en la nube con referencia de personaje es más práctico.
Velocidad: para prototipos, usa modelos rápidos y no te obsesiones con la perfección. Para producción final, invierte tiempo en el kit de referencias y en la revisión fotograma a fotograma.
Presupuesto computacional: los pipelines locales requieren GPU. Los modelos en la nube cobran por uso, pero eliminan la inversión inicial en hardware. Evalúa cuántas generaciones necesitas al mes.
Curva de aprendizaje: ComfyUI es potente pero complejo. Las interfaces simplificadas son más fáciles, pero ofrecen menos control. Elige según tu experiencia técnica.
Escalabilidad: si vas a producir una serie con muchos episodios, invierte en un pipeline reproducible y en un kit de referencias bien documentado. Si es un proyecto único, puedes ser más pragmático.
Coherencia de estilo: define una paleta, un tipo de iluminación y un grano. Aplícalos en todos los prompts. Si cambias de modelo a mitad del proyecto, el estilo puede romperse. Lo ideal es mantener un modelo principal y usar otros solo para tareas auxiliares.
Matriz de decisión simplificada
Si necesitas realismo y control total: Stable Diffusion + ComfyUI + IP-Adapter + LoRA. Si necesitas rapidez y buena calidad: Kling AI o Runway con referencias. Si es estilizado: Midjourney + animación en Pika o Luma. Si es un proyecto híbrido: genera stilts en SD, anima en Kling, edita en un editor tradicional.
Errores comunes y cómo evitarlos
Error 1: Cambiar la semilla entre planos. Solución: fija la semilla siempre que el modelo lo permita.
Error 2: Usar referencias de baja calidad. Solución: invierte en imágenes nítidas, bien iluminadas y sin compresión.
Error 3: Mezclar estilos de iluminación. Solución: define un look y respétalo. Si un plano es de día y otro de noche, ajusta el prompt para que la luz sea coherente con la escena, pero mantén la dirección y la temperatura general.
Error 4: Prompt demasiado largo y contradictorio. Solución: sé específico pero conciso. Elimina adjetivos que no aportan.
Error 5: No fijar el vestuario. Solución: describe la ropa exacta en cada prompt. Si cambia, que sea intencional y narrativo.
Error 6: Ignorar la coherencia de fondo. Solución: el fondo también debe mantener estilo y paleta. Si el personaje se mueve, el entorno debe ser consistente.
Error 7: No revisar fotograma a fotograma. Solución: revisa el vídeo completo antes de dar por bueno un plano. La deriva puede aparecer en un solo fotograma.
Error 8: Usar una sola referencia para ángulos extremos. Solución: incluye perfiles y tres cuartos en el kit.
Error 9: Exagerar el movimiento. Solución: modera la intensidad de movimiento. Los movimientos sutiles suelen ser más creíbles.
Error 10: No hacer corrección de color. Solución: dedica tiempo a unificar la paleta en la edición final. Es el paso que separa un proyecto amateur de uno profesional.
Ejemplos prácticos de escenas con personaje consistente
Ejemplo 1: Escena de diálogo en cafetería. Referencias: cinco imágenes de Ana (frontal, perfiles, tres cuartos, cuerpo completo). Prompt: «Ana, 30 años, caucásica, pelo castaño en coleta baja, ojos verdes, cicatriz en ceja derecha, chaqueta de jean azul, camiseta blanca, sentada en mesa de cafetería, luz de ventana, plano medio, 35mm». Ajustes: CFG 7, motion 0.4, reference strength 0.8. Resultado: identidad mantenida en todos los planos. Se generaron tres tomas: llegada, conversación y despedida. La transición se hizo con corte directo.
Ejemplo 2: Escena de acción bajo la lluvia. Referencias: seis imágenes con chubasquero amarillo y pelo mojado. Prompt: «Ana, 30 años, pelo castaño mojado, chubasquero amarillo, corriendo por callejón lluvioso, noche, luces de neón, plano general, 24mm». Ajustes: reference strength 0.9, motion 0.7. Se dividió en tres clips de 3 segundos y se unieron con transición de barrido. La corrección de color igualó los tonos fríos.
Ejemplo 3: Personaje fantástico. Referencias: cuatro imágenes de Elara, elfa de piel azul y pelo plateado. Prompt: «Elara, elfa, piel azul, pelo plateado, armadura de cuero, bosque encantado, niebla, plano contrapicado, 50mm». Ajustes: CFG 8, motion 0.5, reference strength 0.85. Se mantuvo un estilo pictórico con grano suave. El resultado fue consistente en planos amplios y medios.
Preguntas frecuentes (FAQ)
¿Cuántas imágenes de referencia necesito? Con tres a seis bien elegidas suele bastar. Más imágenes no siempre mejoran; pueden introducir ruido si son inconsistentes entre sí.
¿Puedo usar la misma semilla en todos los planos? Sí, ayuda a mantener la estructura, pero no es suficiente. La semilla controla el ruido inicial; la identidad se controla con referencias multi-imagen.
¿Qué modelo es mejor para consistencia facial? Depende de tu flujo. Los modelos con referencia de personaje integrada son más fáciles. Para control fino, Stable Diffusion con IP-Adapter y FaceID ofrece más opciones.
¿Cómo evito el efecto valle inquietante? Usa iluminación natural, evita movimientos bruscos y revisa la textura de la piel. A veces, un ligero estilizado ayuda a que el cerebro acepte el resultado.
¿Sirve para animación 2D? Sí, pero necesitas referencias de estilo y líneas. La fusión multi-imagen funciona igual, solo que el modelo debe aprender a mantener el trazo.
¿Puedo mantener consistencia entre distintos modelos? Es difícil. Lo recomendable es elegir un pipeline principal y quedarte en él. Si necesitas otro modelo para una tarea específica, úsalo solo para esa tarea y vuelve al principal.
¿Cuánto tiempo toma? Preparar un kit de referencias: una o dos horas. Generar un episodio de dos minutos: varias horas o días según la complejidad y el número de planos.
¿Necesito entrenar un LoRA? Para máxima fidelidad y proyectos largos, un LoRA del personaje puede ser muy útil. Para proyectos cortos, la referencia multi-imagen es suficiente.
Conclusión y siguientes pasos
La consistencia de personajes en vídeo IA es un proceso, no un ajuste único. Empieza con referencias limpias, fija semillas, usa fusión multi-imagen y revisa cada plano. Crea una plantilla de prompts y un kit reutilizable. Documenta los ajustes que funcionan y los que no.
Practica con escenas cortas antes de embarcarte en un proyecto largo. Prueba diferentes modelos con la misma referencia y compara resultados. Invierte tiempo en la corrección de color final; es lo que unifica el conjunto.
La tecnología avanza rápido, pero la metodología marca la diferencia. Con disciplina y un flujo reproducible, puedes lograr personajes coherentes en cualquier escena, desde un diálogo íntimo hasta una secuencia de acción. El siguiente paso es crear tu propio kit de referencias y generar tu primera escena de prueba.
