
Qué significa realmente la fusión multi-imagen
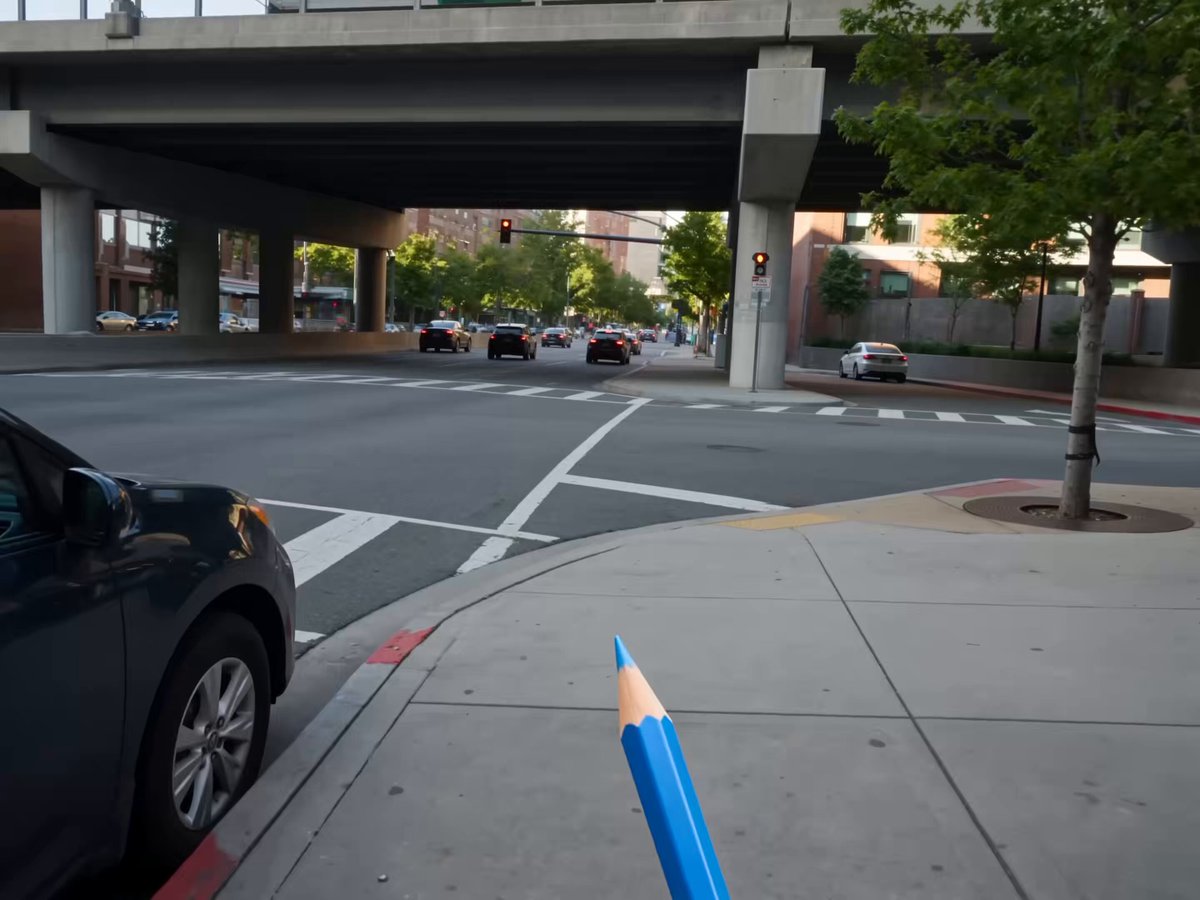
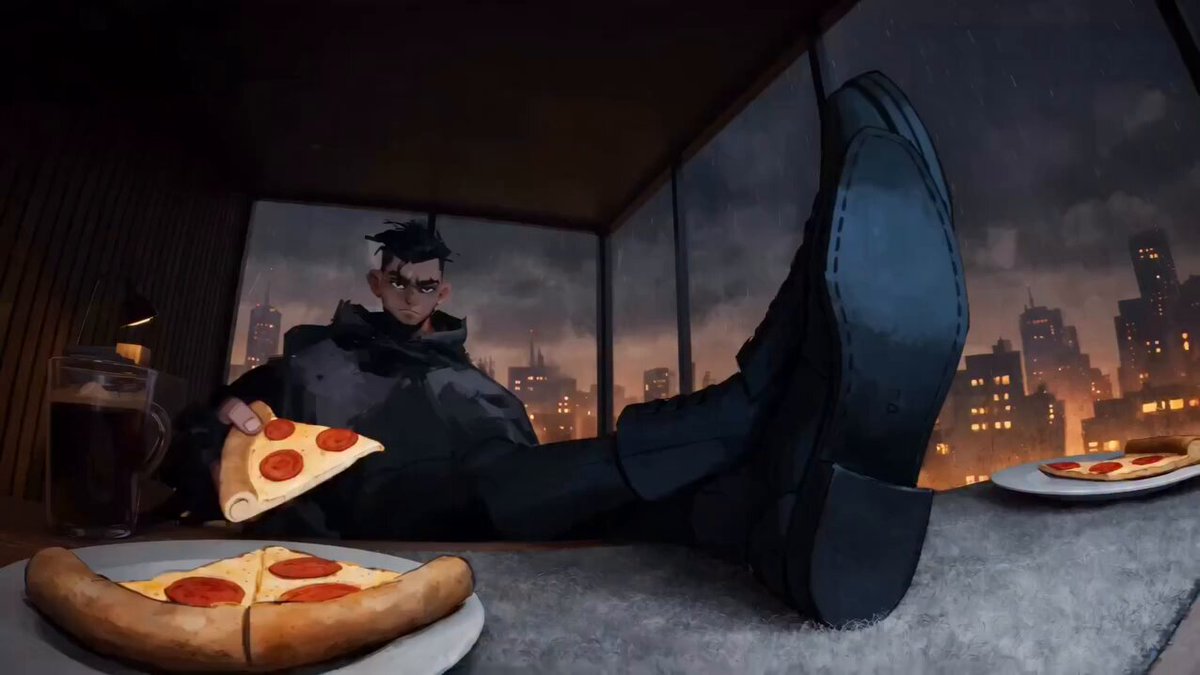
La fusión multi-imagen es una técnica de generación de vídeo con inteligencia artificial en la que el motor no parte de una sola fotografía ni de un prompt de texto aislado, sino de un conjunto de imágenes de referencia que se combinan entre sí para producir un clip coherente. En lugar de pedirle al modelo "inventa algo parecido a esta foto", le entregas un pequeño archivo visual: el rostro de tu personaje, el entorno donde ocurre la escena, un par de detalles de vestuario, una referencia de iluminación y, opcionalmente, un fotograma de estilo. El sistema analiza todos esos elementos, extrae sus rasgos comunes y los fusiona en una secuencia de vídeo donde nada se siente pegado ni improvisado.
La diferencia con el flujo clásico de imagen a vídeo es de fondo, no de matiz. Cuando trabajas con una sola imagen, cualquier movimiento de cámara obliga al modelo a inventar lo que hay fuera del encuadre, y esa invención suele romper la identidad del sujeto: la nariz cambia, el color de la chaqueta se desplaza, el fondo se deforma. Con un set de referencias múltiples, el modelo tiene anclajes suficientes para mantener la identidad mientras la cámara se mueve. Ese es el núcleo del asunto: la fusión multi-imagen no es un truco de estilo, es una arquitectura de consistencia.
En la práctica, esto permite algo que antes requería rodaje: construir un personaje recurrente a partir de fotos, hacerlo aparecer en tres escenarios distintos y que el espectador reconozca el mismo rostro en los tres clips. Para quien produce contenido en formato corto, esa continuidad es la diferencia entre una pieza suelta y una serie que la gente sigue.
Cómo funciona por dentro: keyframes, referencias y coherencia
El papel de los keyframes de referencia
Un keyframe de referencia es una imagen fija que fija un estado concreto del vídeo: cómo se ve el personaje al inicio, cómo se ve en el punto medio, cómo se ve al final. Los motores de vídeo modernos usan estos fotogramas como restricciones duras. Si le das un keyframe de apertura con el personaje mirando a cámara y otro de cierre con el personaje de espaldas, el modelo interpola el giro respetando ambos extremos en lugar de decidir por su cuenta.
La clave está en la densidad de información. Dos keyframes muy parecidos entre sí producen un movimiento pobre; dos keyframes demasiado distintos producen deformaciones a mitad de plano. La zona útil suele estar en una diferencia de entre el 15 % y el 40 % del encuadre: cambia la pose, cambia la dirección de la mirada, cambia la posición en el cuadro, pero mantén la iluminación y el vestuario estables.
Cómo se combinan varios modelos
Un error habitual es pensar que un único modelo lo hace todo. Lo cierto es que los flujos más sólidos encadenan varios: uno especializado en rostros, otro en movimiento corporal, otro en estilización final. La fusión multi-imagen actúa como capa de orquestación entre ellos. Cada modelo aporta su especialidad, pero todos reciben el mismo set de referencias, de modo que el resultado conserva una línea visual común.
Este enfoque se nota especialmente en el estilo cruzado. Si quieres un look cinematográfico con grano fino pero también un poco de animación estilizada en las transiciones, puedes usar dos motores distintos y puentearlos con referencias compartidas. Sin esa capa de fusión, el cambio de estilo se percibe como un corte brusco en lugar de una decisión creativa.
Preparar el material: guía práctica de fotos de entrada
La calidad del clip final depende mucho más de las fotos que entregas que del prompt. Antes de generar nada, dedica veinte minutos a curar el material.
Requisitos mínimos por tipo de plano
- Primer plano de rostro: entre 3 y 6 fotos del mismo sujeto, con ángulos variados (frontal, tres cuartos izquierda, tres cuartos derecha). Evita fotos con gafas de sol, mascarillas o pelo tapando parcialmente la cara.
- Plano medio: 2 o 3 fotos donde se vea la ropa completa y la proporción del cuerpo. Sirven para que el modelo entienda complexión y silueta.
- Entorno: 2 fotos del lugar, preferiblemente con iluminación parecida entre ellas. Si mezclas un mediodía duro con un atardecer cálido, el modelo promediará y saldrá un resultado ambiguo.
- Estilo: 1 o 2 imágenes de referencia visual (otro clip, una fotografía de película, un frame de animación) solo si quieres replicar una textura o paleta concreta.
Errores comunes al elegir fotos
El primero es la resolución engañosa. Una foto de 4000 píxeles con el rostro desenfocado es peor que una de 1200 píxeles nítida. El modelo extrae rasgos, no megapíxeles.
El segundo es la inconsistencia de identidad. Si en una foto el sujeto lleva barba y en otra no, el modelo generará un parpadeo de identidad a mitad de clip. Decide qué versión del personaje quieres y sé coherente.
El tercero es el fondo contaminante. Una foto de rostro tomada en una calle concurrida aporta ruido de fondo que el modelo puede arrastrar a escenas donde no corresponde. Recorta o elige tomas con fondo neutro para el set de identidad, y usa las fotos de entorno para lo que son.
Flujo de trabajo paso a paso: de fotos sueltas a un clip terminado
Paso 1: definir el brief visual antes de tocar el teclado
Escribe en una frase qué tiene que lograr el clip. "El personaje camina hacia la cámara en un mercado nocturno, plano medio, luz cálida, sin diálogo, seis segundos." Este brief determina qué referencias necesitas y qué referencias sobran. Sin brief, acabas subiendo quince imágenes y el modelo no sabe cuál priorizar.
Paso 2: construir el set de referencias
Separa las imágenes en dos bloques: identidad y escena. El bloque de identidad se reutiliza en todos los clips de la serie; el bloque de escena cambia cada vez. Esta separación es la que te permite escalar sin perder consistencia.
Paso 3: generar y comparar variantes
Genera siempre al menos tres variantes del mismo plano con la misma entrada. Dos razones: la primera es que la generación tiene componente aleatorio, y la segunda es que comparar te entrena el ojo. Anota qué funcionó: si la variante A mantiene mejor el rostro y la B tiene mejor movimiento de cámara, puede que la solución sea usar A como keyframe de apertura y B como cierre.
Paso 4: ensamblar, montar y sonorizar
El clip generado es materia prima, no producto final. Pasa por un editor, corta los primeros y últimos diez fotogramas (donde suelen aparecer inestabilidades), ajusta la velocidad, añade sonido y subtítulos. En formato vertical, el ritmo manda: cortes cada dos o tres segundos, con un gancho visual en el primer segundo.
Casos de uso donde la fusión multi-imagen rinde de verdad
Personaje recurrente. Series de humor, microdramas verticales, contenido educativo con presentador ficticio. Aquí la consistencia es el producto: si el público detecta un cambio de cara entre episodios, la ilusión se rompe.
Producto y marca. Fotos de un objeto desde varios ángulos convertidas en un plano de rotación limpio para publicidad. Con una sola foto, la rotación inventa la parte trasera del producto y suele inventarla mal. Con cuatro o cinco ángulos reales, el resultado es creíble.
Paisaje y arquitectura. Fotos de un lugar tomadas por un viajero transformadas en un plano continuo de dron. La fusión ayuda a mantener la coherencia de montañas, edificios y horizonte.
Archivo histórico o familiar. Fotografías antiguas en blanco y negro que se convierten en un plano con movimiento sutil de cámara. Aquí conviene bajar la intensidad de movimiento: un travelling suave envejece mejor que un giro brusco.
Consistencia de personaje a escala: cómo no perder el rostro entre escenas
Cuando produces cinco o diez clips con el mismo personaje, aparecen problemas que no se ven en una pieza única. El más frecuente es la deriva de identidad: cada generación se aleja un poco de la referencia original y, al cabo de seis clips, el personaje parece otro.
La solución práctica es crear un set canónico cerrado. Elige las cuatro mejores fotos de identidad, guárdalas en una carpeta y no las cambies. Cada nuevo clip debe partir de ese set, nunca de fotogramas generados previamente. Si necesitas un nuevo ángulo, genera primero una imagen estática validada, revísala a mano y solo entonces úsala como referencia. Encadenar generaciones sobre generaciones amplifica los errores.
El segundo problema es el cambio de vestuario. Si el personaje lleva una chaqueta roja en dos escenas y azul en la tercera, la audiencia lo lee como un salto temporal no intencionado. Mantén un documento con los detalles de continuidad: colores, peinado, accesorios, hora del día. Suena burocrático, pero es exactamente lo que hace un equipo de rodaje con el script supervisor.
El tercer problema es la iluminación. Un rostro generado con luz de estudio aplicado a una escena nocturna se ve recortado, como un collage. Cuando generes el plano, describe la fuente de luz de la escena y deja que el set de identidad aporte solo la estructura del rostro, no su iluminación original.
Criterios de decisión: cuándo usar fusión multi-imagen y cuándo no
No todo necesita varias referencias. Usa este filtro antes de complicarte:
- Una sola foto basta cuando el clip es un movimiento sutil de cámara sobre una imagen fija, sin cambio de pose ni de escenario. Añadir referencias solo introduce ruido.
- Dos o tres fotos cuando el sujeto se mueve dentro del mismo entorno y necesitas que mantenga la identidad durante el movimiento.
- Cuatro o más fotos cuando hay cambio de escenario, cambio de plano o el personaje va a reaparecer en varios clips.
- Descarta la fusión si el plano requiere acción física compleja o interacción precisa con objetos. Ahí los modelos actuales todavía fallan y probablemente obtengas mejores resultados con metraje real combinado con capas generadas.
Otro criterio útil es el tiempo de iteración. Si generar una variante te cuesta veinte minutos de cómputo, no lances quince a ciegas: valida primero con un plano corto de dos segundos, comprueba la identidad, y luego invierte en el plano definitivo.
Rendimiento, coste de cómputo y control de calidad
Aunque no hay una factura por imagen generada, sí hay un coste real en tiempo de GPU, almacenamiento y revisiones. Los flujos que mejor rinden son los que reducen el número de generaciones fallidas, no los que generan más.
Tres hábitos que ahorran trabajo:
- Prueba en baja duración. Genera primero clips de dos segundos. Si la identidad se rompe en el segundo dos, no va a arreglarse en el ocho.
- Reutiliza sets de referencia. Una vez validado un set de identidad, conviértelo en plantilla. Cambiar solo el bloque de escena reduce errores y tiempo.
- Documenta los parámetros. Anota resolución, duración, instrucción de movimiento y referencias usadas en cada generación que te haya gustado. Sin registro, no puedes reproducir el acierto.
En control de calidad, revisa siempre cuatro cosas: coherencia facial entre planos, continuidad de vestuario, dirección de la luz y estabilidad del fondo hacia los bordes del encuadre. Los artefactos suelen aparecer en los márgenes y en los primeros fotogramas.
Errores frecuentes y cómo corregirlos
Rostro que se derrite a mitad de clip. Suele indicar keyframes contradictorios o un set de identidad con ángulos muy dispares. Reduce el número de referencias faciales y elige las más similares entre sí.
Movimiento de cámara imposible. Si pides un travelling lateral largo en un clip de tres segundos, el modelo comprime el movimiento y produce deformaciones. Ajusta la velocidad de cámara a la duración real.
Estilo que se pierde en la segunda mitad. Ocurre cuando la referencia de estilo se entrega solo al inicio. Repite la referencia de estilo también como keyframe de cierre.
Fondos que se repiten de forma antinatural. Es un síntoma de set de escena demasiado homogéneo. Introduce una foto con un ángulo distinto del mismo lugar.
Manos y objetos pequeños. Es una limitación conocida. Encuadra de modo que las manos queden fuera o en segundo plano, o planifica el plano para que no las necesite.
Preguntas frecuentes
¿Cuántas fotos hacen falta como mínimo? Para un retrato con movimiento suave, tres bien elegidas son suficientes. Para una serie con varias escenas, cuatro de identidad más dos de entorno por escena es un punto de partida razonable.
¿Sirven fotos de móvil? Sí, si están nítidas y bien iluminadas. La luz difusa y frontal funciona mejor que un contraluz dramático, porque el modelo extrae rasgos con menos ambigüedad.
¿Se puede mezclar estilos artísticos distintos? Se puede, pero hazlo de forma intencionada. Lo que produce resultados extraños no es mezclar estilos, sino mezclar estilos sin decirle al sistema cuál manda en cada parte del clip.
¿Cuánto dura un clip generado con esta técnica? Depende del motor, pero los planos de tres a ocho segundos son el rango donde la consistencia se mantiene con más fiabilidad. Para piezas más largas, encadena varios planos cortos en lugar de forzar uno largo.
¿Qué diferencia hay entre esto y animar una foto? Animar una foto mueve la cámara sobre una imagen congelada. La fusión multi-imagen construye movimiento real del sujeto usando varias referencias, por eso mantiene la identidad cuando el personaje cambia de pose.
¿Necesito formación técnica? No para empezar. Sí conviene entender los conceptos de keyframe y de set de referencia, porque son los dos mandos que determinan el resultado.
Conclusión práctica
La fusión multi-imagen resuelve el problema que más frustra a quien genera vídeo con IA: perder la identidad del sujeto en cuanto la escena se complica. La receta es más sencilla de lo que parece: define un brief claro, cura un set de identidad pequeño y estable, separa identidad de escena, prueba en duraciones cortas y documenta lo que funciona. Con esos cinco hábitos, la diferencia entre un clip que parece generado y un clip que parece rodado deja de ser cuestión de suerte y se convierte en cuestión de método.
