
Perché il testo è oggi il punto di partenza della produzione video
Fino a pochi anni fa, trasformare un'idea in un video significava passare attraverso un funnel obbligato: sceneggiatura, storyboard, sopralluoghi, riprese, montaggio. Ogni fase aveva un costo e un tempo difficilmente comprimibili. La generazione video AI ha rotto questa sequenza: oggi si può partire da una frase, da uno schizzo o da una singola immagine e arrivare a un clip montabile in poche ore, senza troupe e senza set.
Il cambio di paradigma non riguarda solo la velocità. Riguarda il numero di iterazioni possibili. Quando produrre una variante costa quasi nulla, il lavoro creativo si sposta dalla fase di esecuzione a quella di esplorazione: si provano dieci direzioni visive invece di una, si testano ritmi diversi, si verifica subito se un'idea regge sullo schermo. Questo è il vero vantaggio competitivo della generazione video AI, molto più della singola clip spettacolare.
Questa guida non è una vetrina di strumenti. È un percorso operativo pensato per chi deve produrre video reali — spot brevi, contenuti social, teaser, visual per presentazioni — e vuole capire come scegliere i modelli, strutturare i prompt, mantenere la coerenza tra le inquadrature e chiudere il progetto in post-produzione senza perdere qualità.
Come funziona davvero una pipeline di generazione video
Capire l'architettura sottostante aiuta a usare meglio gli strumenti e a diagnosticare gli errori. Quasi tutti i sistemi attuali condividono la stessa logica di fondo, articolata in tre livelli.
Il modello di diffusione e lo spazio latente
I modelli di diffusione imparano a ricostruire un'immagine partendo dal rumore. In fase di addestramento vedono miliardi di fotogrammi e imparano quali pattern visivi sono plausibili. In fase di generazione, il rumore viene progressivamente trasformato in un contenuto che rispetta il prompt. Per non lavorare su ogni pixel, il processo avviene in uno spazio latente compresso: è lì che il modello ragiona su forme, luci e texture, e da lì il decoder ricostruisce i fotogrammi finali.
Nei modelli video si aggiunge una dimensione temporale. Il modello non deve solo produrre un'immagine plausibile, ma una sequenza in cui gli oggetti si muovono in modo fisicamente credibile e la telecamera si comporta come ci si aspetta. È qui che si separano i modelli buoni da quelli eccellenti: un volto può essere perfetto nel primo fotogramma e deformarsi al decimo, oppure una mano può cambiare numero di dita mentre si muove.
Il ruolo del text encoder
Il prompt testuale viene tradotto in una rappresentazione numerica da un encoder. La qualità di questa traduzione determina quanto il risultato resta fedele all'intenzione. Prompt vaghi producono interpretazioni medie, cioè visivamente anonime. Prompt strutturati — soggetto, azione, ambiente, luce, ottica, stile — danno al modello abbastanza vincoli per prendere decisioni coerenti.
Il controllo temporale: keyframe, riferimenti e traiettorie
Sopra al modello base esistono strati di controllo: keyframe iniziali e finali, immagini di riferimento per il personaggio, mappe di profondità, traiettorie di camera. Sono gli strumenti che permettono di dirigere la scena invece di limitarsi a sperarla. Un flusso di lavoro maturo combina sempre generazione libera e controllo esplicito.
Scegliere il modello giusto: criteri di decisione concreti
Il mercato dei modelli si è specializzato. Non esiste il modello migliore in assoluto: esiste il modello migliore per il tuo tipo di contenuto, il tuo budget di tempo e il tuo livello di controllo richiesto. Ecco i criteri che contano davvero.
Realismo fotografico e resa dei materiali
Se il tuo obiettivo è un look da spot pubblicitario, con pelle credibile, metalli riflettenti, vetro e tessuti, hai bisogno di un modello addestrato su dati fotografici di alta qualità. In questa categoria i nomi di riferimento includono la serie Flux per la qualità dell'immagine statica e la resa dei dettagli, Runway Gen-4 e Gen-3 per la stabilità cinematografica delle sequenze, e i modelli della famiglia Sora per la comprensione narrativa e la fisica delle scene complesse.
Stile illustrato, anime e 3D
Se lavori su animazione, fumetto, motion design o estetiche videogiocose, il realismo è un difetto, non un pregio. In questo caso conviene orientarsi su modelli con checkpoint stilizzati o su pipeline ibride: generi l'immagine chiave con un modello specializzato in illustrazione, poi la animi con un modello che rispetta il disegno originale. La coerenza dello stile tra le clip è più importante della fedeltà fotografica.
Controllo del movimento di camera
Un carrello laterale lento comunica calma ed eleganza; un dolly in avanti crea tensione; un'orbita attorno al soggetto suggerisce tridimensionalità. Se il tuo video richiede movimenti di camera precisi, verifica che il modello accetti parametri di camera espliciti o che supporti input video di riferimento. I modelli che ignorano queste istruzioni tenderanno a produrre inquadrature statiche o movimenti casuali.
Durata, risoluzione e rapporto d'aspetto
Le clip native durano in genere pochi secondi. Questo non è un limite se pianifichi il montaggio fin dall'inizio: si costruisce il video come una sequenza di shot brevi, esattamente come si farebbe con un piano di ripresa tradizionale. Verifica anche i formati: se il tuo output è verticale per i social, generare in orizzontale e ritagliare in post-produzione può far perdere composizione e dettaglio.
Workflow operativo in otto passaggi
Questa è la sequenza che uso per portare un progetto da una frase a un video finito.
- Definisci l'obiettivo e il formato. Prima di qualsiasi prompt, scrivi una frase che descriva cosa deve fare il video, per chi, su quale piattaforma e con quale durata. Un teaser da sei secondi e un explainer da trenta secondi richiedono modelli e ritmi diversi.
- Scrivi uno shot list. Tre-sei inquadrature per un contenuto breve. Per ciascuna annota soggetto, azione, ambiente, luce ed emozione. Questo documento diventa la base dei prompt e ti evita di improvvisare.
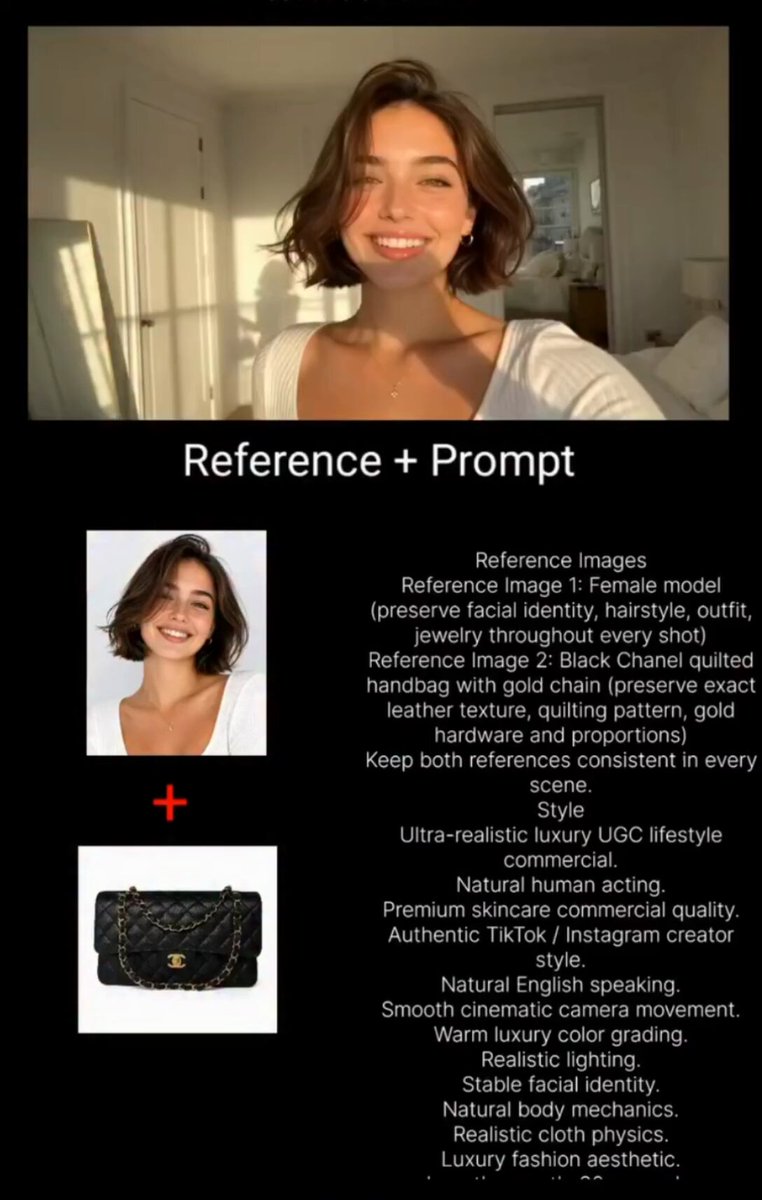
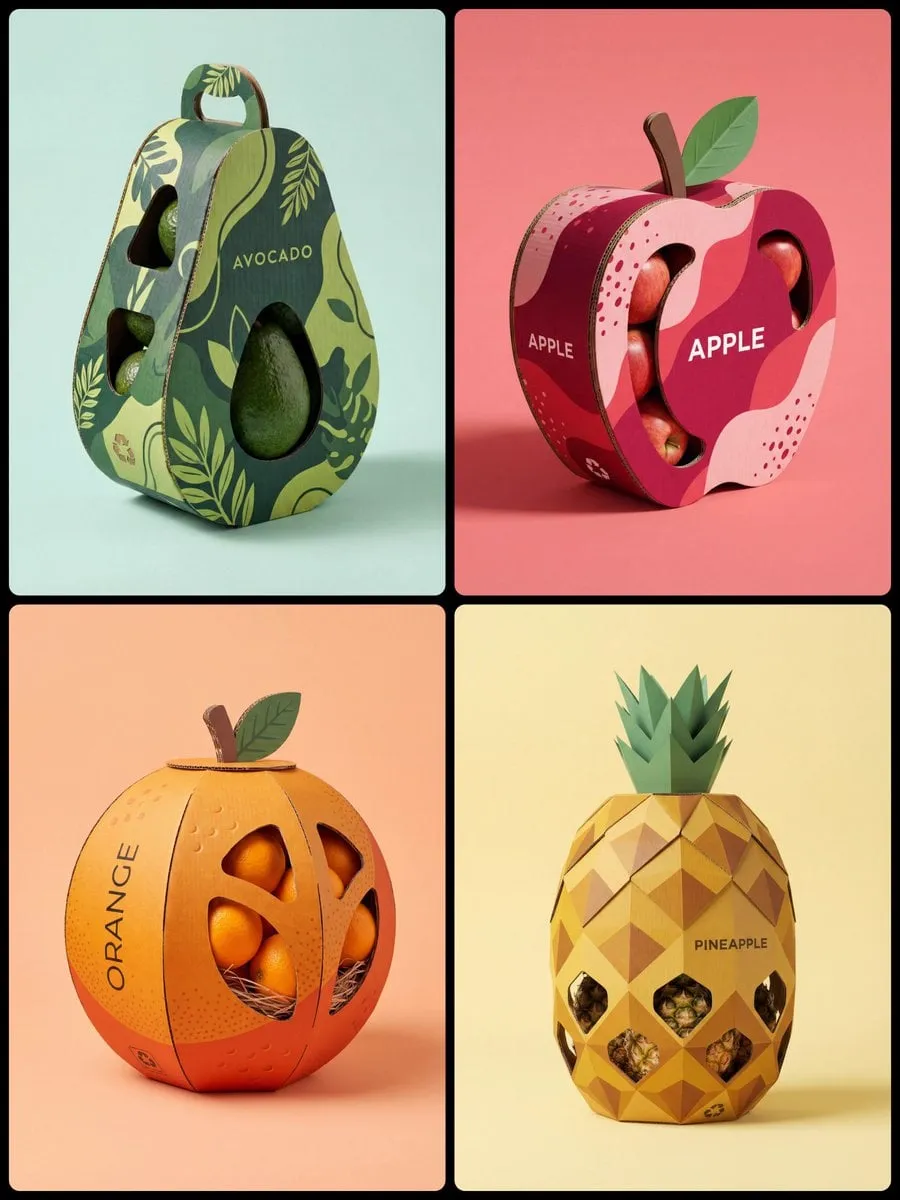
- Genera prima le immagini chiave. Produrre un'immagine statica è più veloce ed economico che produrre video. Usa la generazione di immagini per fissare look, palette, inquadratura e resa del personaggio. Solo quando l'immagine funziona passa alla fase video.
- Anima con il modello più adatto allo shot. Non usare lo stesso modello per tutto. Un primo piano emotivo e una veduta aerea hanno esigenze diverse: cambia modello in base alla scena, non per abitudine.
- Verifica la coerenza tra le clip. Metti le clip in sequenza su una timeline e guardale senza audio. Se il personaggio cambia viso, se la luce salta o se gli oggetti si spostano, torna indietro e rigenera solo lo shot problematico.
- Applica i controlli di continuità. Usa keyframe finali per collegare due shot, immagini di riferimento per bloccare l'aspetto del protagonista, traiettorie per allineare il movimento della camera tra inquadrature adiacenti.
- Post-produci. Upscaling, interpolazione dei fotogrammi per fluidità, stabilizzazione, color grading, sound design. Il suono è ciò che fa percepire un video AI come professionale più di qualsiasi miglioramento visivo.
- Esporta nelle versioni necessarie. Orizzontale, verticale, quadrato. Rifai il framing in modo consapevole, non con un ritaglio automatico.
Immagine-prima o testo-prima: quando usare ciascun approccio
Il dibattito tra generazione puramente testuale e generazione guidata da immagine è spesso mal posto. Non sono alternative, sono fasi diverse dello stesso processo.
Quando partire dal testo
Parti dal testo quando stai esplorando. Se non sai ancora che aspetto deve avere la scena, il prompt testuale è lo strumento più rapido per generare opzioni. Produce risultati meno controllabili ma più sorprendenti, ed è ideale nella fase di concept e nella ricerca di un linguaggio visivo.
Quando partire dall'immagine
Parti dall'immagine quando devi replicare qualcosa che esiste già: un prodotto reale, un volto approvato dal cliente, uno stile grafico definito. Animare un'immagine di riferimento riduce drasticamente la variabilità e ti dà una base su cui discutere con il committente prima di spendere tempo sulla generazione video.
L'approccio ibrido, il più produttivo
Il flusso più efficiente è a tre stadi: prompt testuale per esplorare, immagine chiave per fissare la direzione approvata, animazione guidata per produrre le clip finali. Ogni stadio filtra il rumore creativo dello stadio precedente. Chi salta direttamente al video partendo da un prompt vago spende il doppio del tempo in rigenerazioni.
Coerenza tra le inquadrature: il problema più difficile
Se c'è un punto in cui i progetti video AI falliscono, è la continuità. Un singolo shot può essere straordinario e il video nel suo insieme risultare inutilizzabile perché il protagonista cambia giacca, l'auto cambia modello o la luce passa da mezzogiorno a tramonto tra due inquadrature consecutive.
Le strategie per risolvere il problema sono quattro.
Bloccare il personaggio con immagini di riferimento. Genera tre o quattro viste del protagonista — frontale, di profilo, a figura intera — e usale come riferimento in ogni shot. Le pipeline che supportano la fusione multi-immagine permettono di combinare il volto, l'abbigliamento e lo sfondo in un unico riferimento coerente.
Usare keyframe di raccordo. Il fotogramma finale di uno shot può diventare il fotogramma iniziale del successivo. Questo crea una continuità visiva immediata e riduce la sensazione di montaggio a scatti.
Fissare una scheda tecnica visiva. Scrivi una volta sola i parametri ricorrenti — tipo di obiettivo, altezza della camera, direzione della luce, palette — e incollali in ogni prompt. La coerenza nasce dalla ripetizione dei vincoli, non dalla fortuna.
Accettare il montaggio come strumento. Non tutte le discontinuità sono errori. Un cambio di luce può diventare un'ellissi narrativa voluta, se accompagnato da un cambio di scena chiaro. Il problema nasce quando la discontinuità è involontaria e l'occhio dello spettatore non capisce se è passato del tempo.
Prompt engineering per il video: struttura e vocabolario
Un prompt video efficace è una descrizione tecnica, non una poesia. La struttura che funziona meglio è a blocchi.
Soggetto e azione. Chi o cosa, e cosa sta facendo. Meglio un'azione semplice e specifica che tre azioni contemporanee: i modelli tendono a perdere il controllo con richieste multiple.
Ambiente e atmosfera. Dove siamo, che ora del giorno, che tempo fa, che sensazione deve trasmettere la scena.
Luce. Questo blocco è sottovalutato. "Luce morbida laterale", "controluce al tramonto", "neon notturno riflesso sull'asfalto bagnato" cambiano il risultato più di qualsiasi altro parametro.
Ottica e camera. "Obiettivo 35mm", "primo piano", "carrello lento verso destra", "camera a mano", "drone in salita". Sono istruzioni che il modello comprende sorprendentemente bene.
Stile e resa. "Fotorealistico", "pellicola 16mm con grana", "illustrazione cel-shaded", "render 3D pulito".
Vincoli negativi. Cosa non deve comparire: watermark, testo, arti deformati, sfocatura eccessiva. Specificare i problemi più frequenti del tuo dominio riduce le rigenerazioni.
Un esempio di prompt strutturato per uno shot breve: "Donna sulla quarantina, giacca di lana grigia, cammina lentamente lungo una banchina ferroviaria all'alba. Nebbia bassa, luci al sodio ancora accese, binari bagnati. Luce laterale morbida, toni freddi con accenti arancioni. Obiettivo 50mm, camera a mano con leggero movimento. Fotorealistico, grana sottile, profondità di campo ridotta."
Post-produzione: dove il video AI diventa davvero utilizzabile
Uscire dal modello è il punto di metà del lavoro. La differenza tra un contenuto che sembra generato e uno che sembra girato si costruisce qui.
Upscaling e dettaglio. I modelli video producono spesso risoluzioni inferiori a quelle richieste dalla distribuzione. Un passaggio di upscaling con un modello dedicato ricostruisce texture e microdettagli, soprattutto su pelle, tessuti e vegetazione.
Interpolazione dei fotogrammi. Aumentare il frame rate rende i movimenti più fluidi, ma va usata con misura: su azioni molto rapide può creare artefatti a forma di alone. Applica l'interpolazione solo dove serve e verifica l'inquadratura per inquadratura.
Stabilizzazione e riquadratura. Alcuni movimenti di camera generati sono troppo irregolari. Una stabilizzazione leggera li rende credibili senza appiattirli.
Color grading. Uniformare il colore tra le clip è il modo più rapido per dare unità al progetto. Un LUT condiviso o un semplice bilanciamento del bianco coerente fa miracoli su sequenze generate da modelli diversi.
Sound design. Passi, respiri, ambiente, musica. Il cervello perdona un dettaglio visivo imperfetto molto più facilmente di un audio povero. Se hai tempo per una sola rifinitura, falla sull'audio.
Errori comuni e come evitarli
Affidarsi a un solo modello per tutto il progetto. Ogni modello ha un punto di forza. Usarne uno solo significa accettare compromessi inutili su alcune inquadrature.
Scrivere prompt lunghi e contraddittori. Due stili incompatibili nello stesso prompt producono una media confusa. Se vuoi controllare lo stile, fallo in una fase separata.
Ignorare il rapporto d'aspetto in fase di generazione. Generare in orizzontale per poi ritagliare in verticale è uno degli errori più costosi: si perde composizione, si tagliano teste e si riduce la risoluzione utile.
Non fare una shot list. Senza pianificazione si finisce con clip belle ma scollegate, che non si montano insieme.
Sottovalutare i tempi di rigenerazione. Le clip che funzionano al primo tentativo sono l'eccezione. Pianifica almeno tre o quattro iterazioni per inquadratura.
Trascurare i diritti e l'uso commerciale. Prima di pubblicare, verifica le condizioni d'uso dei modelli scelti, in particolare per volti riconoscibili, marchi e contenuti destinati alla pubblicità.
FAQ rapida per chi inizia
Serve saper disegnare o montare per lavorare con il video AI? No, ma aiuta avere occhio per composizione e ritmo. La capacità più utile è saper descrivere un'inquadratura in modo preciso.
Quante clip servono per un video di trenta secondi? Tra sei e dodici, a seconda del ritmo. Calcola una media di due-tre secondi per inquadratura nei contenuti dinamici, quattro-cinque in quelli lenti.
Meglio generare in verticale o ritagliare? Genera nel formato finale ogni volta che il modello lo consente. Il ritaglio è un'ultima risorsa, non una strategia.
Come mantengo lo stesso volto tra le scene? Usa immagini di riferimento multiple, keyframe di raccordo e una scheda tecnica visiva ripetuta nei prompt. Aspettati comunque di dover rigenerare alcune inquadrature.
Il video AI può sostituire una ripresa reale? Per paesaggi, astratti, concept e visual di supporto sì. Per volti in primo piano con recitazione prolungata e per prodotti che devono essere fedeli al millimetro, la ripresa reale resta più affidabile.
Quanto tempo richiede un progetto completo? Un contenuto breve e ben pianificato si chiude in una giornata di lavoro, incluse generazione, selezione e montaggio. I progetti con molti personaggi ricorrenti richiedono più tempo per la fase di continuità.
Conclusione: progettare prima, generare dopo
La generazione video AI ha abbassato la barriera tecnica, ma non ha eliminato la necessità di progettare. Anzi, l'ha resa più evidente: quando chiunque può produrre immagini in movimento, la differenza la fa la chiarezza dell'intenzione. Una shot list scritta bene, una scheda visiva coerente e un prompt strutturato valgono più di dieci tentativi casuali con lo strumento più recente.
Il modo migliore per iniziare è ridurre la scala. Scegli una scena, un personaggio, un movimento di camera. Prova tre modelli diversi sulla stessa idea e confronta i risultati con occhio critico. Poi monta le clip, aggiungi l'audio e guarda il tutto senza fermarti. Le debolezze emergeranno da sole, e saranno la tua lista di lavoro per il progetto successivo. È così che si costruisce un metodo: non accumulando funzionalità, ma ripetendo un flusso che funziona e migliorandolo un'inquadratura alla volta.
