
Wie aus einem Satz ein Film wird: die Grundlogik der KI-Videogenerierung
Bewegtbild aus einer Textbeschreibung zu erzeugen, ist längst kein Experiment mehr. Es ist ein Handwerk mit eigenen Regeln, eigenen Werkzeugen und eigenen Fehlerquellen. Wer heute ein Video mit KI produziert, arbeitet selten mit einem einzigen Modell. Stattdessen entsteht ein Clip in mehreren Stufen: Idee, Storyboard, Referenzbilder, Bewegungsgenerierung, Ton, Schnitt und Farbanpassung. Jede dieser Stufen hat ihre eigene Logik, und jede kann das Ergebnis ruinieren, wenn sie übersprungen wird.
Die technische Grundlage ist eine Kombination aus Diffusionsverfahren für Einzelbilder und zeitlichen Modellen, die dafür sorgen, dass aufeinanderfolgende Frames zusammenpassen. Genau hier liegt der Unterschied zu einem Standbild: Ein Modell muss nicht nur ein schönes Bild erzeugen, sondern eine plausible Veränderung über die Zeit. Bewegt sich eine Hand zu schnell, verschwimmt sie. Ändert sich das Licht von Frame zu Frame, wirkt die Szene flackernd. Kippt die Perspektive, verliert der Zuschauer die Orientierung.
Deshalb ist die wichtigste Erkenntnis für den Einstieg: KI-Video ist kein Knopf, sondern eine Kette. Die Qualität des schwächsten Glieds bestimmt das Endergebnis. Ein perfekter Prompt hilft wenig, wenn die Referenzbilder widersprüchlich sind. Ein großartiges Modell rettet keine Szene, die dramaturgisch nicht funktioniert. Und ein beeindruckender Einzelclip ergibt noch kein Video, wenn die Übergänge und der Ton nicht sitzen.
Dieser Leitfaden beschreibt deshalb keine endlose Modellliste, sondern einen Arbeitsablauf. Er erklärt, wie man Modelle nach Aufgaben auswählt, wie man Prompts für Bewegung schreibt, wie man Figuren über mehrere Szenen konsistent hält, wie man Ton und Schnitt integriert und welche Fehler immer wieder auftauchen.
Die Modelllandschaft sortieren, statt Modelle sammeln
Neue Video-Modelle erscheinen im Wochenrhythmus. Wer jede Ankündigung verfolgt, verliert mehr Zeit mit Testen als mit Produzieren. Sinnvoller ist eine Sortierung nach Aufgabenklasse. Fast jedes verfügbare Werkzeug lässt sich einer von vier Kategorien zuordnen, und innerhalb dieser Kategorien unterscheiden sich die Modelle vor allem in Stil, maximaler Clip-Länge, Auflösung und Steuerbarkeit.
Text-zu-Video: der schnellste Weg zum ersten Shot
Text-zu-Video ist der direkteste Einstieg. Man beschreibt eine Szene, das Modell liefert einen Clip. Sora, Runway, Kling, Hailuo und vergleichbare Systeme arbeiten nach diesem Prinzip, unterscheiden sich aber deutlich in der Bewegungswiedergabe. Einige Modelle sind stark bei ruhigen, filmischen Einstellungen mit langsamer Kamerafahrt, andere bei schnellen, dynamischen Actionszenen. Für Konzeptarbeit und Moodboards ist Text-zu-Video ideal, weil es in Minuten mehrere Interpretationsvarianten liefert.
Die Grenze liegt in der Kontrolle. Ohne Referenz entscheidet das Modell über Gesichter, Kostüme und Ausstattung. Für eine Serie mit wiederkehrender Hauptfigur ist das zu instabil. Text-zu-Video eignet sich daher am besten für Establishing Shots, Landschaften, Abstraktionen, Hintergründe und Einzelszenen ohne Figurenkontinuität.
Bild-zu-Video: Kontrolle durch Startframes
Bild-zu-Video ist in der Praxis der wichtigste Modus. Man erzeugt oder fotografiert zuerst ein Standbild, das exakt die gewünschte Komposition, Figur und Lichtstimmung zeigt, und lässt es anschließend animieren. Pika, Luma, Vidu und zahlreiche weitere Systeme bieten diesen Weg. Der Vorteil ist offensichtlich: Was im Standbild korrekt ist, kann nicht mehr falsch generiert werden.
Bild-zu-Video verlagert die kreative Arbeit in die Bildphase. Wer dort sorgfältig arbeitet – saubere Hände, klare Silhouetten, glaubwürdige Beleuchtung – bekommt deutlich stabilere Clips. Der Nachteil: Das Modell neigt dazu, nur kleine Bewegungen zu erzeugen, wenn das Startbild sehr detailliert ist. Man muss die Bewegung im Prompt explizit anfordern und darf nicht erwarten, dass das System von selbst eine dramatische Handlung erfindet.
Video-zu-Video und Motion Transfer: vorhandenes Material umdeuten
Die dritte Kategorie nimmt bestehendes Videomaterial und verändert es stilistisch oder inhaltlich. Das ist nützlich für Realverfilmungen mit animiertem Look, für Stiltransfers auf gedrehtes Material und für Rotoscoping-artige Effekte. Ebenso wichtig ist Motion Transfer, bei dem die Bewegungsdaten einer Referenzaufnahme auf eine neue Figur übertragen werden. Für Tanzszenen, Choreografien und wiederkehrende Bewegungsmuster ist das oft die einzige zuverlässige Methode.
Auswahlkriterien in der Praxis
Vier Fragen entscheiden über die Modellwahl. Erstens: Brauche ich Figurenkonsistenz über mehrere Einstellungen? Dann führt der Weg über Bild-zu-Video mit festen Referenzen. Zweitens: Wie lang muss eine Einstellung sein? Modelle liefern unterschiedliche maximale Segmentlängen, und lange Einstellungen müssen häufig aus mehreren Segmenten zusammengesetzt werden. Drittens: Wie wichtig ist Steuerung gegenüber Geschwindigkeit? Wer täglich Varianten testet, braucht schnelle Durchläufe; wer einen Werbespot produziert, braucht Präzision. Viertens: Welche Auflösung ist nötig? Manche Modelle glänzen bei kurzen, hochauflösenden Clips, andere bei längeren Sequenzen mit geringerer Detailtiefe.
Ein weiterer Faktor ist die Nachbearbeitbarkeit. Modelle, die interpolierte Frames liefern, wirken bei 24 fps weicher, können aber bei schnellen Bewegungen Artefakte erzeugen. Wer später in einem Schnittprogramm arbeitet, sollte das Ausgangsmaterial nicht zu stark komprimieren.
Prompting für Bewegtbild: was anders ist als bei Standbildern
Ein Bild-Prompt beschreibt einen Zustand. Ein Video-Prompt beschreibt eine Veränderung. Dieser Unterschied ist der häufigste Grund, warum Einsteiger enttäuscht sind: Sie beschreiben eine schöne Szene und erhalten einen Clip, in dem fast nichts passiert.
Die sechs Elemente eines belastbaren Video-Prompts
Ein guter Video-Prompt enthält sechs Bausteine. Erstens das Motiv: Wer oder was ist zu sehen, wie viele Personen, welche Kleidung, welche Gegenstände. Zweitens der Ort: Innenraum oder Außenwelt, Tageszeit, Wetter, Architektur. Drittens die Handlung: Eine konkrete, sichtbare Aktion, nicht eine Stimmung. Viertens die Kamera: Perspektive, Bewegung, Brennweite, Objektivcharakter. Fünftens das Licht: Richtung, Härte, Farbtemperatur, Kontrast. Sechstens der Stil: Filmkorn, Analog-Look, Animation, Rendering-Ästhetik, Farbpalette.
Wichtig ist die Reihenfolge. Motiv und Handlung gehören nach vorn, weil Modelle die ersten Begriffe stärker gewichten. Stilangaben stehen am Ende, sonst überschreiben sie inhaltliche Details. Und die Handlung sollte in einem Satz stehen, der eine Bewegung enthält: „Sie dreht den Kopf zur Kamera“ funktioniert, „sie wirkt nachdenklich“ nicht.
Kameraanweisungen, die tatsächlich funktionieren
Kamerasprache ist wirkungsvoll, wenn sie physisch eindeutig ist. Formulierungen wie langsame Fahrt nach vorn, seitliche Verfolgung, leichte Handkamera, statische Einstellung auf Stativ oder langsamer Zoom liefern zuverlässige Ergebnisse. Problematisch sind komplexe Anweisungen wie eine Kombination aus Dolly, Schwenk und Fokusziehen in einem einzigen Clip. Modelle können mehrere Bewegungen gleichzeitig nur selten überzeugend auflösen.
Ein bewährter Trick: Pro Clip nur eine Kamerabewegung. Wer mehr Bewegung braucht, erzeugt mehrere kurze Einstellungen und montiert sie. Ein harter Schnitt zwischen zwei Perspektiven wirkt oft besser als eine technisch fehlerhafte Kamerafahrt.
Negativ-Prompts und Grenzen des Modells
Negativ-Prompts sind nützlich, aber kein Allheilmittel. Sinnvoll sind wenige, konkrete Begriffe: verzerrte Gesichter, zusätzliche Gliedmaßen, Text im Bild, Wasserzeichen, flackerndes Licht, doppelte Personen. Lange Listen verwirren das Modell und schwächen die eigentliche Beschreibung.
Grundsätzlich gilt: Modelle sind stark bei Material, Licht, Landschaft und langsamer Bewegung. Sie sind schwach bei präziser Interaktion, lesbarem Text, komplexen Handbewegungen und Dialogszenen mit mehreren Personen. Wer das akzeptiert, plant Szenen so, dass die Stärken dominieren.
Charakterkonsistenz, Stil und Szenenübergänge
Das größte Problem in längeren KI-Projekten ist nicht die Qualität des einzelnen Clips, sondern die Wiedererkennbarkeit. Eine Figur, die in Einstellung eins ein rundes Gesicht und in Einstellung vier ein kantiges hat, zerstört die Illusion sofort.
Referenzbilder, Stiltransfer und Bildfusion
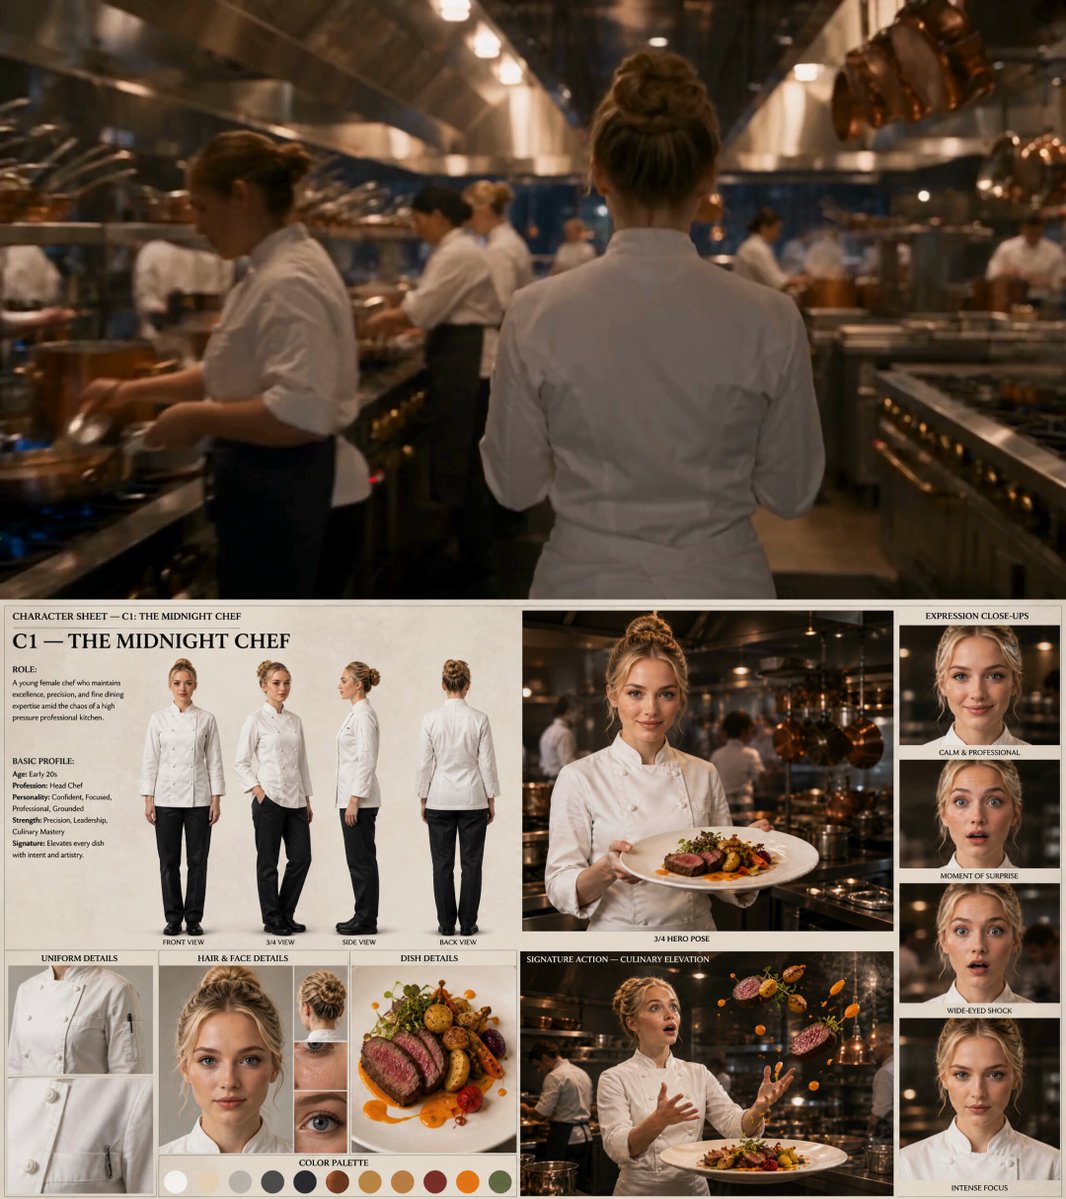
Der zuverlässigste Weg zu Konsistenz ist ein festes Referenzset. Man erstellt von jeder Hauptfigur drei bis fünf Ansichten: frontal, Halbprofil, Ganzkörper, dazu ein Detailbild von Gesicht und Kleidung. Diese Bilder dienen als Basis für jeden Clip.
Bildfusion und Stiltransfer helfen, unterschiedliche Elemente zusammenzuführen: eine Figur aus einem Foto, ein Hintergrund aus einem Render, eine Lichtstimmung aus einer Filmreferenz. Entscheidend ist, dass alle Quellen in Farbtemperatur und Kontrast zueinander passen. Mischt man einen warmen Sonnenuntergang mit einem kühlen Studiolicht, wirkt jede Einstellung wie aus einem anderen Film.
Storyboard und Shot-Liste als Rückgrat
Vor der ersten Generierung steht ein Storyboard, und sei es nur eine skizzenhafte Folge von acht bis zwölf Feldern. Jede Einstellung bekommt einen Eintrag mit Nummer, Einstellungsgröße, Figur, Handlung, Kamerabewegung und gewünschter Dauer. Diese Liste ist der eigentliche Regieplan. Wer ohne sie generiert, produziert schöne Einzelbilder ohne Zusammenhang – und muss am Ende die Hälfte verwerfen.
Ein praktischer Zusatz: Für jede Einstellung zwei bis drei Varianten erzeugen und sofort nummerieren. Ohne klare Dateinamen verliert man nach zwanzig Clips den Überblick.
Der Workflow in acht Schritten
Ein funktionierender Ablauf für ein Projekt mit einer Länge von 30 bis 90 Sekunden sieht so aus:
- Konzept und Skript. Eine halbe Seite Text, die beschreibt, was in welcher Reihenfolge passiert. Kein Drehbuchformat, nur Klarheit über Anfang, Wendung und Ende.
- Shot-Liste. Zwölf bis zwanzig Einstellungen mit Größe, Figur, Handlung, Dauer. Alles über fünf Sekunden pro Einstellung wird zunächst skeptisch behandelt.
- Referenzbilder. Figuren, Schauplätze und wichtige Requisiten als Standbilder erzeugen oder auswählen. Hier lohnt die meiste Zeit.
- Styleframe. Ein einzelnes Bild, das Licht, Farbe und Textur des gesamten Videos definiert. Es dient als Vergleichsmaßstab für alle weiteren Generierungen.
- Animierung. Einstellung für Einstellung als Bild-zu-Video, jeweils zwei bis drei Varianten. Sofort aussortieren, was nicht passt.
- Ton. Stimme, Atmosphäre, Musik und Geräusche. Getrennt produzieren und erst im Schnitt zusammenführen.
- Schnitt. Grobe Auswahl, dann Feinschnitt auf Rhythmus. Übergänge bewusst setzen, nicht jeden Clip mit einem Effekt überdecken.
- Finish. Farbkorrektur, Bildstabilisierung, Upscaling, Tonmischung, Export in der Zielauflösung.
Der wichtigste Rat zu diesem Ablauf: Nicht alles gleichzeitig optimieren. Erst die Auswahl, dann die Feinheit. Wer jede Einstellung perfektioniert, bevor die Reihenfolge steht, verliert Tage.
Ton, Stimme und Musik: der unterschätzte Teil der Pipeline
Video ohne Ton wirkt immer unfertig, selbst wenn die Bilder stark sind. Umgekehrt kann guter Ton mittelmäßige Bilder tragen. Der Ton ist deshalb kein Anhang, sondern ein eigenes Produktionssegment.
Für Sprachaufnahmen gibt es zwei Wege. Der erste ist klassische Vertonung mit echten Sprecherinnen und Sprechern – teurer, aber in Nuancen unschlagbar. Der zweite ist Sprachsynthese mit Werkzeugen wie ElevenLabs oder vergleichbaren Systemen. Moderne Stimmen klingen in ruhigen Passagen überzeugend; bei starker Emotionalität, Schreien oder Flüstern wird es schwieriger. Ein bewährter Kompromiss: Erzählstimme synthetisch, Dialogpassagen mit echten Stimmen.
Musik und Atmosphäre lassen sich ebenfalls generieren, etwa mit Suno oder Udio, oder aus lizenzfreien Bibliotheken beziehen. Wichtig ist die Abstimmung auf den Schnitt: Ein Musikstück, das nicht auf die Einstellungslängen reagiert, erzeugt sofort ein amateurhaftes Gefühl. Besser ist es, den Schnitt zuerst zu setzen und die Musik danach anzupassen – oder umgekehrt eine feste Musikstruktur als Taktgeber zu verwenden und den Schnitt danach zu bauen.
Raumklang und Geräusche werden oft vergessen. Schritte, Wind, Papier, ein fernes Auto: Diese Details verankern eine Szene in der Realität. Sie müssen nicht realistisch passen, sie müssen nur konsistent sein. Ein Innenraum ohne jede Hallreflexion klingt wie ein Sprechzimmer, nicht wie ein Wohnzimmer.
Postproduktion: Warum rohe KI-Clips selten fertig sind
Kaum ein generierter Clip ist direkt sendefähig. Typische Schwächen sind leichte Unschärfe, flackernde Details, instabile Texturen im Hintergrund und ein Rauschen, das bei Bewegung wandert. Die Nachbearbeitung ist deshalb fest eingeplant.
Bildstabilisierung glättet unruhige Kamerabewegungen. Upscaling mit Werkzeugen wie Topaz Video AI erhöht die Auflösung und schärft Details, wobei zu aggressives Schärfen schnell künstlich wirkt. Frame-Interpolation kann eine Sequenz von 16 auf 24 Bilder pro Sekunde heben, sollte aber sparsam eingesetzt werden, weil sie bei schnellen Bewegungen Geisterbilder erzeugt.
Im Schnittprogramm – DaVinci Resolve, Premiere Pro, After Effects oder vergleichbare Tools – geht es dann um das Handwerk: Rhythmus, Blickführung, Übergänge, Farbanpassung. Ein wichtiger Punkt ist die Vereinheitlichung. Clips aus verschiedenen Modellen haben unterschiedliche Farbprofile und Kornstrukturen. Eine gemeinsame Farbkorrektur, ein leichtes Korn über alle Einstellungen und eine konsistente Kontrastkurve binden sie zusammen.
Ein letzter Schritt, der oft fehlt: der Ton. Pegel angleichen, Musik unter die Stimme ducken, Höhen und Tiefen leicht bearbeiten. Das kostet zwanzig Minuten und verändert den wahrgenommenen Produktionswert stärker als jede weitere Generierungsrunde.
Typische Fehler und wie man sie vermeidet
Der häufigste Fehler ist zu viel Handlung pro Clip. Modelle werden unzuverlässig, sobald mehrere Figuren gleichzeitig etwas tun. Lösung: Handlung in kleinere, klar getrennte Einstellungen zerlegen.
Der zweite Fehler ist fehlende Referenzdisziplin. Wer für jede Einstellung neue Bilder erzeugt, verliert die Kontinuität. Lösung: ein festes Referenzset pro Figur und Schauplatz.
Der dritte Fehler ist Überprompting. Zu viele Adjektive, widersprüchliche Stilangaben und lange Negativlisten machen das Ergebnis beliebig. Lösung: kurze, konkrete Prompts mit maximal zwei Stilangaben.
Der vierte Fehler ist fehlende Dateistruktur. Zwanzig Varianten ohne klare Benennung führen dazu, dass gute Takes verloren gehen. Lösung: Projektordner mit Unterordnern für Referenzen, Rohclips, ausgewählte Takes und Ton.
Der fünfte Fehler ist das Überspringen des Tons bis zum Schluss. Wer erst nach dem finalen Schnitt mit der Vertonung beginnt, muss oft Szenen umbauen. Lösung: Tonparallel zur Bildgenerierung planen.
Der sechste Fehler ist unrealistische Erwartung an Konsistenz. Modelle sind Werkzeuge, keine Studios. Wer begreift, dass Nachbearbeitung ein Teil der Arbeit ist und nicht ein Zeichen von Schwäche, produziert deutlich entspannter.
Rechenzeit, Kontingente und Teamprozesse realistisch planen
KI-Video ist rechnerisch teuer. Jede Generierung belegt Hardware für Sekunden bis Minuten, und die Wartezeit summiert sich schnell zu Stunden. Für Planung bedeutet das: Varianten kosten Zeit, nicht nur Geld. Wer pro Einstellung fünf Versuche einplant, braucht für zwölf Einstellungen sechzig Durchläufe. Das ist in einem Abend nicht zu schaffen.
Eine realistische Kalkulation sieht pro fertiger Einstellung zwei bis drei verwertbare Ergebnisse vor. Dazu kommen Ausschuss und Tests mit neuen Prompts. Ein Projekt von einer Minute Länge umfasst erfahrungsgemäß vier bis acht Arbeitsstunden, verteilt über mehrere Sitzungen, wenn Sorgfalt gewünscht ist.
Für Teams hilft eine klare Rollenverteilung. Eine Person verantwortet Referenzbilder und visuelle Konsistenz, eine zweite die Generierung und Auswahl, eine dritte Ton und Schnitt. Bei kleinen Teams können zwei Personen diese Rollen abdecken. Wichtig ist, dass die Auswahlentscheidung bei einer Person liegt. Abstimmungen per Umfrage verlangsamen den Prozess und führen zu Kompromissen, die niemanden überzeugen.
Ein weiterer Punkt ist die Wiederverwertung. Referenzbilder, Styleframes, Prompt-Bibliotheken und Tonbausteine sollten archiviert werden. Mit jedem Projekt wächst ein Fundus, der die nächste Produktion deutlich beschleunigt. Wer alles neu erfindet, arbeitet dauerhaft im Anfängermodus.
FAQ
Brauche ich mehrere Modelle für ein Projekt?
In der Regel ja, aber nicht viele. Ein Modell für Referenzbilder, eines für Animation und eines für Spezialfälle wie Stiltransfer oder Motion Transfer decken die meisten Projekte ab. Mehr Modelle bedeuten mehr Abstimmungsaufwand bei Farbe und Korn.
Wie lang sollte ein einzelner KI-Clip sein?
Kurz. Drei bis fünf Sekunden sind robust, acht bis zehn Sekunden funktionieren bei ruhigen Einstellungen. Alles darüber leidet meist unter driftenden Details. Längere Sequenzen entstehen durch Montage mehrerer kurzer Einstellungen.
Wie verhindere ich, dass Gesichter verschwimmen?
Gesichter sollten im Startbild groß genug und scharf sein. Im Prompt lässt sich ruhige Kopfbewegung statt schneller Drehung anfordern. Zusätzlich hilft eine niedrigere Bewegungsstärke, falls das Werkzeug diese Einstellung bietet.
Eignen sich KI-Clips für Werbung und Social Media?
Für Konzeptfilme, Moodvideos und kurze Formate sehr gut. Bei Produktdarstellungen mit exakten Logos und Schriftzügen ist Vorsicht geboten: Text im Bild bleibt eine Schwachstelle. Hier ist es besser, Produkt und Text in der Nachbearbeitung zu ergänzen.
Wie wichtig ist ein Storyboard wirklich?
Sehr wichtig, sobald mehr als drei Einstellungen geplant sind. Ohne Storyboard fehlt die Grundlage für Konsistenz und für die Auswahl. Ein Storyboard kann aus einer Tabelle bestehen; es muss keine Zeichnung sein.
Was mache ich, wenn eine Einstellung partout nicht funktioniert?
Erst den Prompt vereinfachen, dann die Einstellung umplanen. Oft liegt das Problem nicht am Modell, sondern an einer zu komplexen Anforderung. Eine andere Perspektive, eine andere Einstellungsgröße oder ein anderer Bildausschnitt löst das Problem meist schneller als der zwanzigste Versuch mit demselben Prompt.
Lohnt sich der Einstieg ohne Vorkenntnisse in Schnitt und Ton?
Der Einstieg ist niedrigschwellig, das Handwerk bleibt aber entscheidend. Wer Grundlagen in Bildkomposition, Schnittrhythmus und Tonpegeln lernt, produziert mit demselben Werkzeug deutlich bessere Ergebnisse. Die Werkzeuge ersetzen diese Kenntnisse nicht, sie verstärken sie.
