
Lego Pixel w skrócie: klatka jako zestaw modułów
Generowanie wideo oparte na sztucznej inteligencji osiągnęło poziom, na którym pojedyncze ujęcie potrafi wyglądać jak materiał z planu zdjęciowego: realistyczne światło, wiarygodna perspektywa, płynny ruch. Problem pojawia się wtedy, gdy trzeba powtórzyć ten efekt w kolejnym ujęciu, zmienić jedną rzecz bez psucia dziesięciu innych albo dopasować wynik do storyboardu, który już istnieje. Wtedy okazuje się, że typowy prompt opisowy daje efekt „ładny, ale nieprzewidywalny”.
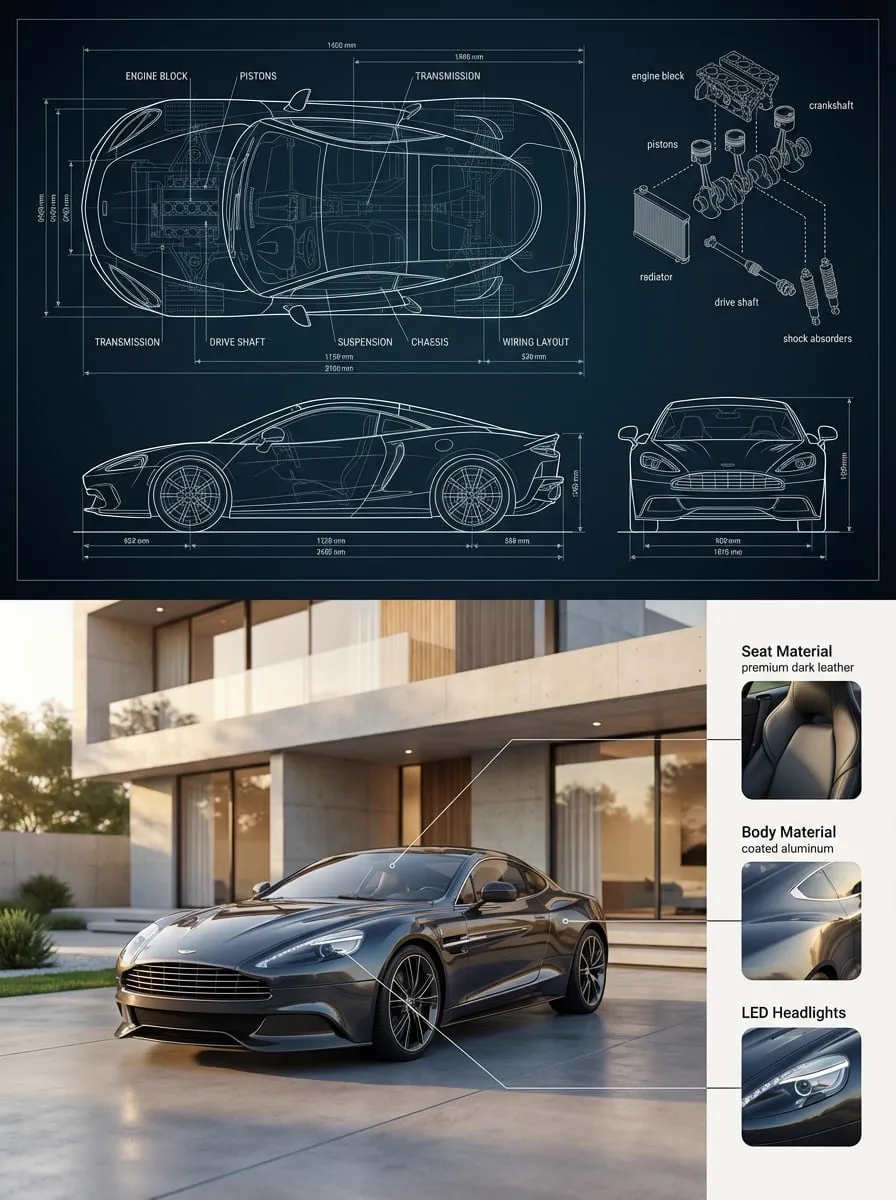
Lego Pixel to podejście, które traktuje obraz wejściowy nie jako monolityczną całość, lecz jako zestaw modułów. Zanim model zacznie przewidywać kolejne klatki, materiał referencyjny zostaje rozłożony na warstwy: semantyczne (kto i co jest w kadrze), geometryczne (gdzie i jak ułożone są obiekty), optyczne (światło, ogniskowa, głębia ostrości) oraz stylistyczne (paleta, tekstura, ziarno). Każdy z tych modułów można opisać, podmienić, zablokować lub zmodyfikować niezależnie od pozostałych.
Efekt jest prosty do wyjaśnienia, choć trudny do osiągnięcia tradycyjnymi metodami: zamiast liczyć, że model „domyśli się” intencji, dostarczasz mu strukturę. Zamiast zgadywania, dostajesz kontrolę. Zamiast pojedynczego szczęśliwego trafienia, dostajesz powtarzalny proces.
To szczególnie ważne w produkcji, w której liczy się ciągłość: serialu reklamowym, teledysku, kursie wideo albo serii materiałów produktowych. W takich projektach ta sama bohaterka, ten sam produkt czy ta sama lokalizacja muszą wyglądać identycznie w kilkudziesięciu ujęciach. Lego Pixel jest odpowiedzią właśnie na to wyzwanie — nie zastępuje kreatywności, ale usuwa z procesu losowość, która normalnie pożera czas.
Jak działa modułowa dekompozycja obrazu
Sercem techniki jest dekompozycja. Model nie analizuje obrazu jako jednej płaskiej mapy pikseli, ale rozbija go na warstwy znaczeniowe, które można opisywać językiem i adresować osobno. Dopiero po tej dekompozycji następuje reasemblacja — złożenie modułów z powrotem w spójną klatkę, która staje się punktem startowym dla generowania ruchu.
Warstwy semantyczne, geometryczne i optyczne
Warstwa semantyczna odpowiada na pytanie „co to jest”. To obiekty, postacie, ich atrybuty: kurtka, kolor włosów, model buta, marka opakowania. Warstwa geometryczna opisuje relacje przestrzenne: postać po lewej, produkt na pierwszym planie, horyzont w górnej trzeciej części kadru. Warstwa optyczna zbiera parametry kamery i światła: kierunek światła, kontrast, głębia ostrości, przybliżona ogniskowa, temperatura barwowa. Warstwa stylistyczna definiuje wygląd: ziarno, kontrast, korekcja kolorów, charakterystykę obiektywu.
Rozdzielenie tych warstw ma ogromne znaczenie praktyczne. Jeśli chcesz zmienić tylko porę dnia, modyfikujesz warstwę optyczną i nie ruszasz semantycznej. Jeśli chcesz przestawić bohatera w kadrze, zmieniasz geometrię i nie psujesz tożsamości postaci. W tradycyjnym podejściu każda taka zmiana wymaga przepisania całego promptu, co często kończy się niekontrolowaną zmianą kilku elementów naraz.
Reasemblacja: z modułów do spójnej klatki kluczowej
Reasemblacja to proces odwrotny: z opisanych modułów powstaje klatka kluczowa, która jest wewnętrznie spójna. Model musi zadbać o to, aby światło z warstwy optycznej pasowało do geometrii, aby styl nie kłócił się z materiałem, aby obiekty nie przenikały się ani nie unosiły nad podłożem. To tutaj ujawnia się przewaga podejścia modułowego — konflikty między warstwami są wykrywane na etapie opisu, a nie dopiero po wyrenderowaniu całego ujęcia.
W praktyce reasemblacja przypomina pracę z warstwami w programie graficznym. Masz kontrolę nad tym, co jest zablokowane, a co edytowalne. Możesz zachować twarz bohatera i jednocześnie zmienić tło, zachować tło i zmienić garderobę, zachować kompozycję i zmienić porę dnia.
Dlaczego dekompozycja poprawia stabilność czasową
Największym problemem generowania wideo nie jest pierwsza klatka, ale klatka setna. Modele mają tendencję do „dryfowania”: kolory blakną, kształty się rozmywają, a postacie zyskują lub tracą cechy. Kiedy klatka startowa jest opisana modułowo, model ma stały punkt odniesienia dla każdej warstwy. To ogranicza dryf, bo semantyczne i geometryczne kotwice nie zmieniają się z klatki na klatkę.
W testach produkcyjnych największą różnicę widać nie w pojedynczych, efektownych ujęciach, ale w długich sekwencjach, w których liczy się konsekwencja: rozmowie dwóch osób, ujęciu produktu obracającego się o 360 stopni, przejściu kamery przez kilka pomieszczeń.
Praktyczny workflow: od referencji do gotowego ujęcia
Poniższy proces sprawdza się zarówno w małych projektach jednoosobowych, jak i w zespołach, w których generator wideo jest jednym z narzędzi w pipeline.
Przygotowanie materiału referencyjnego
Zacznij od jednego lub dwóch obrazów referencyjnych o wysokiej jakości. Wybierz kadr, który jasno pokazuje bohatera, światło i kompozycję. Jeśli budujesz serię, przygotuj osobną referencję dla postaci, osobną dla lokalizacji i osobną dla produktu. Nie mieszaj ich w jednym pliku — modułowość zaczyna się już na etapie organizacji plików.
Warto też opisać referencję tekstowo. Krótka lista cech („kobieta, czarne włosy związane w kok, beżowy płaszcz, światło okna z lewej”) działa lepiej niż akapit prozy, ponieważ łatwiej ją przypisać do konkretnych warstw.
Dekompozycja i opis modułów
Rozłóż scenę na moduły i opisz każdy z osobna. Zwróć uwagę na elementy, które muszą pozostać niezmienne w całym projekcie — to twoje kotwice. Zaznacz też elementy, które będą się zmieniać (tło, pora dnia, kąt kamery). Dzięki temu wiesz, co wolno modyfikować bez ryzyka utraty spójności.
Typowy błąd na tym etapie to nadmiar szczegółów w jednym module. Jeśli w warstwie optycznej opisujesz jednocześnie światło, obiektyw i kolor nieba, tracisz możliwość zmiany jednego z nich. Lepiej trzymać opisy krótkie i rozłączne.
Reasemblacja i pierwszy test ruchu
Po opisaniu modułów wygeneruj krótki test — trzy do pięciu sekund. Nie oceniaj go pod kątem urody, ale pod kątem zgodności z założeniami: czy postać wygląda jak w referencji, czy światło jest po właściwej stronie, czy kamera porusza się zgodnie z planem. Test ruchu ujawnia problemy, których nie widać na statycznej klatce.
Kontrola kamery, światła i tempa
Dopiero po zatwierdzeniu testu rozszerz ujęcie do docelowej długości. Ustal parametry kamery: kierunek, prędkość, czy jest to najazd, odjazd, pan, czy ujęcie statyczne. Ustal tempo ruchu bohatera i dopasuj je do planowanego montażu. W praktyce warto generować kilka wariantów tempa i wybierać najlepszy na etapie montażu, a nie w generatorze.
Iteracja, selekcja i eksport
Ostatni etap to iteracja. Zmieniaj jedną warstwę na raz i porównuj wyniki. Jeśli poprawiasz jednocześnie światło i kostium, nie będziesz wiedzieć, co dało efekt. Przygotuj prostą tabelę wariantów: numer, zmieniona warstwa, ocena. Po kilku projektach zobaczysz, że część ustawień powtarza się jak presety — i właśnie wtedy proces staje się naprawdę szybki.
Kontrola optyczna i kinematograficzna w praktyce
Ogniskowa, perspektywa i głębia ostrości
Warstwa optyczna pozwala naśladować decyzje operatora kamery. Możesz zasugerować szeroki kąt z wyraźną perspektywą, neutralną ogniskową dokumentalną albo teleobiektyw kompresujący tło. Głębia ostrości to jedno z najsilniejszych narzędzi narracyjnych: ostre tło sugeruje reportaż, rozmyte tło kieruje wzrok na bohatera. W podejściu modułowym te parametry są opisane osobno, więc można je zmieniać bez redefiniowania całej sceny.
Ruch obiektów i spójność dynamiki
Spójność dynamiki oznacza, że wszystko w kadrze porusza się w jednym, wiarygodnym rytmie. Jeśli bohater idzie szybko, tło nie może przesuwać się w tempie żółwia. Jeśli wiatr porusza włosami, powinien też delikatnie oddziaływać na tkaninę. Modułowe opisy ruchu pomagają modelowi utrzymać te zależności, a twórcy — wychwycić momenty, w których coś „nie gra”, jeszcze przed renderem końcowym.
Redukcja artefaktów i poprawa jakości wizualnej
Większość artefaktów w generowanym wideo bierze się z niejednoznaczności: model nie wie, czy dany obszar to cień, czy osobny obiekt. Jasny podział na warstwy zmniejsza tę niejednoznaczność. Dodatkowo warto pracować z materiałem o wyższej rozdzielczości na wejściu, a upscaling zostawić na koniec. Generowanie w wysokiej rozdzielczości od początku bywa kosztowne i częściej prowadzi do niespójności ruchu.
Spójność narracyjna i tożsamość postaci
Ciągłość wieloujęciowa
Najtrudniejsze zadanie w generowaniu wideo to utrzymanie tej samej postaci w wielu ujęciach. Modułowa dekompozycja pomaga, bo tożsamość postaci staje się osobnym, zablokowanym modułem. Możesz zmieniać kadr, tło, porę dnia i kostium, a mimo to zachować rysy twarzy, proporcje i charakterystyczne detale.
Scenografia, kostium i rekwizyty jako moduły
Traktuj kostium i rekwizyty jak oddzielne warstwy, nie jak część postaci. Dzięki temu w scenie „ta sama bohaterka, inny sweter” zmieniasz tylko jeden element. To szczególnie przydatne w reklamie, gdzie produkt musi być widoczny i spójny, a jednocześnie scena wymaga wariantów kolorystycznych lub sezonowych.
Praca z wieloma bohaterami w jednym ujęciu
Przy dwóch lub więcej postaciach ryzyko zamiany twarzy i cech rośnie. Warto opisywać każdą postać osobno, wskazywać relacje przestrzenne i unikać sytuacji, w której obie są zwrócone do kamery pod tym samym kątem. Zróżnicowanie pozycji, kierunku spojrzenia i tempa ruchu znacząco zmniejsza liczbę błędów.
Typowe błędy i jak ich unikać
Zbyt długi prompt opisowy. Im więcej treści w jednym akapicie, tym trudniej przypisać ją do modułów. Rozbij opis na krótkie, rozłączne bloki.
Mieszanie warstw. Światło opisane razem z garderobą oznacza, że zmiana jednego pociąga za sobą drugie. Trzymaj warstwy osobno.
Brak referencji dla kluczowych elementów. Jeśli postać istnieje tylko w opisie słownym, każdy render będzie interpretacją. Dodaj obraz referencyjny.
Testowanie na docelowej długości ujęcia. Generowanie trzydziestu sekund, gdy nie wiadomo, czy trzy sekundy są poprawne, to najczęstszy sposób marnowania czasu.
Zmiana wielu parametrów naraz. Bez kontroli wariantów nie da się ustalić, co faktycznie poprawiło jakość.
Ignorowanie montażu. Ujęcie, które wygląda dobrze w izolacji, może nie pasować do rytmu całej sceny. Zawsze oceniaj w kontekście.
Lego Pixel czy klasyczny prompt? Kryteria wyboru
Nie każdy projekt wymaga modułowej dekompozycji. Klasyczny prompt opisowy jest szybszy przy jednorazowych, eksperymentalnych ujęciach, w których liczy się efekt zaskoczenia. Sprawdza się w moodboardach, testach koncepcji i materiałach, które nie wymagają powtarzalności.
Modułowa kontrola wygrywa, gdy:
- potrzebujesz tej samej postaci w więcej niż trzech ujęciach,
- pracujesz z produktem, który musi wyglądać identycznie w każdym kadrze,
- musisz dopasować wynik do istniejącego storyboardu,
- zespół ocenia warianty i potrzebuje powtarzalnych ustawień,
- projekt ma wiele wersji językowych lub formatowych (16:9, 9:16, 1:1).
Decyzję warto podejmować per projekt, a nie per narzędzie. W praktyce najlepsze efekty daje hybryda: najpierw szybkie, opisowe poszukiwania kierunku wizualnego, a po wybraniu koncepcji — pełna modułowa dekompozycja do produkcji.
Narzędzia i stos technologiczny
Nie potrzebujesz jednego konkretnego programu, żeby pracować modułowo. Liczy się sposób myślenia i organizacja pracy. Przydatny stos wygląda zwykle tak:
- Generator obrazu do tworzenia i dopracowywania referencji postaci, produktu i lokalizacji.
- Generator wideo obsługujący obrazy referencyjne oraz sterowanie kamerą.
- Edytor warstwowy lub program graficzny do przygotowania referencji i czyszczenia tła.
- Narzędzie do upscalingu stosowane na końcu, nie na początku.
- Montaż do oceny rytmu i ciągłości całej sekwencji.
- Arkusz wariantów — zwykły dokument z numerami ujęć, zmienionymi warstwami i ocenami.
Ostatni punkt brzmi banalnie, ale w praktyce decyduje o powtarzalności. Bez notatek po tygodniu nie odtworzysz ustawień, które dały najlepszy efekt.
FAQ: najczęstsze pytania o Lego Pixel
Czy Lego Pixel wymaga specjalnego oprogramowania? Nie. To metoda organizacji pracy, którą można stosować w różnych generatorach wideo i obrazu. Narzędzia się zmieniają, zasada podziału na warstwy pozostaje.
Ile czasu zajmuje dekompozycja? Przy pierwszym projekcie od kilkunastu minut do godziny na scenę. Przy kolejnych znacznie krócej, bo opisy i presety się powtarzają.
Czy to działa przy krótkich materiałach w social media? Tak, szczególnie przy seriach. Jeśli publikujesz kilka wariantów tego samego ujęcia w różnych formatach, modułowa struktura oszczędza najwięcej czasu.
Czy modułowe podejście ogranicza kreatywność? Wręcz przeciwnie. Uwalnia od walki z technicznymi przypadkami i pozwala skupić się na decyzjach artystycznych — świetle, tempie, kompozycji.
Co jeśli model nie respektuje zablokowanych warstw? Zmniejsz liczbę modułów w jednym przebiegu, skróć ujęcie, zwiększ jakość referencji i sprawdź, czy opisy nie są sprzeczne.
Czy da się łączyć moduły z różnych projektów? Tak, to jedna z największych zalet. Sprawdzony moduł światła czy kostiumu można przenieść do nowego projektu i zaoszczędzić cały etap testów.
Checklista wdrożenia
Zanim zaczniesz renderować docelowe ujęcia, upewnij się, że masz: referencję postaci, referencję lokalizacji, opis warstwy optycznej, zablokowane moduły tożsamości, zdefiniowany ruch kamery, krótki test ruchu oraz arkusz wariantów. To sześć punktów, które w praktyce decydują o tym, czy projekt skończy się w kilka godzin, czy w kilka dni.
Modułowe przetwarzanie obrazu nie jest magicznym przyciskiem. Jest sposobem na uporządkowanie pracy z modelami generatywnymi tak, aby wynik był przewidywalny, a zespół mógł na nim polegać. W projektach, w których liczy się ciągłość — a takich jest coraz więcej — właśnie ta przewidywalność staje się najcenniejszą cechą procesu.
