
Warum Charakterkonsistenz das schwierigste Problem im KI-Video bleibt
Wer regelmäßig mit generativen Modellen arbeitet, kennt das Muster: Ein einzelner Clip sieht spektakulär aus, doch sobald dieselbe Figur in einer zweiten Einstellung auftaucht, wirkt sie wie ein anderer Mensch. Die Augen sitzen anders, das Kinn ist schmaler, die Frisur hat plötzlich einen anderen Ansatz, und die Jacke wechselt von Dunkelblau zu Grau. Zuschauer bemerken solche Sprünge in Sekundenbruchteilen, auch wenn sie nicht benennen können, was genau falsch ist. Genau deshalb ist Charakterkonsistenz keine technische Randnotiz, sondern die Grenze zwischen einer hübschen Demo und einer Serie, die man über mehrere Folgen hinweg glaubt.
Die Ursache liegt in der Funktionsweise der Modelle. Jede Generierung beginnt mit Rauschen und formt daraus ein Bild oder eine Sequenz, gesteuert durch Text und je nach Modell durch zusätzliche Bildinformationen. Ohne Bildreferenz ist die Figur nur eine Beschreibung: junge Frau, dunkle Locken, grüne Augen, Lederjacke. Diese Beschreibung ist ein Raum voller Möglichkeiten, und das Modell wählt bei jedem Durchlauf einen anderen Punkt darin. Konsistenz entsteht erst, wenn du diesen Raum auf einen engen Bereich einschränkst. Genau das leistet die Multi-Image-Fusion.
Für wiederkehrende Formate ist das entscheidend. Denk an eine Erklärserie mit einer festen Moderatorin, an einen Markencharakter in kurzen Social-Clips, an eine Animationsgeschichte mit drei Hauptfiguren oder an ein Werbeformat, in dem dieselbe Person in fünf Umgebungen auftritt. In all diesen Fällen ist die Figur das eigentliche Kapital. Wenn sie driftet, wirkt das gesamte Projekt unprofessionell, egal wie gut Licht, Kamera und Schnitt sind.
Der zweite Grund, warum das Thema so wichtig ist: Video verstärkt jeden Fehler. Ein Bild mit leicht abweichender Nasenform fällt kaum auf. Sobald sich diese Abweichung aber über sechs Sekunden bewegt und in der nächsten Einstellung auf einen anderen Kopf trifft, entsteht ein Bruch, den das Publikum sofort spürt. Konsistenzarbeit ist deshalb vor allem Vorarbeit, nicht Nacharbeit.
Multi-Image-Fusion verständlich erklärt
Multi-Image-Fusion bedeutet, dass mehrere Referenzbilder derselben Figur gemeinsam ausgewertet und als eine Art visueller Anker in jeden Generierungsschritt eingespeist werden. Statt nur zu beschreiben, wie eine Person aussieht, zeigst du sie aus mehreren Winkeln, und das Modell leitet daraus ein gemeinsames Identitätsmuster ab. Dieses Muster überlagert die reine Textbeschreibung und zieht jedes neue Bild in Richtung der gezeigten Figur.
Was beim Bündeln technisch passiert
Ein Referenzbild wird nicht als Pixelhaufen verwendet, sondern in eine kompakte mathematische Repräsentation übersetzt, häufig als Embedding bezeichnet. Dieses Embedding enthält keine vollständige Kopie des Bildes, sondern statistische Merkmale: Proportionen, Konturen, Texturverteilung, Farbtendenzen, Gesichtsgeometrie. Bei der Fusion werden mehrere solcher Vektoren zu einem gemeinsamen Vektor kombiniert, oft gewichtet, damit ein besonders klares Frontalporträt stärker wirkt als ein unscharfes Profil. Dieser kombinierte Vektor wird dann während der Diffusion in den Generierungsprozess injiziert, entweder über eine Referenz-Conditioning-Schicht, über einen bildbasierten Adapter oder über eine Kombination aus beidem.
Wichtig ist die Reihenfolge: Die Textbeschreibung definiert die Szene, die Referenz definiert die Person. Wenn beide widersprechende Aussagen machen, gewinnt meist der stärkere Steuerungspfad. Deshalb solltest du im Prompt nichts beschreiben, was der Figur widerspricht. Ein Referenzbild mit kurzen Haaren und der Satz lange wallende Mähne im selben Prompt erzeugen einen Kompromiss, der weder dem einen noch dem anderen entspricht.
Warum ein einzelnes Referenzbild selten reicht
Ein einziges Bild trägt immer den Ballast seiner Aufnahmesituation. Ist die Person von unten fotografiert, überträgt sich diese Perspektive. Ist das Licht warm und seitlich, neigt das Modell dazu, diese Lichtstimmung auch in Szenen zu reproduzieren, in denen sie nicht passt. Trägt die Figur auf dem Referenzbild eine Kapuze, wird die Kapuze zum Teil der Identität. Mit mehreren Bildern mittelst du diese Einflüsse aus und trennst das, was die Person ausmacht, von dem, was nur die Aufnahme ausmachte.
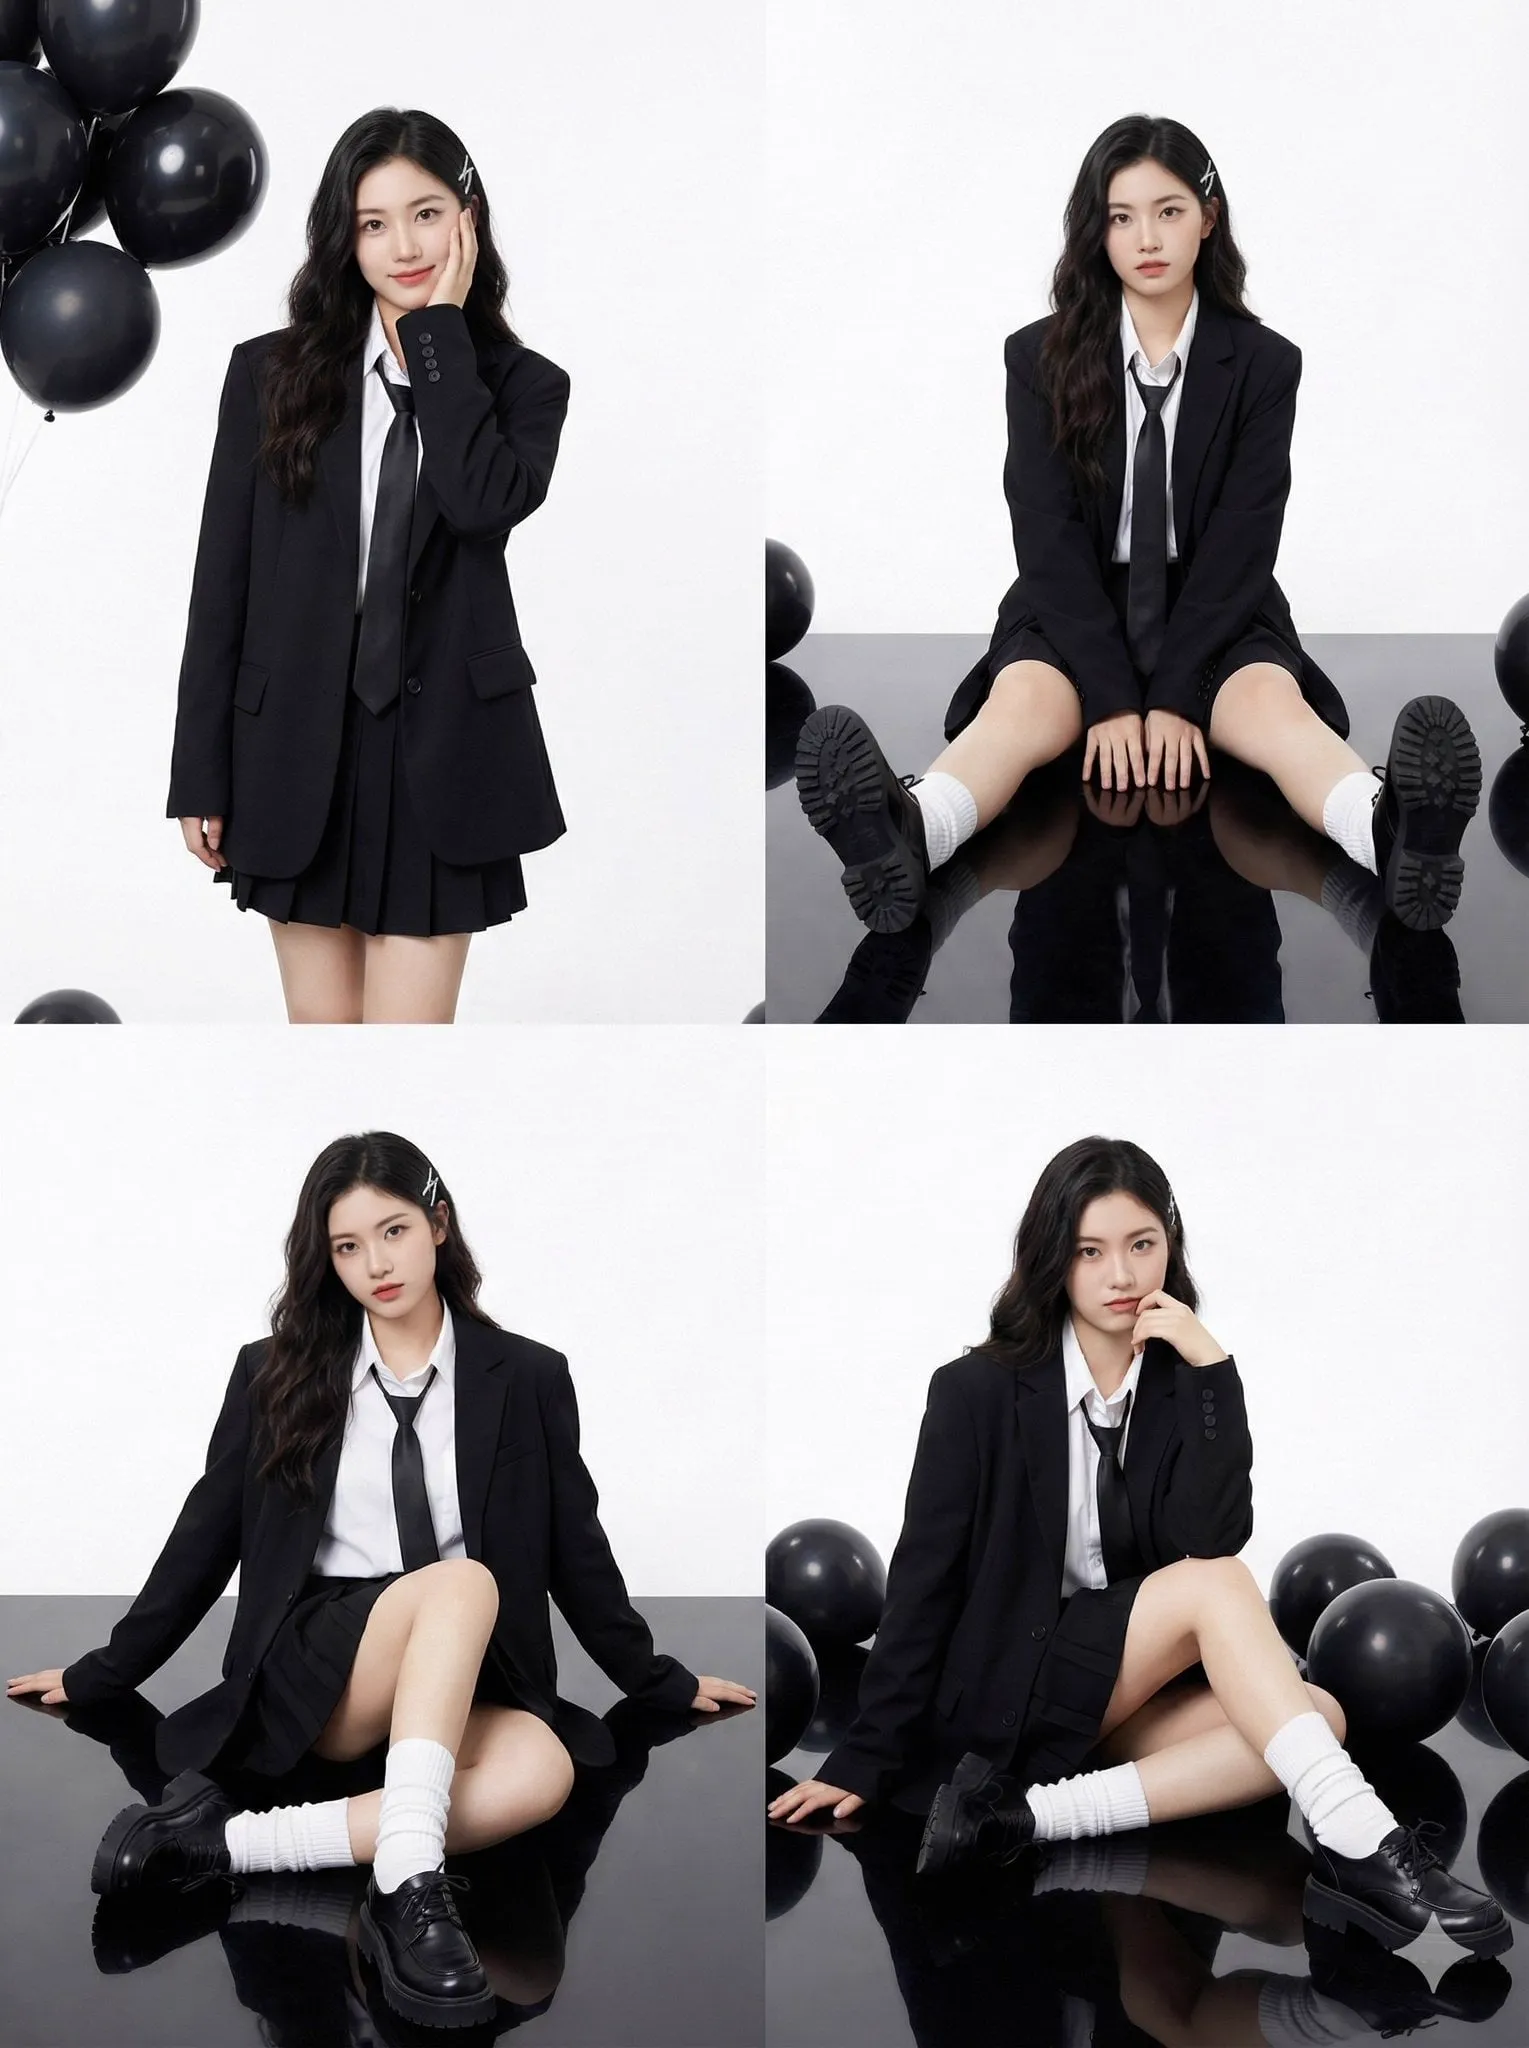
Fünf bis zwölf gute Referenzen sind in der Praxis ein solider Arbeitsbereich. Zu wenige Bilder lassen zu viel Spielraum, zu viele ähnliche Bilder verstärken einseitige Merkmale. Die Mischung entscheidet: mindestens ein klares Frontalporträt, ein Dreiviertelwinkel, ein Profil, eine Ganzkörperaufnahme sowie ein oder zwei Aufnahmen mit anderen Lichtstimmungen.
Was Fusion nicht leistet
Multi-Image-Fusion repariert keine schlechte Anatomie, ersetzt keine Szenenplanung und garantiert keine Garderobenkontinuität, wenn der Prompt bei jedem Shot andere Kleidung beschreibt. Sie ist ein Stabilisator, kein Regisseur. Je klarer deine übrige Vorarbeit ist, desto besser funktioniert sie.
Referenzmaterial richtig vorbereiten
Die Qualität der Fusion hängt fast linear an der Qualität der Eingangsbilder. Hier entscheidet sich, ob du später zehn Minuten nachbesserst oder zwei Stunden.
Auswahl der Bilder
Wähle Bilder, die die Person in verschiedenen Zuständen zeigen, ohne die Identität zu verwischen. Geeignet sind neutrale Mimik, offene Augen, klar erkennbare Gesichtskonturen und einfache Kleidung ohne auffällige Muster. Ungeeignet sind Sonnenbrillen, starke Weitwinkelverzerrungen, Bewegungsunschärfe, Filter mit Farbstichen, Wasserzeichen und extreme Grimassen, wenn sie nicht zur Rolle gehören.
Ein praktischer Test: Wenn du zwei Bilder nebeneinanderlegst und spontan sagen kannst, dass es dieselbe Person ist, taugen beide. Wenn du zögern musst, sortiere das schwächere aus. Das Modell hat weniger Kontext als du und trifft dieselbe Entscheidung nur unzuverlässiger.
Bereinigung und Vereinheitlichung
Schneide alle Referenzen so zu, dass der Kopf einen ähnlichen Anteil der Bildfläche einnimmt. Unterschiedliche Bildformate sind technisch meist kein Problem, aber stark abweichende Proportionen erschweren die Fusion. Entferne störende Hintergründe oder ersetze sie durch eine neutrale Fläche, damit das Modell keine Umgebungsmerkmale als Identitätsmerkmal lernt. Skaliere die Bilder auf eine Auflösung, die das Zielmodell nativ versteht, und speichere sie verlustarm.
Der Konsistenzcheck vor dem ersten Render
Erstelle eine Kontaktbogen-Ansicht aller Referenzen und notiere fünf bis sieben Ankerpunkte in Worten: Form des Kiefers, Brauenverlauf, Haaransatz, Ohrform, Augenabstand, Nasenrücken, besondere Merkmale wie Muttermale oder Narben. Diese Liste ist später dein Prüfprotokoll. Wenn ein generiertes Bild nicht zu mindestens vier dieser Ankerpunkte passt, ist es unbrauchbar, egal wie schön es aussieht.
Den Charakter-Prompt als Bauplan schreiben
Ein häufiger Fehler ist, den Prompt als Erzählung zu behandeln. Für konsistente Arbeit ist er besser ein Bauplan mit klar getrennten Ebenen.
Drei Ebenen sauber trennen
Die erste Ebene ist die Identität und bleibt über das gesamte Projekt unverändert: Alter, Gesichtsform, Haarstruktur, Augenfarbe, Grundstatur. Die zweite Ebene ist das Styling und bleibt über eine Sequenz hinweg stabil: Kleidung, Accessoires, Frisur-Detail, Materialien. Die dritte Ebene ist der Zustand und wechselt pro Shot: Pose, Blickrichtung, Emotion, Licht, Brennweite, Umgebung.
Wenn du diese Ebenen in getrennten Textbausteinen hältst, kannst du die dritte Ebene frei variieren, ohne versehentlich die erste zu überschreiben. Viele Inkonsistenzen entstehen nicht durch das Modell, sondern durch Prompts, in denen bei Shot vier plötzlich ein anderer Haarschnitt mitschwingt, weil jemand beim Umschreiben eine Formulierung geändert hat.
Formulierungen, die zuverlässig funktionieren
Konkrete Substantive schlagen vage Adjektive. Statt schön und markant besser klar definierte Konturen, schmale Lippen, hohe Stirn. Vermeide Sätze wie dieselbe Person wie zuvor. Modelle haben kein Gedächtnis für frühere Durchläufe, sie kennen nur das, was im aktuellen Lauf als Bedingung anliegt. Konsistenz kommt über die Referenz und über identische Textbausteine, nicht über Erinnerungsappelle.
Referenzstärke richtig dosieren
Fast jedes System mit Bildreferenz bietet einen Regler für die Stärke. Zu niedrig, und die Figur driftet. Zu hoch, und du bekommst Kopien der Referenzpose, flache Beleuchtung oder ein starres Gesicht, das nicht zur Szene passt. Ein sinnvoller Startbereich liegt bei etwa 0,6 bis 0,85. Für ruhige Porträts darf es höher sein, für dynamische Action mit starker Perspektive niedriger. Probiere drei Stufen pro Shot aus und vergleiche am Kontaktbogen, nicht am Einzelbild.
Workflow Schritt für Schritt: von der Figur zur Szene
Schritt 1: Master-Referenz erzeugen
Wenn du keine echten Fotos verwenden kannst oder darfst, erzeuge zuerst eine Master-Figur per Text-zu-Bild. Arbeite so lange an dieser einen Figur, bis sie deine Ankerpunkte erfüllt. Rendere anschließend Variationen derselben Figur in verschiedenen Winkeln, mit unterschiedlicher Beleuchtung und in verschiedenen Outfits. Aus diesen Variationen baust du dein Referenzset. Das klingt nach Umweg, spart aber später die Hälfte der Korrekturschleifen.
Schritt 2: Szenenliste und Shot-Plan
Bevor du ein einziges Video renderst, schreibe die Szenen als Tabelle. Für jeden Shot gehören mindestens diese Felder hinein:
| Feld | Beispiel |
|---|---|
| Shot-ID | S02-A03 |
| Zweck | Reaktion auf die Nachricht |
| Einstellungsgröße | Halbnah |
| Pose | sitzend, Oberkörper gedreht |
| Licht | weiches Fensterlicht von links |
| Dauer | 4 Sekunden |
| Referenz-Set | Figur A, Set 2 |
| Prüfanker | Kiefer, Brauen, Haaransatz |
Der Shot-Plan ist gleichzeitig dein Qualitätsvertrag. Ohne ihn merkst du erst beim Schnitt, dass drei Einstellungen in einer Lichtstimmung fehlen.
Schritt 3: Fusion pro Shot steuern
Rendere jeden Shot einzeln als Standbild, bevor du bewegte Sequenzen erzeugst. Standbilder sind schnell, günstig und leicht zu vergleichen. Erst wenn ein Standbild alle Ankerpunkte erfüllt, animierst du es. Dieser Zwischenschritt reduziert Ausschuss drastisch, weil sich Fehler in der Identität in einem Einzelbild viel klarer zeigen als in einem wackeligen Clip.
Schritt 4: Bewegung kurz halten und überlappend arbeiten
Kurze Clips von drei bis sechs Sekunden bleiben stabiler als lange Takes. Arbeite mit leichten Überlappungen zwischen den Einstellungen und schneide auf Bewegung. Wenn die Figur im letzten Frame einer Einstellung dieselbe Kopfhaltung hat wie im ersten Frame der nächsten, wirkt der Übergang deutlich flüssiger, auch wenn die beiden Clips unabhängig entstanden sind.
Schritt 5: Korrektur im Bildraum, nicht im Videoschnitt
Wenn eine Figur driftet, versuche nicht, das im Schnitt zu kaschieren. Gehe einen Schritt zurück in die Standbildphase, erhöhe die Referenzstärke, tausche das schwächste Referenzbild aus oder schärfe die Identitätsformulierung im Prompt. Erst danach neu animieren. Nachträgliche Weichzeichner und Farbkorrekturen verdecken einen Identitätsbruch nur oberflächlich.
Modellwahl: worauf es wirklich ankommt
Nicht jedes Modell nutzt Bildreferenzen gleich gut. Es lohnt sich, die Kandidaten nach drei Kriterien zu bewerten: Stabilität über mehrere Shots, Reaktionsfreudigkeit auf Referenzstärke und Kontrolle über Kamera und Bewegung.
Kontrollbasierte Modelle
Modelle wie Flux, Runway, Sora, Kling oder Veo wurden unterschiedlich stark auf Referenzsteuerung optimiert. Generell gilt: Je mehr explizite Kontrollkanäle ein System bietet, desto reproduzierbarer wird die Figur, aber desto mehr Einarbeitung braucht es. Für Porträtserien mit wenig Bewegung sind diese Systeme erste Wahl, weil sie Gesichtsdetails präzise halten.
Schnelle Consumer-Modelle
Systeme, die auf Tempo und Einfachheit optimiert sind, liefern beeindruckende Einzelergebnisse, driften aber schneller, sobald dieselbe Figur über viele Shots hinweg auftritt. Sie eignen sich gut für Einzelclips, Storyboards und Konzepttests, weniger für eine zwölfteilige Serie ohne zusätzliche Bildkontrolle.
Hybride Pipelines
Wer maximale Kontrolle will, kombiniert Werkzeuge: Figurenerzeugung und Referenzpflege in einem Bildmodell, Zwischenkontrolle über Pose und Tiefe, Animation in einem Videomodell, Zusammenbau im Schnittprogramm. In solchen Pipelines ist das Referenzset ein eigenes Asset mit Versionierung. Es lohnt sich, jede Änderung am Set zu dokumentieren, weil ein einzelnes ausgetauschtes Bild die gesamte Ausstrahlung verändern kann.
Häufige Fehler und wie du sie behebst
Zu ähnliche Referenzen. Neun Variationen desselben Frontalporträts verstärken dieselbe Fehlstelle. Füge bewusst andere Winkel hinzu.
Hintergrund als Identität. Ein markanter Hintergrund wird mitgelernt. Nutze neutrale Flächen oder entferne den Hintergrund.
Widersprüchliche Prompts. Referenz und Text müssen dieselbe Person beschreiben. Streiche widersprechende Adjektive.
Wechselnde Wortbausteine. Wenn du den Identitätsblock pro Shot neu formulierst, driftet die Figur auch ohne Modellfehler. Kopiere den Block unverändert.
Zu lange Einstellungen. Ab etwa acht Sekunden steigt die Wahrscheinlichkeit sichtbarer Identitätsverschiebungen deutlich.
Animation vor Bildkontrolle. Wer direkt Videos rendert, bezahlt Fehler mit Zeit. Erst Standbild, dann Bewegung.
Harte Lichtsprünge. Ein Wechsel von hartem Gegenlicht zu weichem Innenlicht irritiert zusätzlich. Führe Lichtwechsel über Zwischeneinstellungen ein.
Kein Prüfprotokoll. Ohne Ankerliste wird die Bewertung Geschmackssache. Mit Liste wird sie reproduzierbar.
Checkliste für wiederholbare Ergebnisse
- Referenzset aus fünf bis zwölf Bildern, gemischt in Winkel und Licht
- neutrale Hintergründe, keine Filter, keine Wasserzeichen
- fünf bis sieben schriftlich fixierte Identitätsanker
- getrennte Prompt-Blöcke für Identität, Styling und Zustand
- Referenzstärke pro Shot getestet, nicht pauschal gesetzt
- Shot-Plan mit Prüfankern und geplanter Dauer
- Standbild-Freigabe vor jeder Animation
- Clips von drei bis sechs Sekunden, überlappend geschnitten
- versioniertes Referenzset mit Notizen zu jeder Änderung
Wenn du diese Punkte einhältst, wird Konsistenz zu einem Prozess statt zu einem Glücksspiel. Das ist der eigentliche Gewinn: Du kannst eine Figur über zwanzig Einstellungen führen, ohne bei jeder neuen Szene von vorn zu beginnen.
FAQ
Reichen zwei Referenzbilder für eine Serie? Für kurze Formate mit wenig Bewegung ja, für alles darüber hinaus nein. Ab etwa fünf Shots zeigt sich Drift meist deutlich.
Sollte ich echte Fotos oder generierte Referenzen verwenden? Beides funktioniert. Generierte Referenzen haben den Vorteil, dass du Winkel, Licht und Outfit gezielt steuern kannst, ohne Rechtefragen bei Fremdmaterial.
Warum sieht meine Figur in Nahaufnahmen anders aus als in Totalen? Gesichtsdetails skalieren, aber Proportionen verschieben sich. Prüfe deine Anker für beide Einstellungsgrößen getrennt und ergänze bei Bedarf eine Ganzkörperreferenz.
Wie gehe ich mit mehreren Hauptfiguren um? Arbeite mit getrennten Referenzsets und rendere pro Shot möglichst nur eine Figur im Vordergrund. Mehrere Gesichter in einem Frame erhöhen die Driftgefahr erheblich.
Was mache ich bei Kleidungswechsel innerhalb einer Szene? Behandle das Outfit als eigene Referenzgruppe und beschreibe den Wechsel explizit im Zustandsblock, nicht im Identitätsblock.
Kann ich eine fertige Figur später weiterverwenden? Ja, sofern du das Referenzset inklusive Notizen archivierst. Ein sauber dokumentiertes Set ist mehr wert als jede einzelne gelungene Einstellung.
Wie viele Versuche pro Shot sind normal? Bei einem gepflegten Set sind zwei bis vier Standbildversuche üblich. Deutlich mehr deutet meist auf ein Problem im Referenzmaterial hin, nicht auf den Prompt.
Lohnt sich der Aufwand für einen einzelnen Clip? Nur bedingt. Multi-Image-Fusion entfaltet ihren Nutzen vor allem dort, wo dieselbe Figur mehrfach auftritt.
