
Perché la narrazione visiva è diventata un problema di processo
Fino a pochi anni fa raccontare una storia per video significava una cosa sola: trovare il budget. Troupe, attrezzatura, location, attori, tempi di post-produzione. Chi non aveva quei mezzi poteva al massimo parlare davanti a una webcam. Oggi la barriera non è più economica, è organizzativa. Un creator singolo può generare centinaia di inquadrature in un pomeriggio, ma se non ha un metodo si ritrova con un disco pieno di clip scollegate e nessuna storia da raccontare.
È qui che si concentra la vera trasformazione portata dai modelli generativi: non la fine della creatività, ma lo spostamento del collo di bottiglia dalla produzione alla regia. Il valore non sta nel generare una singola immagine spettacolare, ma nel decidere quale inquadratura serve, in che ordine, con quale ritmo e con quale coerenza rispetto alle altre. Chi interiorizza questo principio produce contenuti che sembrano professionali; chi lo ignora produce demo tecniche, magari bellissime, che nessuno guarda fino alla fine.
Questa guida non è una carrellata di annunci. È un metodo di lavoro: come impostare una pipeline per video e podcast, con quali criteri scegliere gli strumenti, dove i flussi si rompono e come capire se la qualità sta davvero salendo invece di limitarsi ad aumentare il numero di clip prodotte.
Dal prompt al controllo cinematografico: cosa è cambiato davvero
Il primo salto culturale è avvenuto quando il testo ha smesso di essere l’unico input. Scrivere una descrizione e sperare in un risultato accettabile è la fase più primitiva del lavoro con l’AI, e anche la più frustrante: si ottiene varietà, raramente continuità. Un uomo che cammina sotto la pioggia verrà generato cento volte in cento modi diversi, e nessuno di quei cento uomini sarà lo stesso uomo.
Oggi il controllo si costruisce su livelli, e capire quale livello serve in ogni momento è la competenza più richiesta. Non è una questione di software: è una questione di come si pensa una scena.
I livelli di controllo, in ordine di precisione
- Testo verso video: si descrive la scena. Ottimo per esplorare, per moodboard animate, per capire se un’idea regge. Pessimo per sequenze che devono restare identiche a se stesse.
- Immagine verso video: si parte da un fotogramma già approvato. È il livello che garantisce il maggior controllo sul look, perché composizione, luce e costume sono già decisi prima della generazione.
- Riferimenti multipli: si combinano più immagini — volto, abbigliamento, ambiente, stile — per mantenere un personaggio riconoscibile attraverso inquadrature diverse. È il livello che risolve la maggior parte dei problemi di continuità.
- Controllo strutturale: maschere di movimento, mappe di profondità, pose, traiettorie di camera. Serve quando la scena deve rispettare una geometria precisa o quando un movimento deve essere replicabile su più inquadrature.
Nella pratica si usano tutti e quattro, ma non nello stesso momento. Si esplora con il testo, si blocca il look con le immagini, si costruisce la continuità con i riferimenti multipli e si rifiniscono i movimenti difficili con il controllo strutturale. Chi salta i passaggi intermedi paga il conto in post-produzione.
Il problema della coerenza visiva
La maggior parte dei progetti fallisce qui. Un volto che cambia leggermente tra due inquadrature, un cappotto che diventa di un’altra tonalità, una finestra che si sposta di mezzo metro: dettagli che il pubblico non sa nominare ma percepisce come falso. Il cervello umano è straordinariamente sensibile ai dettagli incoerenti, e nessuna colonna sonora copre un errore di continuità.
La soluzione non è un modello magico, è la disciplina dei riferimenti. Prima di generare trenta clip, si prepara una scheda visiva: due o tre angolazioni del soggetto, un ambiente di riferimento, una palette, un’indicazione di luce. Ogni generazione parte da quella scheda, non dalla memoria di chi scrive il prompt. Sembra burocrazia, in realtà è la differenza tra un progetto che si chiude in due giorni e uno che non si chiude mai.
Come impostare una pipeline di produzione in sei fasi
Una pipeline non serve a rendere il lavoro ripetitivo, serve a rendere prevedibile la qualità. Le fasi seguenti funzionano sia per un video verticale da sessanta secondi sia per un episodio di podcast con inserti narrativi.
Concept, script e promessa
Prima di qualsiasi generazione, si scrive cosa deve capire lo spettatore nei primi tre secondi e cosa deve ricordare alla fine. Se queste due frasi non stanno in una riga ciascuna, il progetto non è pronto. Lo script non deve essere letterario: deve essere una sequenza di intenzioni visive. Scrivere la promessa prima delle immagini evita la trappola più comune, cioè costruire una sequenza tecnicamente splendida che non promette nulla.
Blocchi visivi e shot list
Si traduce lo script in inquadrature numerate, ognuna con funzione narrativa, durata prevista e livello di controllo richiesto. Qui si decide cosa sarà generato, cosa sarà girato realmente e cosa sarà grafica. Un errore comune è generare tutto: spesso un primo piano reale del conduttore, ripreso con il telefono, regge meglio di un volto sintetico e richiede un decimo del tempo. La shot list è anche il luogo in cui si pianifica il versioning: un’inquadratura centrata funziona sia in orizzontale sia in verticale, una composizione molto larga no.
Generazione in batch, non a singhiozzo
Le clip si producono a gruppi tematici, non una alla volta. Questo permette di confrontare varianti con gli stessi parametri, scartare rapidamente e mantenere uniforme il look. Tenere un foglio di produzione con modello usato, durata, riferimento e note di qualità evita di rigenerare la stessa scena tre volte a distanza di giorni, che è il modo più rapido per bruciare tempo e coerenza.
Selezione, montaggio e ritmo
La selezione è il momento in cui il progetto prende forma. Si eliminano le clip tecnicamente riuscite ma narrativamente inutili, anche quando sono le più spettacolari. Il montaggio lavora su tre livelli: ritmo dei tagli, continuità del suono, coerenza cromatica. Una buona regola è montare prima senza musica, poi aggiungere l’audio: se la sequenza non funziona muta, non funzionerà nemmeno con la colonna sonora perfetta.
Suono, voce e sottotitoli
Il suono è ciò che tradisce un video generato più di qualsiasi dettaglio visivo. Ambi di sottofondo coerenti, livelli di voce stabili, un lieve strato di room tone nelle scene sintetiche: pochi accorgimenti che spostano la percezione da artificiale a prodotto. I sottotitoli, oltre all’accessibilità, sono il formato di lettura principale su molte piattaforme, e vanno progettati con lo stesso rigore della grafica.
Versioning e distribuzione
Da un episodio lungo si ricavano verticali, teaser, caroselli, clip per community diverse. Il versioning pianificato in fase di shot list è la differenza tra pubblicare dieci contenuti e pubblicarne uno. Vale la pena definire in anticipo quante varianti servono e per quali piattaforme, perché ogni formato ha un ritmo diverso e non basta ritagliare un video quadrato.
Scegliere il modello giusto: criteri di decisione
Il panorama è ampio e cambia in fretta. Invece di inseguire l’ultima uscita, conviene valutare i modelli su criteri stabili, che restano validi anche quando cambiano i nomi degli strumenti.
Fotorealismo e look cinematografico
Se il progetto richiede pelle credibile, luce fisica, movimento di camera fluido, si sceglie un modello orientato alla resa fotografica, accettando tempi di generazione più lunghi e maggiore sensibilità ai prompt. Sono gli strumenti giusti per trailer, documentari brevi, pubblicità. Il rischio è la lentezza del ciclo di iterazione: se servono dieci tentativi per scena, il progetto si allunga in modo insostenibile.
Velocità ed efficienza per il formato breve
Per contenuti serrati, verticali, con molti tagli, conta la rapidità del ciclo di iterazione. Un modello che restituisce una clip discreta in pochi secondi permette dieci tentativi, e il decimo sarà probabilmente migliore del primo tentativo di un modello lento. In questi progetti la varietà visiva è un vantaggio, non un difetto: il pubblico scorre e non ha il tempo di notare piccole incoerenze.
Animazione, stile illustrato e controllo estremo
Per animazione, explainer e mondi stilizzati servono modelli con forte coerenza di stile e capacità di seguire riferimenti. Se la scena richiede geometrie precise, o un movimento di camera replicabile su più inquadrature, servono strumenti con input strutturati. Lo stile illustrato, per inciso, è spesso più indulgente del fotorealismo: le regole visive sono più elastiche e gli errori si leggono come scelte espressive.
Una griglia di valutazione pratica
Prima di adottare uno strumento, vale la pena rispondere a poche domande: quanto dura al massimo una clip utilizzabile? Come si comporta con input multipli? Quanto è stabile un volto su dieci generazioni consecutive? Quanto tempo passa tra richiesta e risultato quando il servizio è sotto carico? Che diritti ho sull’output? Che costi operativi avrò se il progetto cresce di dieci volte? Le risposte contano più della classifica dei modelli, perché nessuna classifica conosce il vostro caso d’uso.
Podcast video: dove l’AI entra nel formato conversazione
Il podcast video è il formato che più ha beneficiato di questi strumenti, proprio perché ha bisogno di continuità e di volume produttivo. Un episodio a settimana per un anno è un impegno che nessuna piccola produzione regge senza semplificazioni.
Set virtuali e identità visiva
Uno studio virtuale coerente — sfondo, luci, grafica, lower third — si costruisce una volta e si riusa per decine di episodi. L’AI serve a generare varianti stagionali, titoli animati, sfondi tematici, senza ricostruire un set fisico. La coerenza dell’identità visiva, in un podcast, è ciò che rende riconoscibile un episodio prima ancora che l’utente legga il titolo.
Clip verticali dai momenti migliori
La parte più dispendiosa di un podcast è la post-produzione delle clip brevi. Trascrizione, individuazione dei passaggi forti, ritaglio e riquadratura automatica riducono drasticamente i tempi. Il giudizio editoriale resta umano: l’algoritmo trova il momento in cui si alza la voce, non la battuta che merita di essere diffusa. La combinazione vincente è selezione automatica più una revisione manuale rapida, fatta da chi conosce il tono del programma.
Localizzazione e doppiaggio
Tradurre e doppiare un episodio è oggi molto più accessibile. Il limite non è tecnico ma di credibilità: un doppiaggio con lo stesso timbro in cinque lingue funziona per contenuti informativi, mentre per format basati sulla personalità conviene mantenere la voce originale e usare sottotitoli curati. Nei contenuti didattici, invece, la localizzazione automatica apre pubblici nuovi a costo quasi nullo.
Coerenza del personaggio: il vero collo di bottiglia
Se dovessi indicare un solo punto su cui investire tempo, sarebbe questo. La coerenza non si improvvisa con parole migliori nel prompt.
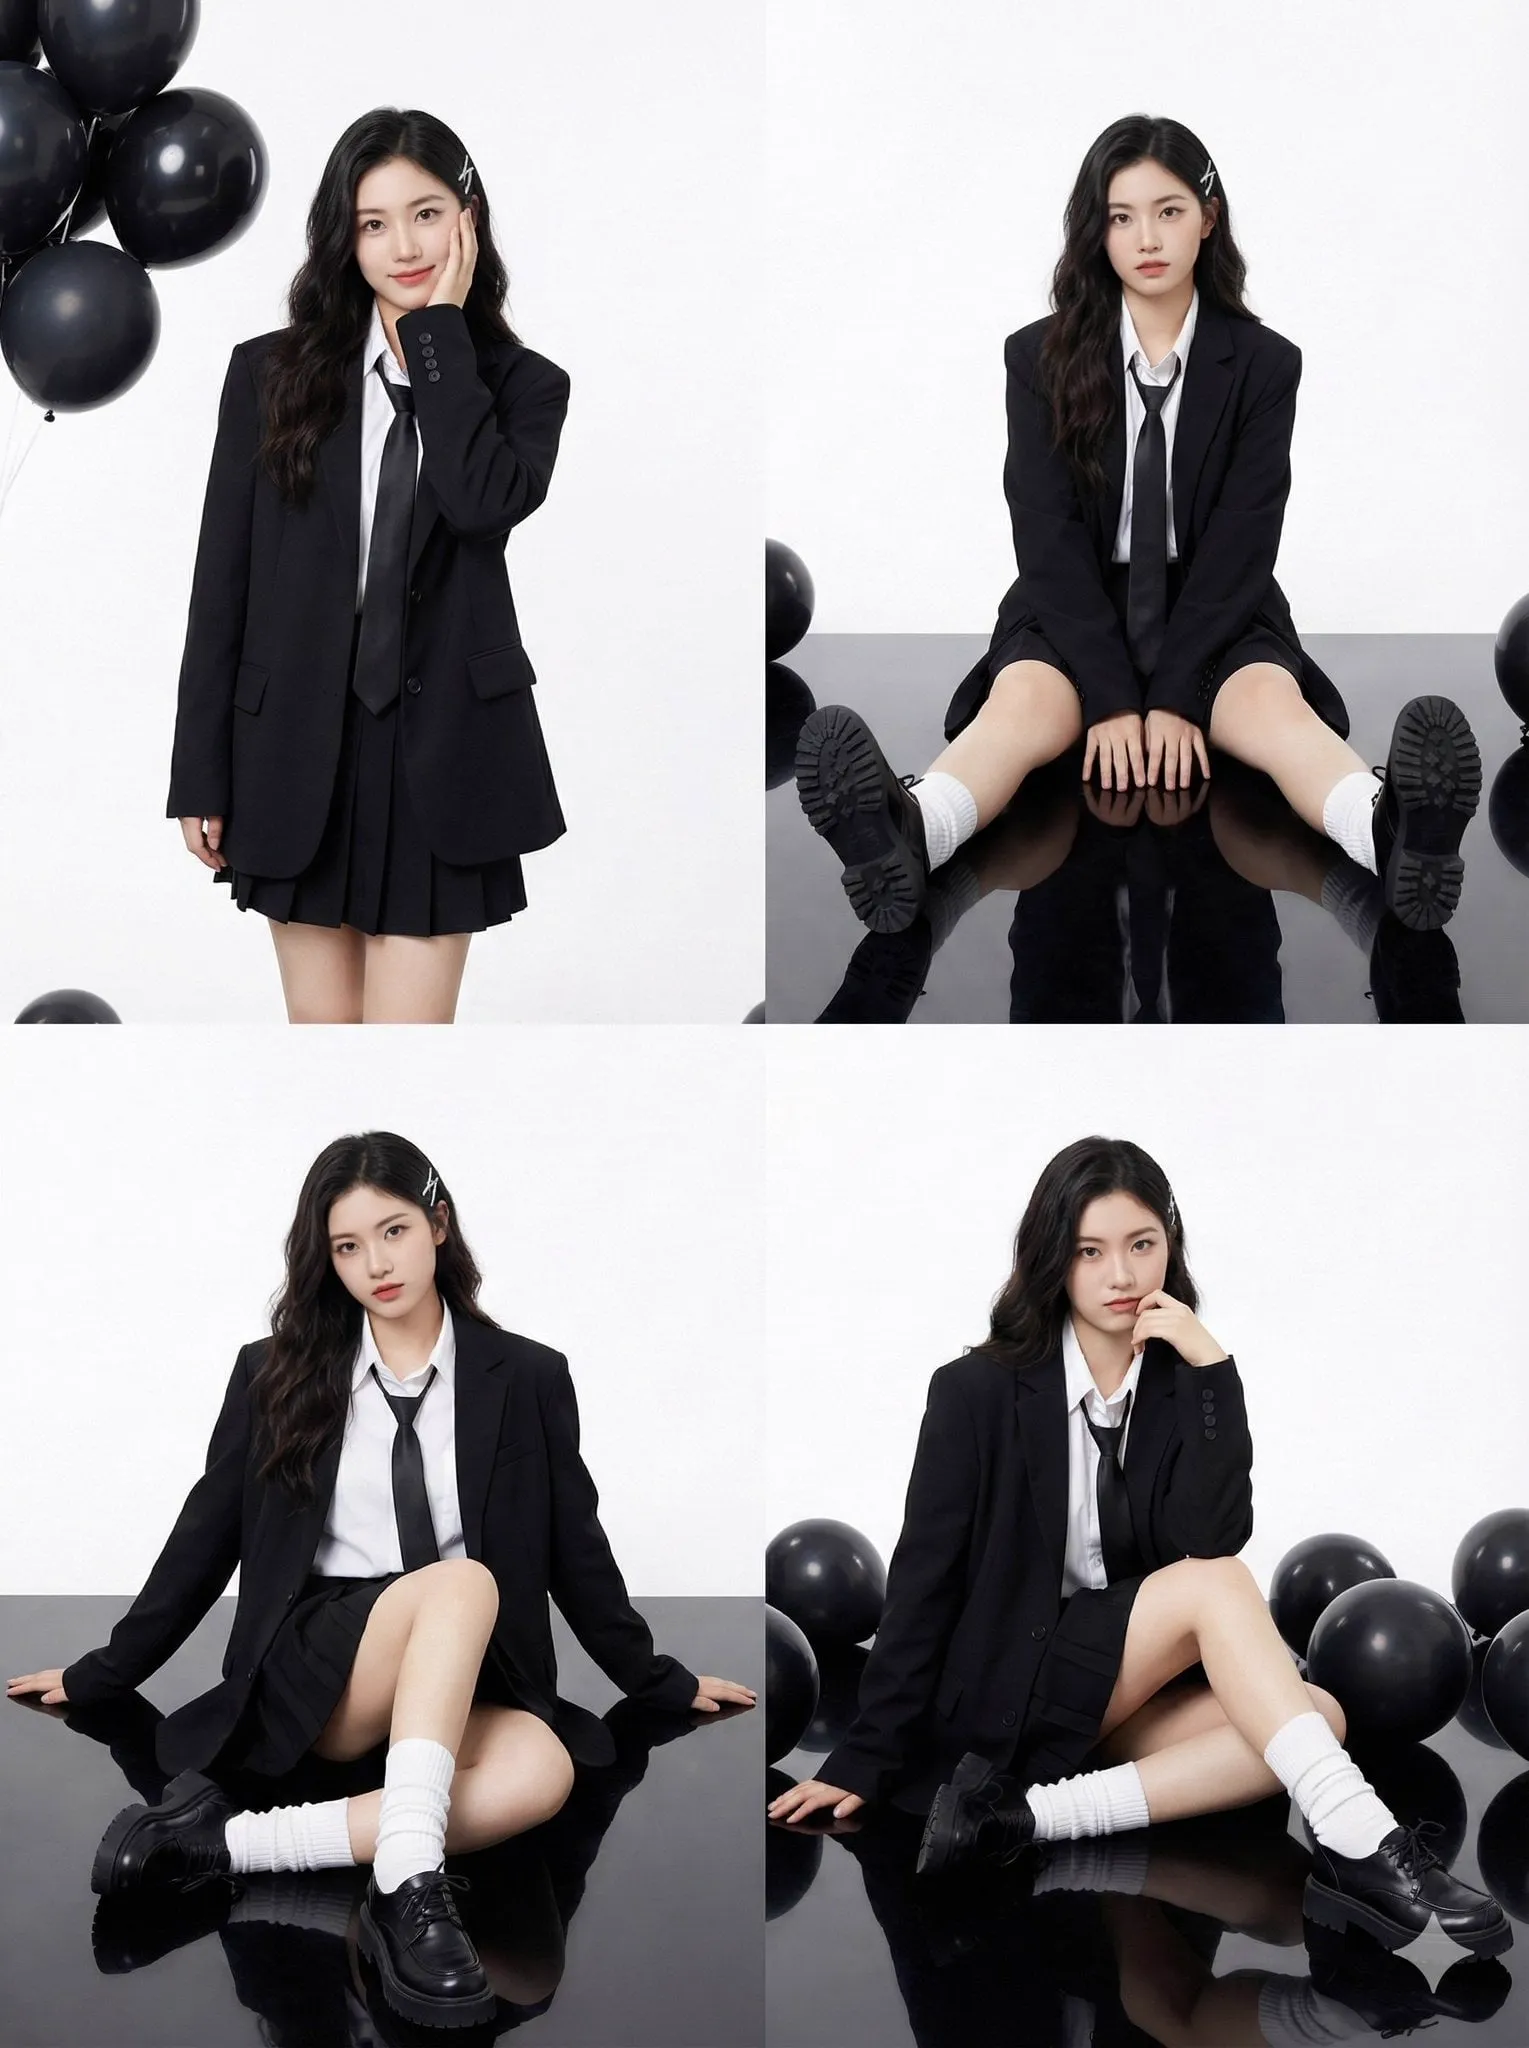
Una scheda personaggio operativa
Contiene: due volti frontali con espressioni diverse, un profilo, un dettaglio del vestiario, due riferimenti di ambiente, una palette e una breve descrizione della luce. Questa scheda entra in ogni generazione e viene aggiornata quando il personaggio cambia, non prima.
Regole di continuità
Mai cambiare più di due variabili per volta. Generare sempre lo stesso tipo di inquadratura con gli stessi riferimenti, prima di sperimentare angolazioni nuove. Tenere un archivio delle clip approvate: sono la base per verificare a occhio le derive, che si notano solo confrontando. E accettare un compromesso: un personaggio leggermente meno perfetto ma coerente funziona sempre meglio di un volto splendido che cambia identità ogni tre secondi.
Qualità, diritti e trasparenza: le regole non scritte
Poche aree sono confuse quanto quella dei diritti. Le domande utili: chi possiede l’output generato? Posso usarlo in campagne a pagamento? Il modello è addestrato su materiale di cui non conosco la provenienza? Esiste un obbligo di dichiarare la natura sintetica del contenuto?
Sul piano pratico, tre abitudini riducono il rischio: conservare file di progetto e prompt, evitare di imitare volti e voci riconoscibili di persone reali, dichiarare l’uso di contenuti sintetici quando il pubblico potrebbe trarne in inganno. Un’etichetta esplicita raramente danneggia un contenuto; una rivelazione scomoda, invece, danneggia eccome. Vale anche per la valutazione dei fornitori: una piattaforma che spiega con chiarezza che cosa si può fare con l’output è già un buon segnale.
Errori comuni che rovinano un progetto
- Generare prima di scrivere. Si accumulano clip belle e inutili.
- Rincorrere la perfezione su una singola inquadratura. Il pubblico ricorda la sequenza, non il fotogramma.
- Ignorare il suono. Un audio mediocre annulla un’immagine eccellente.
- Cambiare stile a metà progetto. La discontinuità si legge come errore, non come evoluzione.
- Non archiviare i parametri. Senza tracciabilità, ogni nuova clip è un esperimento che riparte da zero.
- Usare il volto sintetico dove basta la persona reale. Montare una ripresa reale è spesso più rapido che generarla.
- Distribuire senza contesto. Un video generato senza cornice narrativa sembra una dimostrazione tecnica.
- Moltiplicare i formati senza motivo. Cinque versioni dello stesso contenuto non equivalgono a cinque contenuti.
Cosa misurare per capire se la pipeline funziona
Le metriche utili, oltre alle solite visualizzazioni e alla ritenzione, sono di processo. Quante clip generate servono per ogni clip utilizzata? Qual è il tempo medio dall’idea alla pubblicazione? Quante volte si rigenera la stessa scena? Il tasso di riutilizzo dei riferimenti è alto o si ricomincia da capo ogni volta?
Se il rapporto tra clip generate e clip utilizzate è dieci a uno, il problema è di pianificazione, non di strumenti. Se è due a uno, la pipeline funziona. Un’altra metrica sottovalutata è la ritenzione nei primi tre secondi: se scende, nessuna qualità visiva salverà il contenuto. Infine, il tasso di commenti che parlano di contenuto invece che di estetica: è il segnale più affidabile che la storia funziona.
FAQ
Serve una GPU potente per iniziare?
No, ma cambia il tipo di lavoro. Con risorse limitate si pianifica meglio, si usano modelli più leggeri e si privilegia l’iterazione rapida rispetto alla resa massima. Spesso la qualità finale è simile: cambia il numero di tentativi, non il risultato.
Quanto dura realisticamente un episodio?
Un episodio di venti minuti con inserti generati richiede, per chi ha già una pipeline, circa una giornata tra script, generazione, selezione e montaggio. Le prime volte il tempo si moltiplica per tre: la curva di apprendimento è tutta nella gestione dei riferimenti.
Meglio generare tutto o mescolare riprese reali?
Mescolare. Le riprese reali del conduttore, degli oggetti, degli ambienti quotidiani danno autenticità e riducono il carico di generazione. L’AI dà il meglio su scene impossibili o costose, e il peggio su ciò che si potrebbe girare in trenta secondi.
Come si evita l’effetto tutto uguale?
Variando la scala delle inquadrature, il ritmo dei tagli e il suono, non cambiando modello a ogni clip. La varietà percepita nasce dal montaggio e dal ritmo, non dalla varietà degli strumenti.
Un volto generato può sostituire un presentatore?
Tecnicamente sì, in molti casi. In pratica il pubblico premia la presenza reale nei formati basati sulla personalità e accetta i volti sintetici in contenuti esplicativi o stilizzati, dove la riconoscibilità del volto non è il punto centrale.
Qual è il primo passo concreto?
Scrivere una shot list di dieci inquadrature, preparare una scheda personaggio con tre riferimenti e generare solo quelle dieci. Il resto diventerà chiaro lavorando. La narrazione visiva non è diventata più semplice: è diventata più accessibile. La differenza tra chi produce contenuti memorabili e chi accumula clip resta la stessa di sempre, cioè la capacità di decidere cosa mostrare e cosa tagliare.
