
Dlaczego spójność postaci to najtrudniejszy element produkcji wideo z AI
Generowanie pojedynczego, zachwycającego ujęcia przestało być problemem. Modele tekst-na-wideo i obraz-na-wideo radzą sobie z ruchem kamery, światłem i fakturą materiałów lepiej, niż jeszcze kilka lat temu ktokolwiek się spodziewał. Prawdziwy mur pojawia się w momencie, gdy te same ujęcia trzeba połączyć w spójną historię — a w każdym z nich ma wystąpić ta sama bohaterka, w tym samym stroju, z tym samym kształtem twarzy i tą samą fryzurą.
To właśnie tutaj projekt rozsypuje się najczęściej. Pierwsze ujęcie jest idealne. Drugie ma nieco inną linię żuchwy. Trzecie zmienia kolor tęczówek. Czwarte — i tu zaczyna się prawdziwy dramat — wygląda jak siostra bohaterki, nie jak ona sama. Widz nie potrafi wskazać palcem, co się zmieniło, ale czuje, że coś jest nie w porządku. Zaufanie do narracji znika w kilka sekund.
W profesjonalnych pipeline'ach wideo opartych na generatywnej sztucznej inteligencji spójność wizerunku przestała być dodatkiem, a stała się głównym kryterium jakości. Klient rzadko powie „to ujęcie jest zbyt płaskie”. Powtórzy natomiast „to nie ta sama osoba”. Dlatego kontrolę tożsamości postaci trzeba traktować jak dział produkcji, a nie jak detal, który dopieści się w postprodukcji.
Ten przewodnik opisuje kompletny sposób pracy: od przygotowania materiałów referencyjnych, przez technikę łączenia wielu obrazów w jedną kotwicę wizualną, aż po seryjne generowanie scen i wykrywanie dryftu, zanim trafi do montażu.
Anatomia dryftu postaci: skąd bierze się rozjazd wizerunku
Dryft postaci to stopniowa, ale kumulatywna zmiana cech wyglądu w kolejnych klatkach lub scenach. Nie jest to błąd jednego generowania — to efekt uboczny tego, jak modele dyfuzyjne interpretują niejednoznaczne wskazówki. Każda generacja to nowy rzut kostką, a model zawsze próbuje „poprawić” to, czego nie rozumie.
Cztery źródła dryftu
Niepełna referencja. Jeśli dostarczasz jedno zdjęcie twarzy, model nie wie, jak wygląda tył głowy, profil, dłonie ani sylwetka w ruchu. Musi więc wymyślić te elementy od nowa w każdym ujęciu — i za każdym razem wymyśla je inaczej.
Zmiana kontekstu sceny. Kiedy bohaterka przechodzi ze słonecznego wnętrza do nocnej ulicy, model przelicza kolory skóry, kontrast i temperaturę barw. Cechy tożsamości toną w tej reinterpretacji.
Dryft stylu. Jeśli w prompcie opisujesz styl ogólnie („cinematic”, „filmowy look”), każda scena może zostać zinterpretowana w innej palecie i innym ziarnie. Postać wygląda wtedy jak wycięta z dwóch różnych filmów.
Presja ruchu. Duże przemieszczenia kamery i szybkie gesty zmuszają model do interpolacji, w której detale twarzy tracą rozdzielczość najszybciej.
Jak mierzyć dryft w praktyce
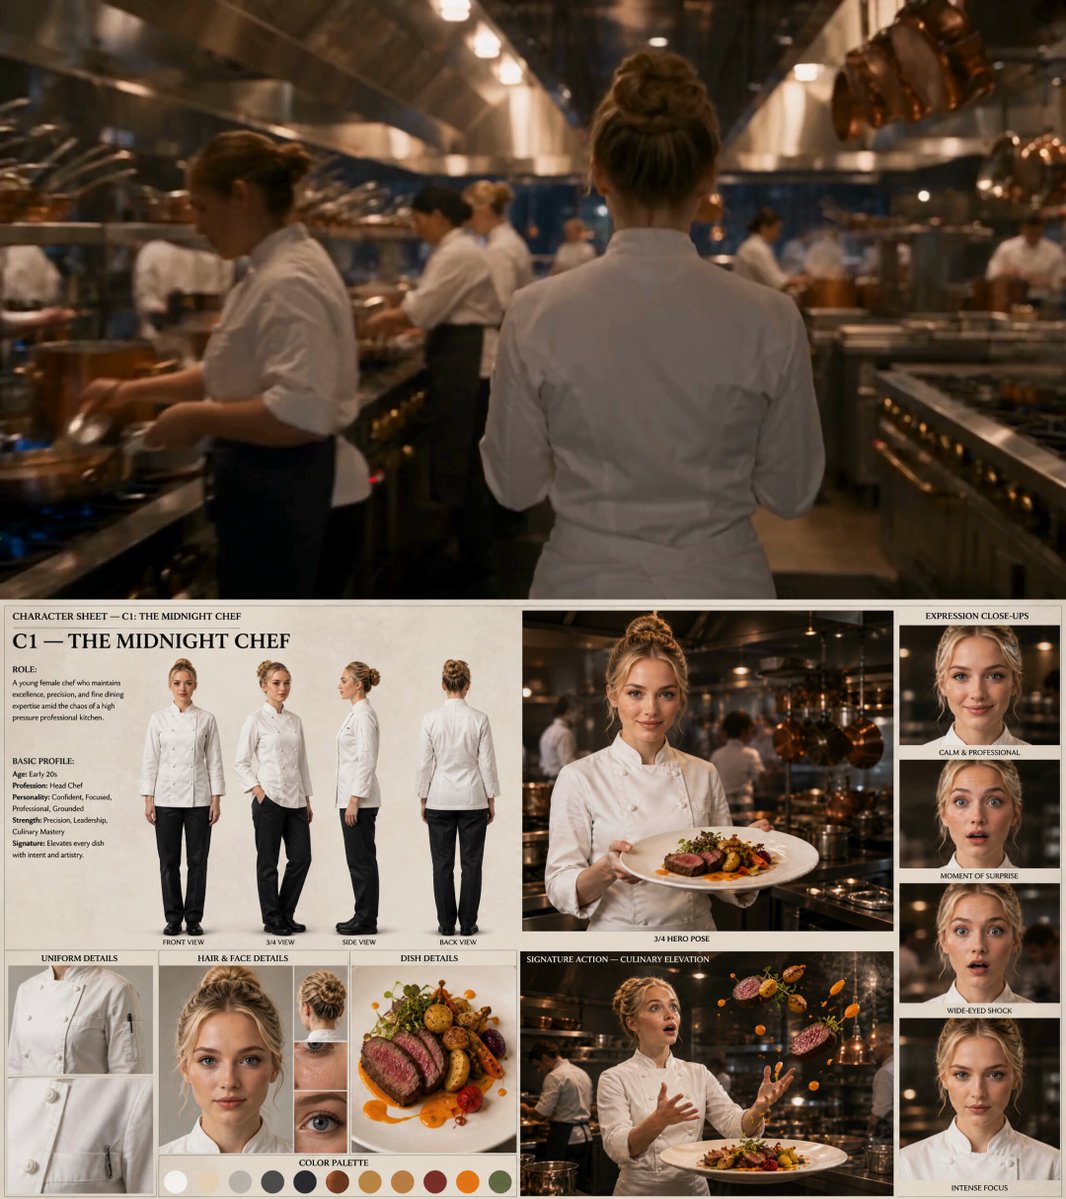
Najprostsza metoda to tak zwany arkusz tożsamości: pionowa lista kluczowych cech (kształt twarzy, odległość oczu, kształt nosa, usta, fryzura, kolor włosów, znaki szczególne, biżuteria, krój ubrania) i ocena każdego ujęcia w skali od jednego do pięciu. Ujęcia z oceną poniżej czterech trafiają do regeneracji, nie do montażu.
Druga metoda to przegląd "odwróconej miniatury": zmniejsz wszystkie ujęcia do rozmiaru ikony i obejrzyj je obok siebie. Mózg wychwytuje różnice w proporcjach znacznie szybciej na małym obrazie niż w pełnej rozdzielczości.
Kotwice wizualne: fundament powtarzalnego wizerunku
Kotwica wizualna to zestaw referencji, który definiuje postać raz i obowiązuje przez cały projekt. Dobra kotwica nie jest zdjęciem — jest dokumentacją postaci.
Od jednego zdjęcia do zestawu referencyjnego
Minimum funkcjonalne to sześć do ośmiu ujęć: frontalne, trzy czwarte w lewo, trzy czwarte w prawo, profil, ujęcie z lekkim uniesieniem głowy oraz dwa kadry obejmujące pół sylwetki. Do tego warto dodać zbliżenie oczu i szczegół charakterystycznego elementu — blizny, znamienia, nietypowej biżuterii.
Jeśli nie masz sesji zdjęciowej, zbuduj zestaw generatywnie: wygeneruj portret bazowy, a następnie użyj go jako referencji do wygenerowania pozostałych kątów. Po dwóch–trzech iteracjach zestaw zaczyna się domykać.
Higiena materiałów referencyjnych
Referencje muszą być jednorodne technicznie: ta sama ogniskowa, podobne światło, brak agresywnej korekcji kolorystycznej, brak filtra upiększającego. Zdjęcie z rozmytym tłem i zdjęcie z tłem pełnym detali wprowadzają model w konsternację.
Surowe zasady, które oszczędzają godziny pracy:
- Jedna twarz na referencję. Kadry zbiorowe rozmywają tożsamość.
- Ostre oczy. Model czyta proporcje twarzy głównie z okolic oczu.
- Neutralny wyraz twarzy w co najmniej połowie ujęć. Szeroki uśmiech zmienia geometrię policzków i szczęki.
- Spójny strój na wszystkich referencjach bazowych. Warianty stroju dodawaj jako osobną warstwę, nie mieszaj ich w jednym zestawie.
Fuzja wielu obrazów: jak łączyć referencje w jeden spójny wizerunek
Fuzja obrazów (multi-image fusion) to technika, w której model otrzymuje kilka referencji jednocześnie i buduje z nich wspólną reprezentację tożsamości. Zamiast zgadywać, które zdjęcie jest ważniejsze, rozkłada wizerunek na warstwy i pobiera każdą z innego źródła.
Warstwy fuzji: tożsamość, strój, światło, styl
Najskuteczniejsze pipeline'y rozdzielają zadania na cztery niezależne warstwy:
- Tożsamość — zestaw portretów tej samej osoby. Ta warstwa ma najwyższy priorytet i nigdy nie jest nadpisywana przez pozostałe.
- Strój i akcesoria — osobne zdjęcia ubrań, butów, toreb. Pozwalają zmieniać kostium bez ruszania twarzy.
- Światło i atmosfera — kadr referencyjny scenografii lub oświetlenia, który narzuca temperaturę barw i kierunek cienia.
- Styl wizualny — klatka z filmu o pożądanej estetyce: ziarno, paleta, kontrast, sposób rozmycia tła.
Kiedy wszystkie cztery warstwy wrzucisz do jednego promptu bez rozdzielenia, model zacznie je mieszać. Twarz przejmie cechy modela z referencji stylistycznej, a strój zmieni kolor, żeby pasował do palety. Rozdzielenie warstw to nie wygoda — to warunek powtarzalności.
Wagi i priorytety
W narzędziach, które pozwalają ustawiać siłę wpływu poszczególnych referencji, stosuj prostą hierarchię: tożsamość 70–85%, strój 40–50%, światło 20–30%, styl 15–25%. Wartości są punktem startowym, nie dogmatem, ale zasada pozostaje stała: tożsamość zawsze wygrywa.
Jeśli model nie oferuje wag, osiągniesz podobny efekt, dzieląc pracę na etapy. Najpierw wygeneruj portret w docelowym świetle, a dopiero potem użyj go jako jedynej referencji tożsamości dla kolejnych ujęć. Każdy etap to jedna decyzja, którą można cofnąć.
Typowy workflow krok po kroku
- Zbierz i uporządkuj referencje w cztery foldery warstwowe.
- Wygeneruj ujęcie testowe w warunkach najbardziej ekstremalnych dla projektu — na przykład w silnym kontrapunktowym świetle.
- Oceń je arkuszem tożsamości. Popraw wagi, nie prompt.
- Zamroź zatwierdzoną kotwicę i zapisz ją jako plik bazowy projektu.
- Generuj ujęcia seryjnie, zmieniając wyłącznie warstwę akcji i kamery.
- Po każdej serii ośmiu–dziesięciu ujęć zrób przegląd miniatur i usuń odchylenia.
Kontrola stylu i doboru modeli: jak nie zgubić postaci między narzędziami
Współczesny ekosystem wideo AI nie jest monokulturą. Różne modele mają różne mocne strony: jedne lepiej trzymają anatomię dłoni, inne lepiej rozumieją ruch kamery, jeszcze inne świetnie renderują materiały i wodę. Dojrzały pipeline zakłada korzystanie z kilku narzędzi i — co ważniejsze — z jednej, wspólnej kotwicy tożsamości.
Kryteria wyboru modelu do zadania
Zadaj sobie cztery pytania przed każdą sceną:
- Czy w ujęciu dominuje twarz, czy otoczenie? Twarz wymaga modelu o wysokiej wierności portretu.
- Czy kamera wykonuje duży ruch? Jeśli tak, wybierz model o stabilnej geometrii, nawet kosztem stylu.
- Czy scena ma powtarzalne elementy (tło, rekwizyt)? Powtarzalność opłaca się renderować modelem o dobrej pamięci kompozycji.
- Jak długi jest klip? Krótsze ujęcia generują mniej dryftu, dłuższe wymagają dodatkowej kontroli klatki po klatce.
Hybrydowe pipeline'y
Najczystsze rezultaty daje podział pracy: jeden model odpowiada za portrety bohatera, drugi za sceny otoczenia, trzeci za ujęcia przejściowe bez twarzy. Kluczowe jest, aby ujęcia z twarzą nigdy nie przechodziły przez model, który nie widział kotwicy tożsamości.
Kolejną praktyką jest generowanie nadmiarowe. Zamiast jednego ujęcia twarzy rób trzy warianty z identycznym promptem i wybieraj najlepszy. Koszt czasu jest niższy niż koszt ponownego składania spójnej sekwencji po fakcie.
Praca seryjna i organizacja projektu: porządek, który ratuje terminy
Spójność postaci to w dużej mierze problem logistyczny. Projekty rozsypują się nie dlatego, że model zawiódł, ale dlatego, że po dwóch dniach nikt nie wie, która wersja kotwicy jest aktualna.
Struktura projektu i nazewnictwo
Ustal jeden schemat nazw plików i trzymaj się go bez wyjątków, na przykład: projekt_bohater_warstwa_ujecie_wersja. Wersjonuj każdą zmianę kotwicy, a nie tylko finalne ujęcia. Jeśli po tygodniu okaże się, że starsza kotwica dawała lepsze rezultaty, musisz móc do niej wrócić.
Trzymaj osobną, krótką kartę postaci: opis słowny, lista znaków szczególnych, paleta kolorów, lista zabronionych elementów (na przykład „nigdy nie dodawaj okularów”). Ta karta jest nieoceniona, gdy w projekt wchodzi druga osoba.
Kontrola jakości między ujęciami
Wprowadź przegląd po każdej serii. Trzy pytania do każdego ujęcia: czy to ta sama osoba, czy to ten sam kostium, czy to ta sama scena świetlna. Odpowiedź „prawie” oznacza „nie” i ujęcie idzie do regeneracji.
Warto też ustalić limit iteracji — zwykle trzy — po którym zmieniasz podejście, a nie prompt. Jeśli trzy próby nie przyniosły celu, problem leży w referencjach, nie w opisie.
Typowe błędy i sposoby ich naprawy
Błąd: zbyt długi prompt zamiast lepszych referencji. Opisywanie twarzy słowami nigdy nie dorówna obrazowi. Ogranicz opis do akcji, emocji i kamery.
Błąd: mieszanie strojów w jednej kotwicy. Powstaje postać, która zmienia ubranie w połowie kadru. Rozdziel stroje na osobne warianty.
Błąd: dodawanie nowych referencji w połowie projektu. Nagła zmiana zestawu zaburza wszystkie wcześniejsze ujęcia. Jeśli musisz dodać referencję, przetestuj ją na jednym ujęciu i porównaj z bazą.
Błąd: brak kontroli nad tłem. Postać jest spójna, ale tło zmienia epokę między scenami. Używaj referencji scenografii osobno dla każdej lokacji.
Błąd: poleganie na jednym ujęciu zamiast na sekwencji. Sekwencja ujawnia dryft, którego pojedyncze ujęcie nie pokaże. Testuj na trzech klatach, nie na jednej.
Błąd: ignorowanie rozdzielczości referencji. Zdjęcie 600 pikseli szerokości to za mało. Pracuj na materiałach o co najmniej 1500 pikseli na dłuższym boku.
Praktyczny scenariusz: trzydziestosekundowy spot z jedną bohaterką
Załóżmy, że masz nagrać trzydziestosekundowy spot z kobietą w płaszczu, który rozgrywa się w trzech lokacjach: biuro, ulica wieczorem, dach o zachodzie słońca.
Przygotowanie (dzień pierwszy). Budujesz kotwicę: osiem portretów bohaterki, trzy ujęcia płaszcza na neutralnym tle, dwa kadry referencyjne każdej lokacji, jedną klatkę stylistyczną. Definiujesz paletę: chłodne biuro, ciepła ulica, złoty dach.
Test tożsamości (dzień pierwszy). Generujesz trzy klatki próbne — twarz w świetle biurowym, twarz w świetle nocnym, twarz w świetle zachodzącego słońca. Oceniasz arkuszem tożsamości. Jeśli nocna klatka gubi kontrast oczu, obniżasz wagę warstwy światła i generujesz ponownie.
Produkcja (dni drugi i trzeci). Generujesz seryjnie po osiem–dziesięć ujęć na lokację, zmieniając tylko akcję i ruch kamery. Po każdej serii robisz przegląd miniatur.
Montaż (dzień czwarty). Ujęcia z oceną poniżej czterech regenerujesz. Dopiero potem przechodzisz do montażu, dźwięku i korekcji barwnej.
Zabezpieczenie. Ostatniego dnia generujesz dwa ujęcia awaryjne z twarzą bohaterki w każdej lokacji — na wypadek, gdyby podczas montażu okazało się, że brakuje przejścia.
Ten scenariusz wygląda na powolny, ale w praktyce skraca produkcję. Regenerowanie jednego ujęcia zajmuje minuty; naprawianie niespójnej sekwencji po montażu zajmuje dni.
FAQ: najczęstsze pytania o spójność postaci w wideo AI
Ile referencji wystarczy, żeby zacząć? Minimum to trzy ostre portrety z różnych kątów. Komfortowa praca zaczyna się przy sześciu–ośmiu ujęciach.
Czy zmiana modelu w trakcie projektu zawsze psuje spójność? Nie, jeśli nowy model otrzyma tę samą kotwicę i warstwy pomocnicze. Problem pojawia się, gdy zmieniasz model i jednocześnie przepisujesz referencje.
Dlaczego postać wygląda dobrze w kadrze bliskim, a źle w szerokim? W szerokim kadrze twarz zajmuje mało pikseli, więc model uzupełnia detale na podstawie kontekstu i stylu — nie tożsamości. Pomaga dodanie referencji pół sylwetki i nieco większa waga warstwy tożsamości.
Czy da się uniknąć dryftu całkowicie? Nie. Można go jednak utrzymać poniżej progu zauważalności, czyli w granicach, które widz akceptuje bez świadomej analizy.
Kiedy warto rozbić ujęcie na krótsze fragmenty? Zawsze, gdy w kadrze dominuje twarz i występuje duży ruch kamery. Trzy krótsze klipy dają stabilniejszy rezultat niż jeden długi.
Czy opis słowny postaci jest jeszcze potrzebny? Tak, ale jako uzupełnienie, nie fundament. Służy do wskazania emocji, tempa i relacji z otoczeniem.
Checklista gotowa do wdrożenia
Zanim wygenerujesz pierwszą scenę, sprawdź: czy masz cztery rozdzielone warstwy referencji, czy kotwica tożsamości ma co najmniej sześć kątów, czy wszystkie materiały mają podobne światło i rozdzielczość, czy karta postaci zawiera listę elementów zabronionych, czy ustaliłeś próg oceny jakości i limit iteracji.
Zanim oddasz projekt, sprawdź: czy przegląd miniatur objął całą sekwencję, czy nie ma ujęcia z oceną poniżej progu, czy kostium i fryzura są zgodne w każdej lokacji, czy paleta barwna nie przesuwa się między scenami.
Spójność postaci nie wymaga jednego magicznego narzędzia. Wymaga dyscypliny w przygotowaniu referencji, rozdzielenia warstw fuzji, konsekwentnej hierarchii wag i rutynowej kontroli jakości. Wszystko inne — modele, prompty, ustawienia — to warstwy wymienne, które działają dobrze dopiero wtedy, gdy fundament jest stabilny.
