
Dlaczego spójność postaci jest dziś wąskim gardłem generatywnego wideo
Generowanie wideo oparte na sztucznej inteligencji zrobiło w ostatnich latach ogromny skok jakościowy. Pojedyncze ujęcie potrafi dziś wyglądać jak fragment pełnoprawnej produkcji: realistyczne światło, płynny ruch kamery, wiarygodna materia skóry. Problem pojawia się w momencie, gdy ten sam bohater ma wystąpić w drugiej, piątej i dwudziestej scenie. Nagle okazuje się, że twarz się zmieniła, sylwetka zgubiła proporcje, a kolor włosów przesunął się o dwa tony.
To zjawisko nazywamy dryfem tożsamości. Nie wynika ono z błędu w jednym narzędziu, lecz z natury modeli generatywnych. Model nie przechowuje pamięci postaci. Każde wywołanie to nowa próbka z przestrzeni latentnej, która spełnia warunki promptu, ale niekoniecznie warunki ciągłości narracyjnej. Jeśli nie dostarczymy modelowi twardych punktów odniesienia, za każdym razem losowo rozstrzygnie on dziesiątki drobnych decyzji: kształt nosa, odległość między oczami, kąt żuchwy, strukturę ubrania.
Dlatego spójność postaci trzeba traktować nie jako jedną funkcję, którą się włącza, ale jako proces produkcyjny. Składa się on z trzech warstw: warstwy promptu i języka, warstwy referencji wizualnej oraz warstwy czasowej, czyli kontroli nad tym, co dzieje się między klatkami i między ujęciami. Kolejne sekcje pokazują, jak zbudować każdą z nich oraz jak połączyć je w powtarzalny workflow.
Fundament: biblioteka referencji i karta postaci
Zanim wygenerujesz pierwsze ujęcie, przygotuj materiał, do którego model będzie mógł wracać. To najczęściej pomijany krok, a odpowiada za większość sukcesu w długich projektach.
Karta postaci jako dokument roboczy
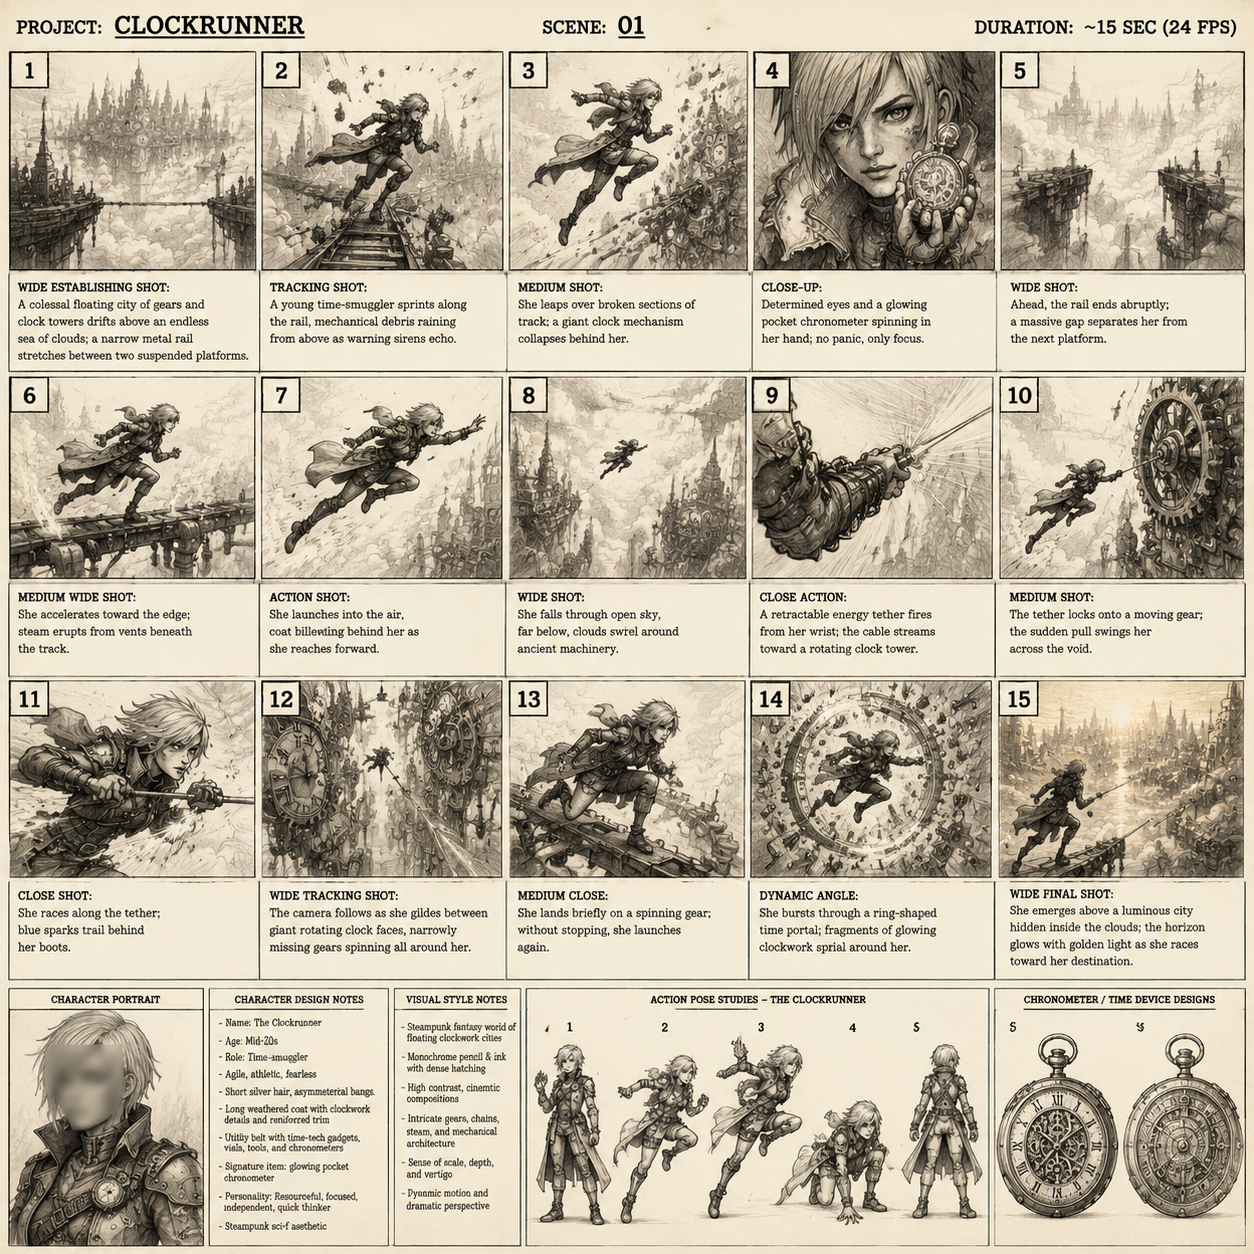
Karta postaci to jednostronicowy dokument zawierający wszystko, co wizualnie definiuje bohatera. Powinna zawierać:
- Deskryptor stały – akapit tekstu opisujący wygląd w sposób powtarzalny, bez słów nastrojowych i bez zbędnych przymiotników. Na przykład: kobieta lat 32, owalna twarz, ciemne proste włosy do ramion, brązowe oczy, wyraźne brwi, drobny nosek, lekko piegowate policzki, szczupła sylwetka, wzrost średni.
- Deskryptor ubrań – osobno dla każdej sceny, ale zawsze z tymi samymi określeniami kolorów i faktur.
- Zestaw referencji – od trzech do ośmiu zdjęć twarzy pod różnymi kątami, najlepiej przy neutralnym świetle.
- Paletę kolorów – dominujące barwy skóry, włosów, oczu i garderoby zapisane jako konkretne wartości, nie jako nazwy marketingowe.
- Listę cech zakazanych – elementy, które model lubi dodawać samodzielnie, a których nie chcemy. To często zarost, okulary, specyficzny typ fryzury albo nadmierna symetria twarzy.
Zdjęcia referencyjne: jakość ponad ilość
Trzy dobrze dobrane zdjęcia działają lepiej niż trzydzieści przypadkowych. Kluczowe zasady:
- Neutralne światło i brak filtrów. Ciepły filtr z Instagrama stanie się częścią tożsamości postaci i będzie wracał w każdym ujęciu.
- Różne kąty, ta sama ekspresja. Przód, trzy czwarte, profil. Jeśli na referencji postać się śmieje, model zacznie wstawiać śmiech bez powodu.
- Jednolite tło. Skomplikowane tło na referencji potrafi przeciekać do wygenerowanych scen.
- Ta sama rozdzielczość i proporcje. Mieszanie formatów zmusza pipeline do agresywnego przycinania, co zmienia geometrię twarzy.
Deskryptor tekstowy kontra referencja obrazowa
Dobrą praktyką jest prowadzenie obu równolegle. Tekst definiuje rzeczy, których obraz nie pokazuje – charakter, sposób poruszania się, emocjonalny rejestr. Obraz definiuje to, co trudno opisać słowami: dokładną geometrię twarzy. Jeśli tekst i obraz są sprzeczne, model prawie zawsze pójdzie za obrazem, dlatego nie warto opisywać w promptach rysów, których nie ma na referencjach.
Wybór narzędzia: kiedy tekst-na-wideo, kiedy obraz-na-wideo
Nie istnieje jeden model, który wygrywa we wszystkich zadaniach związanych ze spójnością. Znacznie skuteczniejsze jest dobranie klasy narzędzia do typu ujęcia.
Modele tekst-na-wideo
Nadają się do ujęć establishingowych, pejzaży, scen zbiorowych i wszystkiego, gdzie bohater jest daleko od kamery. Ich przewaga to swoboda kompozycji, wada – słaba kontrola nad tożsamością. Używaj ich do budowania świata, nie do zbliżeń twarzy.
Modele obraz-na-wideo
To podstawowe narzędzie pracy nad postacią. Startując od klatki referencyjnej, model zachowuje geometrię twarzy znacznie wierniej, ponieważ pierwsza klatka działa jak silne ograniczenie. W praktyce oznacza to, że dla każdego nowego ustawienia kamery warto najpierw wygenerować lub przygotować statyczny kadr z bohaterem, a dopiero potem animować go w trybie obraz-na-wideo.
Trening lekkich adapterów i modeli specjalistycznych
Gdy projekt ma więcej niż kilkanaście ujęć, warto rozważyć trening własnego adaptera na kilkunastu–kilkudziesięciu zdjęciach postaci. Taki dodatek do modelu bazowego uczy się konkretnej twarzy i potrafi ją odtwarzać w nowych pozach i oświetleniach. Warunki powodzenia:
- spójny zestaw zdjęć bez nakładania się na siebie kompozycji,
- brak zdjęć z zakrytą twarzą, mocnym makijażem czy filtrami,
- trening na umiarkowanej liczbie kroków, aby nie doszło do przetrenowania i kopiowania tła,
- test na pięciu losowych promptach przed uruchomieniem produkcji.
Jeśli nie chcesz trenować niczego, alternatywą są mechanizmy transferu tożsamości oparte na embeddingach obrazu, dostępne w popularnych pipeline'ach opartych na dyfuzji.
Wieloobrazowa fuzja: łączenie referencji w jeden spójny bohater
Kolejna technika polega na podaniu modelowi kilku obrazów jednocześnie: jednego opisującego tożsamość, drugiego styl, trzeciego kompozycję. Model łączy je w spójną całość. To rozwiązanie sprawdza się, gdy chcemy osadzić tę samą postać w różnych estetykach – na przykład w realistycznym dramacie i w stylizowanej animacji.
Praktyczne wskazówki:
- Jedna referencja tożsamości na raz. Dwie twarze w tym samym wejściu niemal zawsze prowadzą do mieszania cech.
- Waga referencji to najważniejszy suwak. Zbyt niska daje dryf, zbyt wysoka powoduje efekt naklejki: twarz wygląda poprawnie, ale nie pasuje do oświetlenia sceny.
- Oddziel styl od osoby. Jeśli referencja tożsamości ma wyraźny styl malarski, przeniesie go na cały kadr.
- Testuj na trzech klatkach. Zanim wygenerujesz dziesięciosekundowe ujęcie, sprawdź pierwszą klatkę w trzech wariantach wagi.
Dobra praktyka to zapisanie zwycięskich ustawień w pliku konfiguracyjnym projektu. Bez tego po tygodniu pracy nikt nie odtworzy dokładnie tego samego wyglądu.
Kontrola klatek kluczowych, przejścia i interpolacja czasowa
Spójność działa w dwóch wymiarach: między ujęciami oraz w obrębie jednego ujęcia. Drugi wymiar bywa trudniejszy, bo nawet jeśli pierwsza i ostatnia klatka są idealne, środek potrafi się rozjechać.
Pierwsza i ostatnia klatka jako kotwice
Podaj modelowi klatkę początkową i końcową, a następnie pozwól mu wygenerować ruch pomiędzy nimi. To technika znana jako keyframe control. Działa świetnie w scenach dialogowych i w ujęciach, gdzie postać musi dojść z punktu A do punktu B. Warunek: obie klatki muszą pochodzić z tego samego źródła tożsamości, inaczej model uśredni dwie różne twarze i powstanie ktoś trzeci.
Interpolacja i tempo
Interpolacja klatek poprawia płynność, ale nie naprawia tożsamości. Jeśli model zgubił twarz w połowie ujęcia, interpolacja tylko wygładzi błąd. Lepiej podzielić ujęcie na krótsze segmenty po dwie–trzy sekundy i wygenerować je osobno, a następnie połączyć w montażu. Krótsze segmenty są łatwiejsze do kontrolowania i tańsze w poprawkach.
Ruch kamery a stabilność twarzy
Dynamiczne przejazdy kamery, mocne zbliżenia i rotacje o 180 stopni to scenariusze, w których dryf rośnie najbardziej. Praktyczna zasada: im większa zmiana perspektywy, tym krótszy segment i tym mocniejsza referencja tożsamości. W ekstremalnych przypadkach lepiej zbudować ujęcie z kilku statycznych kadrów połączonych cięciami niż ryzykować jeden długi, płynny przejazd.
Storyboard i arkusz ciągłości
Spójność to nie tylko wygląd, ale również logika. Dwa dokumenty znacząco redukują liczbę poprawek.
Storyboard techniczny
Dla każdej sceny zapisz: numer ujęcia, czas trwania, typ planu, ruch kamery, opis akcji, użyty model oraz numer referencji tożsamości. Tabela może wydawać się biurokracją, ale przy dwudziestu ujęciach to jedyny sposób, by nie zgubić konfiguracji.
Arkusz ciągłości
Arkusz ciągłości pilnuje detali, które widz zauważa natychmiast: ubiór, biżuteria, fryzura, rany, przedmioty w dłoniach, pora dnia, kierunek światła. Jeśli bohater w scenie trzeciej ma rozpiętą kurtkę, w scenie czwartej powinien mieć ją rozpiętą – chyba że między scenami zmienił się czas fabuły.
Warto też prowadzić dziennik promptów. Zapisuj nie tylko finalny tekst, ale i odrzucone warianty oraz powód odrzucenia. Po kilku dniach te notatki są cenniejsze niż jakikolwiek poradnik.
Postprodukcja: ratowanie ujęć, które nie wyszły
Nawet najlepszy workflow produkuje ujęcia z drobnymi odchyleniami. Zamiast generować wszystko od nowa, warto naprawiać punktowo.
Korekcja koloru jako narzędzie spójności
Bardzo często problem nie dotyczy twarzy, lecz balansu bieli i kontrastu. Ujednolicenie temperatury barwowej i krzywych tonalnych między ujęciami potrafi sprawić, że ta sama postać wygląda spójnie, mimo że model odtworzył ją z drobnymi różnicami. Warto wykonać korekcję przed jakąkolwiek ingerencją w geometrię twarzy.
Narzędzia do podmiany i stabilizacji twarzy
Oprogramowanie do podmiany twarzy oraz modele do rekonstrukcji szczegółów twarzy pozwalają nadpisać tożsamość w ujęciu, które pod każdym innym względem jest idealne. Zasady ostrożności:
- podmieniaj twarz na etapie zbliżonym do finalnego, po ustabilizowaniu koloru,
- nie używaj tego narzędzia na ujęciach z ekstremalnymi profilami,
- zachowuj naturalne niedoskonałości – zbyt gładka skóra zdradza obróbkę,
- sprawdzaj kadr po kadrze w miejscach szybkiego ruchu.
Skalowanie i ostrość
Modele generatywne często produkują miękkie detale w okolicy oczu i ust. Delikatne wyostrzenie i redukcja szumu potrafią poprawić wrażenie ciągłości między ujęciami wygenerowanymi w różnych rozdzielczościach. Przesadna obróbka jest jednak gorsza niż jej brak, bo tworzy widoczne różnice między planami.
Najczęstsze błędy przy pracy nad spójną postacią
Zmiana promptu bez zapisu. Drobna edycja kilku słów potrafi przesunąć wygląd postaci. Jeśli coś działa, zamroź prompt i zmieniaj tylko to, co konieczne.
Mieszanie stylów w ramach jednej sceny. Realistyczne ujęcie obok stylizowanego kadru zawsze wygląda jak błąd montażowy, nawet gdy oba są ładne osobno.
Zbyt wysoka waga referencji. Twarz staje się płaska, oderwana od oświetlenia sceny i przypomina wycięty element.
Zbyt mało referencji przy dużej liczbie ujęć. Im dłuższy projekt, tym więcej kotwic tożsamości potrzebujesz, nawet jeśli brzmi to jak nadmiar.
Ignorowanie ruchu w klatce. Model potrafi utrzymać twarz w spoczynku, a zgubić ją w trakcie obrotu głowy. Testuj ruch, nie tylko statyczne kadry.
Praca bez wersjonowania plików. Nazwy typu final, final2, final-poprawiony to prosta droga do wysłania klientowi złej wersji.
Praktyczny workflow: od pomysłu do trzyminutowego filmu
Poniższy proces sprawdza się w projektach reklamowych, krótkich formach fabularnych i materiałach produktowych.
- Scenariusz i lista scen. Rozpisz fabułę na sceny, a sceny na ujęcia. Dla każdego ujęcia określ, czy potrzebujesz zbliżenia twarzy, planu średniego czy szerokiego.
- Karta postaci i referencje. Przygotuj dokument opisany wcześniej oraz zestaw zdjęć.
- Klatki bazowe. Wygeneruj statyczne kadry dla wszystkich ujęć z bohaterem. To najważniejszy etap – łatwiej poprawić zdjęcie niż wideo.
- Selekcja. Odrzuć wszystko, co nie przechodzi testu tożsamości w skali 1:1 przy pełnym zbliżeniu.
- Animacja segmentów. Generuj krótkie fragmenty po dwie–trzy sekundy w trybie obraz-na-wideo, z tą samą referencją tożsamości.
- Montaż zgrubny. Złóż całość bez efektów, aby sprawdzić rytm i ciągłość.
- Korekcja koloru i ujednolicenie. Wyrównaj ujęcia tonalnie, zanim tkniesz geometrię twarzy.
- Naprawy punktowe. Podmiana twarzy, stabilizacja, wyostrzenie – tylko tam, gdzie to konieczne.
- Dźwięk i udźwiękowienie ruchu. Spójność odbioru wzmacnia warstwa dźwiękowa: kroki, oddech, tło. Ucho wybacza mniej niż oko.
- Archiwizacja. Zapisz prompty, referencje, ustawienia wag i numery ujęć. Kolejny odcinek lub wersja kampanii powstanie trzy razy szybciej.
To, co odróżnia amatorskie próby od profesjonalnej produkcji, to nie jakość pojedynczego ujęcia, lecz powtarzalność. Dobry workflow pozwala wygenerować dwudzieste ujęcie tak samo wiarygodnie jak pierwsze, a gdy coś się rozjedzie – zlokalizować przyczynę w kilka minut.
FAQ: pytania, które pojawiają się najczęściej
Ile zdjęć referencyjnych wystarczy? W większości przypadków od trzech do ośmiu. Liczy się różnorodność kątów i jednolitość oświetlenia, nie liczba plików.
Czy seed wystarczy do zachowania tożsamości? Nie. Seed powtarza ziarno szumu, ale nie definiuje twarzy. To narzędzie pomocnicze, nie zamiennik referencji.
Co robić, gdy postać zmienia się w połowie ujęcia? Podziel ujęcie na krótsze segmenty, wygeneruj je osobno i połącz cięciem. Próba uratowania dwunastosekundowego przejazdu zwykle kosztuje więcej czasu niż ponowne złożenie sceny.
Czy warto trenować własny model dla jednej postaci? Tak, jeśli w projekcie jest więcej niż piętnaście ujęć z tą postacią albo jeśli planujesz serię odcinków. Przy jednorazowym klipie wystarczy transfer tożsamości oparty na referencjach.
Jak testować spójność przed renderem całości? Zrób tak zwany test trzech klatek: przód, trzy czwarte i profil w tym samym oświetleniu co scena docelowa. Jeśli na tym etapie twarz się rozjeżdża, dalsza praca nie ma sensu.
Czy spójność da się utrzymać między różnymi stylami wizualnymi? Częściowo. Tożsamość można przenieść, ale cechy stylu zawsze się przeciekają. Najbezpieczniejsze podejście to jeden spójny język wizualny dla całego projektu i osobne wersje tylko dla wyraźnie wyodrębnionych segmentów, na przykład retrospekcji.
Jak długo powinno trwać pojedyncze ujęcie z postacią? Najczęściej dwie do czterech sekund. Dłuższe ujęcia są ryzykowne i zwykle i tak montuje się je z krótszych fragmentów.
Czy warto inwestować w arkusz ciągłości przy małym projekcie? Przy trzech ujęciach nie. Przy dziesięciu oszczędza kilka godzin, a przy dwudziestu ratuje projekt przed chaosem wersji.
Podsumowanie: spójność jako proces, nie funkcja
Utrzymanie tej samej postaci w długim materiale wideo AI nie jest kwestią znalezienia magicznego narzędzia. To konsekwencja procesu: dobrze opisanej postaci, starannie dobranych referencji, świadomego wyboru trybu generowania, kontroli klatek kluczowych i cierpliwej postprodukcji. Każdy z tych elementów jest prosty osobno. Ich połączenie w powtarzalny workflow to różnica między zbiorem ładnych klipów a filmem, w którym widz naprawdę wierzy, że przez cały czas patrzy na tę samą osobę.
Najlepszym momentem na wdrożenie tego procesu jest początek projektu. Im wcześniej zamrozisz kartę postaci, tym mniej pracy będziesz musiał powtórzyć później – a w generatywnej produkcji wideo to właśnie powtórki, a nie samo generowanie, pochłaniają najwięcej czasu i zasobów.
