
Dlaczego bohater „rozjeżdża się” między ujęciami
Generowanie wideo z opisu tekstowego osiągnęło poziom, na którym pojedyncze ujęcie potrafi wyglądać jak kadr z drogiej produkcji. Problem zaczyna się dopiero wtedy, gdy z kilku takich ujęć trzeba złożyć spójną scenę. Pierwszy kadr zachwyca: właściwa twarz, fryzura, sylwetka, styl ubioru. Drugi pokazuje kogoś podobnego, ale o innym kształcie nosa. Trzeci zmienia kolor oczu, czwarty — proporcje ciała i fakturę ubrań. Widz natychmiast wyczuwa, że coś jest nie tak, nawet jeśli nie potrafi nazwać przyczyny. Zaufanie do opowieści spada, a cała produkcja wygląda jak zbiór przypadkowych klipów, a nie jak film.
Źródło problemu jest techniczne. Modele dyfuzyjne generują obraz probabilistycznie — przy każdym wywołaniu próbkują z przestrzeni możliwych rozwiązań. Opis tekstowy zawiera zbyt mało informacji, aby jednoznacznie wskazać konkretną twarz. Nawet ziarno losowości nie rozwiązuje sprawy, bo przy zmianie kompozycji, oświetlenia czy ruchu kamery model interpretuje opis od nowa i „wymyśla” bohatera jeszcze raz, za każdym razem trochę inaczej.
Dochodzi do tego czynnik czasu. Wideo to sekwencja klatek, w której tożsamość musi pozostać stabilna nie tylko w obrębie jednego ujęcia, ale też pomiędzy ujęciami tej samej sceny oraz w scenach rozgrywających się w innych miejscach i przy innym świetle. Każda zmiana warunków to kolejna okazja do dryfu: inna faktura skóry, inny odcień włosów, inny rysunek twarzy. Im dłuższy materiał, tym mocniej błędy się kumulują.
Dlatego doświadczeni twórcy nie polegają już wyłącznie na precyzyjnych promptach. Przechodzą na pracę z referencjami wizualnymi i traktują je jak część pipeline'u produkcyjnego — tak samo ważną jak scenariusz, storyboard czy montaż. Kluczowym narzędziem staje się mechanizm, który w jednym przebiegu łączy informacje z wielu zdjęć i wprowadza je do procesu generowania. Ten mechanizm nazywamy potocznie fuzją wielu referencji.
Czym właściwie jest fuzja wielu referencji
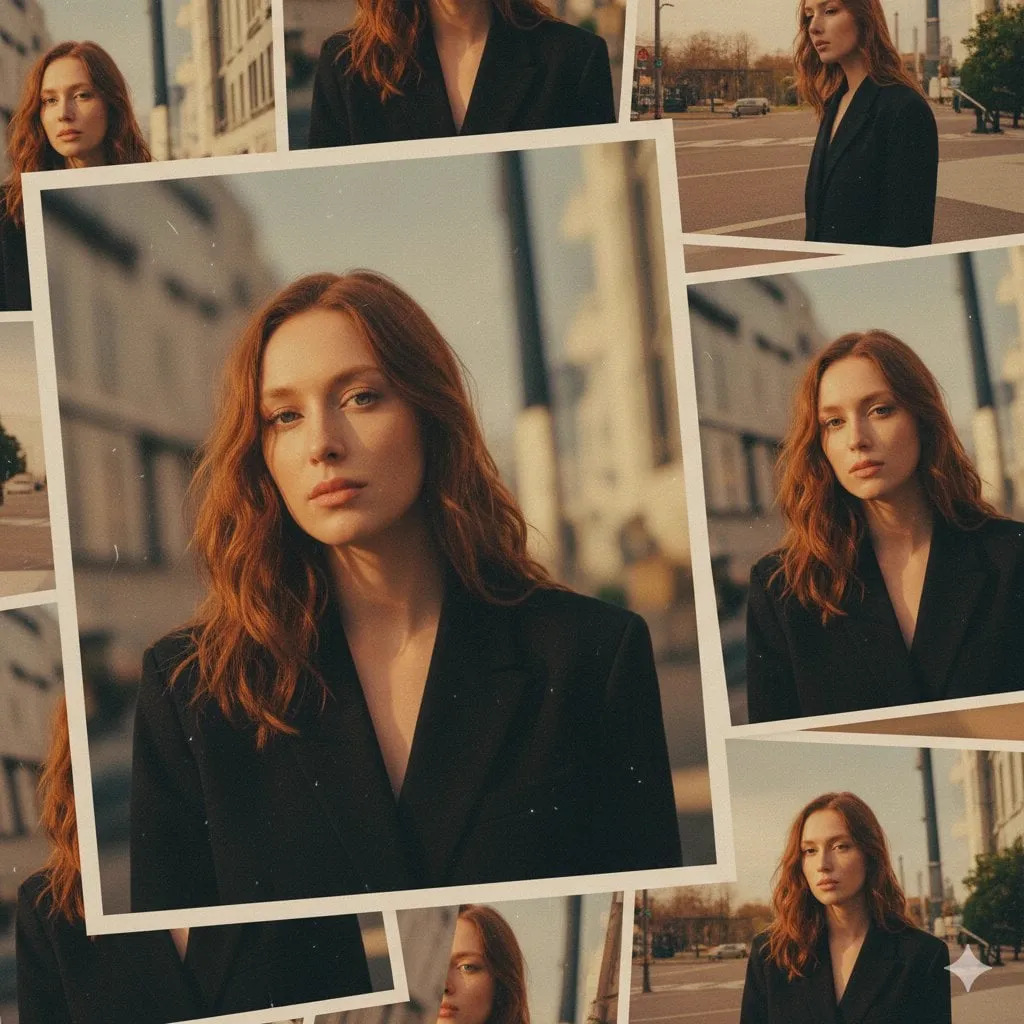
Fuzja wielu referencji (multi-image fusion) to technika, w której kilka zdjęć tej samej osoby — lub tego samego obiektu — jest najpierw zamienianych na reprezentację liczbową, a następnie łączonych w jedną, stabilną „sygnaturę tożsamości”. Ta sygnatura działa równolegle z opisem tekstowym i warunkuje wygląd postaci w każdym generowanym kadrze. W praktyce oznacza to, że model nie zgaduje już, jak wygląda bohater — dostaje gotową odpowiedź, a jego zadaniem jest tylko wpasowanie jej w scenę, oświetlenie i ruch.
Etap kodowania referencji
Każde zdjęcie przechodzi przez enkoder obrazu, który zamienia je w wektor cech. Ważne, aby enkoder rozdzielał to, co istotne dla tożsamości (kształt twarzy, rozstaw oczu, linia żuchwy, proporcje ciała), od tego, co jest przypadkowe (tło, ubiór, temperatura barwowa, kompresja pliku). Dobre systemy potrafią tę separację przeprowadzić świadomie: dystyngwują cechy strukturalne od cech stylistycznych i pozwalają użytkownikowi decydować, co ma zostać przeniesione.
Kolejnym krokiem jest agregacja. Poszczególne wektory nie są po prostu uśredniane — to prowadziłoby do „rozmytej” twarzy, która nie przypomina nikogo konkretnego. Zamiast tego stosuje się mechanizmy uwagi pomiędzy obrazami: model ocenia, które cechy powtarzają się konsekwentnie na wszystkich zdjęciach, i im nadaje wyższą wagę. Cechy obecne tylko na jednym kadrze (na przykład cień w połowie twarzy albo odblask na okularach) są tłumione.
Etap wstrzykiwania w proces generowania
Gotowa sygnatura jest wstrzykiwana do modelu generującego na kilka sposobów. Najczęściej spotykane rozwiązania to warunkowanie przez mechanizm uwagi krzyżowej, adaptery referencyjne montowane na istniejącym modelu bazowym oraz niewielkie dodatki trenowane na zestawie zdjęć konkretnej postaci. Różnią się one kosztem przygotowania, elastycznością i odpornością na zmianę stylu.
- Warunkowanie referencyjne — działa od razu, nie wymaga treningu, dobrze sprawdza się przy krótkich projektach i szybkich testach.
- Adapter tożsamości — lepsza kontrola, większa stabilność przy zmianie pozy i oświetlenia, wymaga jednak staranniejszego zestawu zdjęć.
- Dodatek trenowany na postaci — maksymalna wierność i powtarzalność, ale przygotowanie zajmuje czas i wymaga kilkunastu do kilkudziesięciu dobrych ujęć.
Trzy poziomy kontroli, które działają razem
Bardzo częstym błędem jest traktowanie referencji jako substytutu promptu. W rzeczywistości kontrola nad postacią rozkłada się na trzy warstwy, które muszą być spójne:
| Warstwa | Co kontroluje | Typowe błędy |
|---|---|---|
| Prompt tekstowy | scena, akcja, emocja, styl | sprzeczne opisy wyglądu, nadmiar przymiotników |
| Referencje wizualne | tożsamość, proporcje, ubiór | mieszanie zdjęć różnych osób, słabe światło |
| Ziarno / parametry | kompozycja, powtarzalność | zmiana ziarna przy każdej iteracji |
Jeżeli prompt opisuje „mężczyznę w średnim wieku z brodą”, a referencje pokazują osobę bez zarostu, model wejdzie w konflikt i wygeneruje hybrydę. Najbezpieczniej jest opisywać w promptcie wyłącznie to, co dzieje się w scenie, a wygląd zostawiać referencjom.
Anatomia dobrego zestawu referencyjnego
Jakość wyniku zależy od jakości danych wejściowych bardziej niż od samego modelu. Zestaw referencji powinien być mały, ale różnorodny w sposób kontrolowany.
Ile zdjęć i jakich
W praktyce sprawdza się od sześciu do dwudziestu zdjęć. Poniżej pięciu model nie ma wystarczających danych, aby odróżnić cechy stałe od przypadkowych. Powyżej trzydziestu zaczyna pojawiać się szum, a proces staje się wolniejszy bez wyraźnej korzyści.
Zestaw idealny zawiera:
- dwa lub trzy ujęcia frontalne przy równomiernym, miękkim świetle,
- dwa ujęcia w profilu trzecim (trzy czwarte), które pokazują głębokość twarzy,
- jedno ujęcie w pełnym profilu,
- jedno lub dwa ujęcia z lekkim odchyleniem głowy w górę i w dół,
- jedno ujęcie całej sylwetki lub przynajmniej do pasa, aby model poznał proporcje ciała,
- opcjonalnie ujęcie z naturalnym uśmiechem, jeśli postać ma się uśmiechać w materiale.
Twarze powinny mieć neutralny lub łagodny wyraz. Skrajne emocje (szeroki śmiech, gniew, zdziwienie) deformują rysy i wprowadzają model w błąd, jeśli nie są zgodne z tym, co postać ma robić w ujęciu.
Czego unikać w materiale wejściowym
Najczęstsze źródła problemów to:
- agresywny retusz — wygładzona skóra pozbawia model informacji o fakturze, co potem owocuje „plastikową” twarzą w wideo,
- filtry kolorystyczne — ciepłe i zimne ziarna nakładają na siebie cechy oświetlenia, które model zaczyna traktować jako część tożsamości,
- mocne cienie i światło kontrowe — połowa twarzy w cieniu to dla enkodera brak danych,
- zdjęcia grupowe i tła z wieloma osobami — model może przypadkowo przypisać cechy osoby z tła,
- silna kompresja — artefakty blokowe są interpretowane jako struktura skóry,
- różne osoby na zdjęciach — nawet jeśli są podobne, wynik będzie przeciętniactwem.
Nazewnictwo i porządek w bibliotece
W projektach dłuższych niż jeden klip biblioteka referencji szybko wymyka się spod kontroli. Warto od początku ustalić konwencję: nazwa postaci, wersja, typ ujęcia. Przykładowo anna_v02_front_neutral, anna_v02_profile_left, anna_v02_full_body. Dzięki temu za pół roku, przy dokrętce, nie trzeba zgadywać, który plik był źródłem udanego ujęcia.
Workflow produkcyjny: od karty postaci do gotowej sceny
Poniższy przepływ sprawdza się zarówno w reklamie, jak i w krótkiej formie narracyjnej czy materiale szkoleniowym.
Krok 1 — karta postaci
Zanim powstanie jedno ujęcie, warto przygotować jednostronicowy dokument opisujący bohatera: wiek, sylwetka, fryzura, zarost, typ ubioru, akcesoria, paleta kolorów, sposób poruszania się. To dokument dla zespołu i punkt odniesienia przy ocenie wyników. Bez niego każda osoba w projekcie ma inną wizję postaci, a iteracje krążą bez celu.
Krok 2 — klatki kluczowe w trybie statycznym
Generowanie wideo jest kosztowne czasowo, dlatego najpierw przygotowuje się statyczne klatki kluczowe. Sprawdza się na nich tożsamość, proporcje i światło. Dopiero gdy klatka wygląda dokładnie tak, jak powinna, uruchamia się animację. Ta kolejność oszczędza godziny pracy i zapobiega sytuacji, w której piękny ruch zostaje odrzucony, bo twarz nie zgadza się z referencjami.
Krok 3 — animacja z zachowaniem tożsamości
Animatorem sterujemy opisem ruchu: „powolny obrót głowy w prawo”, „krok do przodu”, „uniesienie dłoni do twarzy”. Im mniej zmian w jednym ujęciu, tym stabilniejsza tożsamość. Trzysekundowy klip z jedną akcją jest znacznie łatwiejszy do utrzymania w ryzach niż dziesięciosekundowy klip z trzema zwrotami akcji.
Krok 4 — ocena i iteracja
Ocenę warto prowadzić w stałej kolejności: tożsamość, proporcje, ruch, światło, tło. Poprawianie światła, gdy tożsamość wciąż się nie zgadza, jest stratą czasu. Jeżeli dryf jest niewielki, pomaga korekta w jednym wymiarze naraz — zmiana ziarna nie pomoże, jeśli problem leży w zestawie referencji.
Krok 5 — ujednolicenie kolorystyczne
Nawet przy idealnej tożsamości poszczególne ujęcia mogą różnić się temperaturą barwową i kontrastem. Delikatna korekcja w programie montażowym — wyrównanie balansu bieli i krzywych — potrafi sprawić, że materiał zacznie wyglądać jak nakręcony w jednym dniu, a nie w pięciu osobnych sesjach.
Ruch, pozy i spójność czasowa
Tożsamość w pojedynczym kadrze to dopiero połowa sukcesu. Druga połowa to stabilność w czasie.
Dryf tożsamości w długich ujęciach
Im dłuższy klip, tym większe prawdopodobieństwo, że model zacznie „zapominać” referencje i płynnie przejść w inną twarz. Objawia się to subtelnie: linia żuchwy się zaokrągla, oczy się rozsuwają, nos wydłuża. Widz nie zauważy tego w pojedynczej klatce, ale zobaczy w ruchu. Rozwiązaniem jest dzielenie scen na krótkie segmenty i montowanie ich w całość, a nie generowanie jednego długiego ujęcia.
Sterowanie ruchem bez utraty twarzy
Najstabilniejsze rezultaty daje przenoszenie ruchu z materiału nagranego — na przykład z telefonu. Model przejmuje wtedy trajektorię głowy i ciała, a tożsamość czerpie z referencji. W ten sposób uzyskuje się naturalną mimikę, której nie da się wiarygodnie opisać słowami.
Mimika i usta
Okolice ust i oczu są najbardziej wrażliwe. Jeśli w materiale pojawia się mowa, warto zaplanować ujęcia tak, aby twarz nie była odwrócona ani mocno przekrzywiona. Ujęcia z mówiącą postacią najlepiej generować frontalnie i przy równym świetle, a następnie przeplatać je ujęciami z innych kątów, w których usta nie muszą się poruszać.
Typowe błędy i szybkie poprawki
Poniższa lista to skrócona diagnostyka najczęstszych problemów.
Postać zmienia się między ujęciami mimo tych samych referencji. Przyczyna zwykle leży w promptcie — zawiera opis wyglądu, który konkuruje z referencjami. Usuń z opisu cechy fizyczne i opisz tylko akcję oraz otoczenie.
Twarz wygląda „plastikowo”. Zestaw referencji został nadmiernie wyretuszowany. Dodaj zdjęcia z widoczną fakturą skóry i naturalnym światłem.
Model kopiuje ubiór z referencji mimo innego opisu. Referencje niosą zbyt silny sygnał stylistyczny. Wymieszaj zdjęcia w różnych strojach albo skorzystaj z trybu, który rozdziela tożsamość od ubioru.
Kolor skóry zmienia się z ujęcia na ujęcie. Wynik mieszania referencji w różnych temperaturach barwowych. Ujednolicaj zdjęcia wejściowe przed ich użyciem.
Postać wygląda starzej lub młodziej niż powinna. Efekt nadreprezentacji jednego typu zdjęć, na przykład wyłącznie frontalnych przy ostrym świetle. Zbalansuj zestaw.
Ujęcie z ruchu kamery psuje twarz. Ogranicz ruch kamery do minimum albo przenieś go na etap montażu, korzystając z cyfrowego zbliżenia i przesunięcia kadru.
Narzędzia i ich role w pipeline
Nie istnieje jedno narzędzie, które rozwiąże wszystkie problemy. Trwałe rezultaty daje podział ról.
- Modele generatywne ogólnego przeznaczenia (Runway, Sora, Kling, Luma, Pika) — produkcja ujęć, animacja, eksperymenty ze stylem.
- Modele obrazu (Flux, Midjourney, Stable Diffusion) — klatki kluczowe, koncepty, tła.
- Narzędzia z warunkowaniem referencyjnym (adaptery tożsamości, przepływy oparte na grafach węzłów) — precyzyjna kontrola nad twarzą i ubiorem.
- Programy montażowe i korekcyjne (DaVinci Resolve, Premiere) — ujednolicenie kolorystyki, rytm, przejścia.
- Narzędzia do skali i wyostrzania — przygotowanie finalnego materiału do emisji.
Zasada praktyczna: im więcej kontroli wymaga projekt, tym bardziej warto zestawić model ogólny z warunkowaniem referencyjnym i ręczną korekcją, zamiast liczyć na jedno kliknięcie.
Spójność w projektach długoterminowych
Postacie wielokrotnego użytku
Kampania reklamowa, serial krótkich odcinków czy kurs online mają jedną cechę wspólną: ta sama postać wraca wielokrotnie, w różnych wnętrzach, porach dnia i nastrojach. W takich projektach biblioteka referencji staje się zasobem firmowym. Warto przechowywać ją razem z kartą postaci i notatkami o tym, które ustawienia przyniosły najlepsze rezultaty.
Wersjonowanie
Postać ewoluuje: zmienia się fryzura, ubiór, zarost. Bez wersjonowania zespół miesza stare i nowe zdjęcia, a wyniki stają się nieprzewidywalne. Prosty system numeracji rozwiązuje problem definitywnie.
Przekazywanie pracy
Gdy projekt przechodzi z rąk do rąk, najważniejsza jest powtarzalność. Dobrą praktyką jest zapisywanie nie tylko referencji, ale również ustawień, promptów i ziaren dla ujęć, które zostały zaakceptowane. Dzięki temu kolejna osoba może odtworzyć sukces zamiast zaczynać od zera.
Checklista przed uruchomieniem generowania
- Czy karta postaci jest gotowa i zaakceptowana przez zespół?
- Czy zestaw referencji liczy od sześciu do dwudziestu zdjęć?
- Czy w zestawie są ujęcia frontalne, trzecie profile i pełna sylwetka?
- Czy zdjęcia mają spójną temperaturę barwową i brak agresywnego retuszu?
- Czy na zdjęciach nie ma innych osób ani rozpraszających elementów?
- Czy prompt opisuje wyłącznie akcję, scenerię i emocję?
- Czy klatki kluczowe zostały zatwierdzone przed animacją?
- Czy każdy klip trzyma się zasady jednej akcji na ujęcie?
- Czy przewidziano etap wyrównania kolorystycznego w montażu?
- Czy zapisano ustawienia udanych prób do ponownego użycia?
Najczęściej zadawane pytania
Czy wystarczy jedno zdjęcie referencyjne? Technicznie tak, ale wynik będzie niestabilny przy zmianie kąta i oświetlenia. Jedno zdjęcie nie pozwala modelowi odróżnić cech stałych od przypadkowych.
Dlaczego postać wygląda dobrze w statycznej klatce, a źle w ruchu? Statyczna klatka daje modelowi więcej czasu na dopasowanie referencji. W ruchu kolejne klatki generowane są w warunkach rosnącej niepewności, co sprzyja dryfowi. Pomaga dzielenie ujęcia na krótsze segmenty.
Czy trenowanie własnego dodatku do postaci ma sens? Tak, jeśli postać będzie powracać w wielu projektach. Przy jednorazowym klipie to nadmiar pracy — lepiej zainwestować w lepszy zestaw referencji.
Jak poradzić sobie ze zmianą ubioru? Najlepiej przygotować osobne zestawy referencji dla każdego stroju albo korzystać z trybów rozdzielających tożsamość od odzieży. Mieszanie ubrań w jednym zestawie utrudnia modelowi wyodrębnienie twarzy.
Czy jakość referencji ma większe znaczenie niż rozdzielczość wyjściowa? Zdecydowanie. Nawet wysokiej rozdzielczości wideo będzie sprawiać wrażenie nieprofesjonalnego, jeśli twarz zmienia się między ujęciami. Ostrość można poprawić na etapie montażu, tożsamości nie.
Co zrobić, gdy postać ma wyglądać inaczej w każdej scenie? To sytuacja, w której referencje warto podzielić na zestawy kontekstowe — na przykład „postać w pracy” i „postać w domu”. Każdy zestaw zachowuje twarz, ale pozwala różnicować styl.
Podsumowanie
Spójność postaci przestała być trikiem, a stała się elementem rzemiosła. Największą różnicę robi nie pojedyncze narzędzie, lecz dyscyplina: uporządkowany zestaw referencji, jasna karta postaci, krótkie ujęcia, konsekwentna ocena i etap wyrównania kolorystycznego na końcu. Fuzja wielu referencji dostarcza modelowi informacji, której nie da się przekazać słowami, a reszta to już kwestia warsztatu — planowania, iteracji i cierpliwości. Zespół, który opanuje ten przepływ, przestaje walczyć z narzędziami i zaczyna opowiadać historie.
