
Warum Text-zu-Video kein Modellproblem, sondern ein Workflowproblem ist
Wer zum ersten Mal mit generativem Video arbeitet, erwartet meist Folgendes: Szene beschreiben, Knopf drücken, fertiger Clip. Das funktioniert erstaunlich gut – für drei bis acht Sekunden. Sobald daraus ein zusammenhängendes Video mit Dramaturgie, wiederkehrenden Figuren und passendem Ton werden soll, bricht dieser Ansatz auseinander.
Die entscheidende Erkenntnis lautet: Ein einzelnes Modell liefert selten einen fertigen Film. Es liefert einen Baustein. Die eigentliche Arbeit besteht darin, mehrere Bausteine so zu orchestrieren, dass am Ende ein stimmiges Ganzes entsteht. Wer das versteht, hört auf, nach dem einen perfekten Werkzeug zu suchen, und beginnt stattdessen, eine Pipeline aufzubauen.
Dieser Leitfaden beschreibt genau diese Pipeline – unabhängig davon, welche Plattform Sie am Ende nutzen. Wir schauen uns die fünf Produktionsstufen an, die Modelltypen und ihre Stärken, den Aufbau belastbarer Videoprompts, Techniken für Konsistenz über mehrere Szenen, ein vollständiges Praxisbeispiel, typische Fehler und die Kriterien, nach denen Sie neue Werkzeuge testen sollten.
Die fünf Bausteine einer belastbaren KI-Video-Pipeline
Wer planlos Clips generiert, produziert Ausschuss. Wer die folgenden fünf Stufen nacheinander abarbeitet, produziert Material, das sich schneiden lässt.
Stufe 1: Konzept und Skript
Bevor irgendein Modell läuft, steht das Skript. Nicht als Drehbuch im klassischen Sinn, sondern als Abfolge von Einstellungen mit klarer Funktion. Eine brauchbare Vorlage pro Einstellung:
- Dauer: realistisch 4–8 Sekunden pro Generierung
- Funktion: Was leistet diese Einstellung für die Geschichte?
- Bildinhalt: Wer oder was ist zu sehen?
- Kamera: statisch, Fahrt, Schwenk, Nahaufnahme?
- Licht: Tageslicht, Kunstlicht, Gegenlicht, Neon?
- Ton: Atmo, Dialog, Musik, Stille?
Wer diese sechs Zeilen pro Einstellung ausfüllt, erkennt früh, ob eine Idee überhaupt trägt. Die meisten gescheiterten KI-Videos scheitern nicht an der Technik, sondern daran, dass nie klar war, was die einzelnen Einstellungen erzählen sollen.
Stufe 2: Visuelle Referenz und Stilbibel
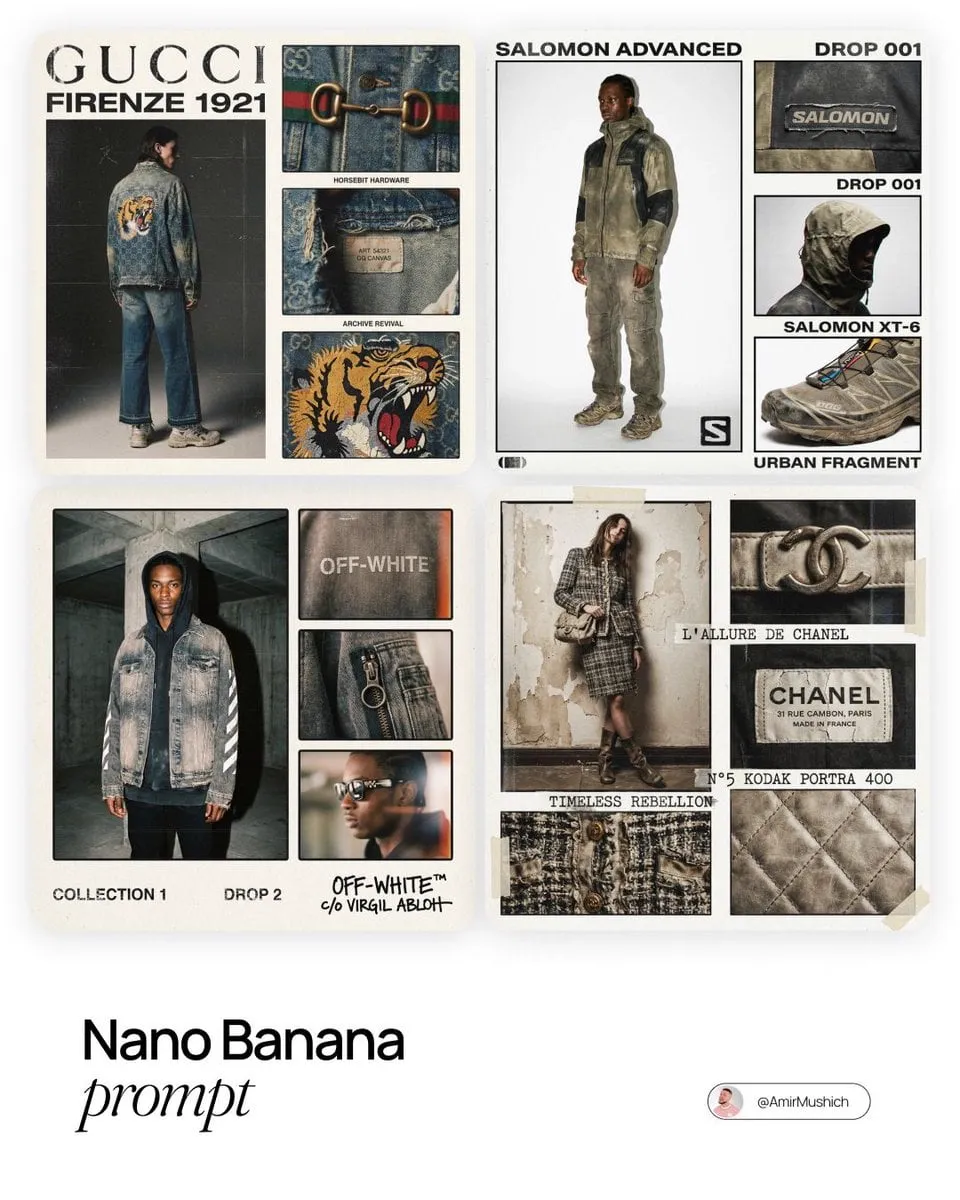
Generative Systeme sind sehr gut darin, Stimmungen zu treffen – und sehr schlecht darin, sie über mehrere Generierungen hinweg stabil zu halten. Deshalb braucht jedes Projekt eine Stilbibel: eine kleine Sammlung von Referenzbildern und festen Beschreibungen.
Sinnvoller Inhalt einer Stilbibel:
- zwei bis vier Referenzbilder für den Look (Farbton, Kontrast, Textur)
- eine feste Farbpalette, in Worten beschrieben
- eine Beschreibung der Lichtstimmung
- eine Beschreibung der Figuren (Kleidung, Frisur, Alter, Haltung)
- eine Liste verbotener Elemente (Logos, Text im Bild, bestimmte Stile)
Diese Stilbibel wird zum Anker. Jeder Prompt, den Sie später schreiben, greift auf sie zurück – nicht, indem Sie ständig neue Ideen einbringen, sondern indem Sie dieselben Formulierungen wiederholen. Wiederholung ist in der KI-Videoproduktion kein Stilfehler, sondern ein technisches Werkzeug.
Stufe 3: Shot-Generierung
Hier passiert die eigentliche Produktion. Es gibt zwei Wege: Text-zu-Video direkt aus der Beschreibung oder Bild-zu-Video, bei dem Sie zuerst ein Standbild erzeugen und dieses anschließend animieren lassen.
Bild-zu-Video ist für die meisten Projekte der zuverlässigere Weg. Der Grund ist einfach: Ein Standbild lässt sich kontrollieren, bewerten und austauschen. Sie sehen sofort, ob Figur, Kleidung und Licht stimmen. Erst wenn das Bild sitzt, geben Sie es an ein Videomodell weiter, das Bewegung hinzufügt. Text-zu-Video eignet sich vor allem für Establishing Shots, abstrakte Übergänge, Hintergründe und alles, wo keine Figur konsistent bleiben muss.
Stufe 4: Bewegung, Kamera und Übergänge
Bewegung ist die Währung, in der KI-Videoqualität gemessen wird – und gleichzeitig die größte Fehlerquelle. Zu viel Bewegung führt zu verschwimmenden Gesichtern, zerfallenden Händen und wackeligen Proportionen. Zu wenig Bewegung wirkt statisch und leblos.
Faustregel: Eine Bewegung pro Einstellung. Entweder die Figur bewegt sich oder die Kamera. Beides gleichzeitig, kombiniert mit einer komplexen Handlung, überfordert die meisten Systeme sichtbar.
Stufe 5: Ton, Schnitt, Farbanpassung
Der Ton ist in KI-Workflows der am häufigsten unterschätzte Schritt. Ein mittelmäßiger Clip mit gutem Sounddesign wirkt professioneller als ein perfekter Clip mit stummem Bild. Planen Sie deshalb von Anfang an:
- Hintergrundatmosphäre pro Szene
- Musikbett mit klaren Schnittpunkten
- Voice-over oder Dialog, separat erzeugt
- Soundeffekte, die Bewegungen verankern
Der Schnitt erfolgt anschließend in einer klassischen Videosoftware. KI-generierte Clips kommen als Rohmaterial – nicht als fertiger Film.
Modelltypen und ihre Stärken: ein neutraler Überblick
Der Markt an Videomodellen ist unübersichtlich, aber nicht chaotisch. Es gibt erkennbare Kategorien, und jede hat einen sinnvollen Einsatzbereich.
Photorealistische Kurzclips und cinematische Looks
Diese Modelle liefern natürliche Hauttöne, glaubwürdige Materialien und eine filmische Tiefenschärfe. Sie eignen sich für Porträts, Produktaufnahmen und realistische Szenen. Beispiele für Werkzeuge dieser Kategorie sind Runway Gen-Reihe, Sora, Veo, Kling und Luma Dream Machine. Wer einen dokumentarischen Look braucht, findet hier die geringste Nachbearbeitungszeit.
Modelle mit starker Bewegungsdynamik
Einige Systeme, häufig aus dem asiatischen Raum, sind besonders gut darin, schnelle Bewegungen, Tanz, Action und Kampfszenen zu erzeugen, ohne dass die Anatomie sofort zerfällt. Kling, Hailuo und Vidu gehören in diese Gruppe. Für Trailermaterial mit hohem Tempo sind sie oft die erste Wahl.
Referenz- und Konsistenzmodelle
Hier steht nicht die Einzelszene im Mittelpunkt, sondern die Wiedererkennbarkeit. Sie geben dem Modell ein Referenzbild oder mehrere Bilder mit und erhalten Variationen derselben Figur oder desselben Raums. Das ist die Grundlage für jede erzählerische Sequenz mit wiederkehrenden Charakteren.
Motion- und Kamera-Spezialisten
Manche Werkzeuge sind darauf optimiert, aus einem einzigen Bild kontrollierte Kamerabewegungen zu erzeugen: langsamer Zoom, Orbit, Dolly, Parallaxe. Für Produktvideos und Architekturvisualisierungen ist das oft wertvoller als jede fotorealistische Figur.
Bildmodelle als Zulieferer
Der wichtigste Baustein der ganzen Kette ist häufig ein Bildmodell: Midjourney, Flux, Stable Diffusion oder vergleichbare Systeme. Sie liefern die Standbilder, die anschließend animiert werden. Wer hier sauber arbeitet, spart in der Videostufe ein Vielfaches an Zeit und Rechenleistung.
Prompting für Video: Struktur statt Zauberwörter
Ein Videoprompt ist keine Beschwörungsformel. Er ist eine Spezifikation. Je präziser die Spezifikation, desto geringer die Streuung der Ergebnisse.
Das Grundgerüst
Sechs Elemente, in dieser Reihenfolge:
- Subjekt – wer oder was, mit den wichtigsten Merkmalen
- Handlung – eine einzige, klar beschriebene Bewegung
- Umgebung – Ort, Wetter, Tageszeit, Hintergrundelemente
- Kamera – Brennweite, Winkel, Bewegung
- Licht – Qualität, Richtung, Farbe
- Stil – Filmreferenz, Grading, Textur
Ein Beispiel:
Nahaufnahme einer Frau Mitte dreißig mit dunklem, zurückgebundenem Haar, sie hebt langsam eine Tasse und schaut nach links aus dem Fenster; kleines Café am Morgen, Regentropfen auf der Scheibe; Kamera statisch, 50 mm, leichte Tiefenschärfe; weiches Seitenlicht von links, kühles Tageslicht; ruhiger, dokumentarischer Look, dezente Körnung.
Dieser Prompt ist lang, aber er ist nicht überladen. Jeder Satz enthält genau eine Information.
Negative Anweisungen sparsam einsetzen
Negative Prompts sind nützlich, aber sie können das Ergebnis auch verflachen. Zwei oder drei gezielte Ausschlüsse reichen meist: keine Texteinblendungen, keine verzerrten Hände, keine schnelle Bewegung. Lange Negativlisten führen dazu, dass das Modell vorsichtig wird und sterile Bilder produziert.
Iteration in kleinen Schritten
Ändern Sie pro Durchlauf immer nur eine Variable. Wer gleichzeitig Prompt, Stil, Seitenverhältnis und Sampler ändert, kann nicht erkennen, was gewirkt hat. Führen Sie ein einfaches Protokoll: Prompt-Version, Einstellung, Ergebnis, Bewertung. Nach zwanzig Generierungen haben Sie ein persönliches Handbuch für Ihr Projekt.
Konsistenz über mehrere Szenen herstellen
Konsistenz ist die schwierigste technische Anforderung in der KI-Videoproduktion. Sie entsteht nicht durch ein einzelnes Werkzeug, sondern durch Disziplin.
Charakterkonsistenz über Referenzbilder
Erzeugen Sie zuerst ein sauberes Charakterblatt: frontal, im Profil, in zwei verschiedenen Lichtsituationen. Diese Bilder dienen als Referenz für alle weiteren Generierungen. Achten Sie darauf, dass die Referenz selbst keine starke Perspektive enthält – ein frontales, neutrales Bild funktioniert am besten.
Szenenkontinuität über feste Parameter
Halten Sie über ein ganzes Projekt hinweg konstant:
- Brennweite und Objektivcharakter
- Grundfarbe und Kontrastumfang
- Lichtrichtung, sofern die Szene im selben Raum spielt
- Körnung und Schärfentiefe
Wenn Sie diese Parameter in jeden Prompt schreiben, entsteht ein visuelles Gedächtnis, an dem sich das Modell orientiert.
Der Storyboard-Ansatz
Zeichnen oder generieren Sie zuerst ein Storyboard aus acht bis zwölf Standbildern. Erst wenn dieses Board als Abfolge überzeugt, beginnen Sie mit der Animation. Dieser Umweg wirkt langsam, spart aber in der Praxis 50 bis 70 Prozent der Generierungszeit, weil fehlerhafte Szenen auf der Bildebene und nicht auf der Videoebene korrigiert werden.
Praxisbeispiel: Ein 60-Sekunden-Trailer in sieben Arbeitsschritten
Angenommen, Sie produzieren einen Kurztrailer für ein fiktives Bergsteiger-Drama. Kein Budget für Dreharbeiten, aber eine klare Idee.
Schritt 1 – Skript: Zwölf Einstellungen, jede mit einer Funktion. Vier Establishing Shots (Landschaft), vier Charaktereinstellungen, zwei Detailaufnahmen (Hände, Seil), zwei dramatische Momente.
Schritt 2 – Stilbibel: Referenzen aus Naturdokumentationen, entsättigte Blautöne, hartes Seitenlicht, 35-mm-Körnung, keine gesättigten Farben.
Schritt 3 – Standbilder: Alle zwölf Einstellungen werden als Bilder erzeugt, zunächst ohne Animation. Zwei Einstellungen funktionieren nicht und werden zweimal neu generiert.
Schritt 4 – Auswahl: Nur die zehn überzeugenden Bilder gehen weiter. Die anderen zwei werden durch Varianten ersetzt, die bereits im Bild den Charakter zeigen.
Schritt 5 – Animation: Jedes Bild erhält eine Bewegung – Schneetreiben, langsamer Zoom, Wind in der Kleidung. Keine Einstellung bekommt mehr als eine Bewegung.
Schritt 6 – Ton: Wind-Atmo durchgehend, ein tiefes Streicherbett, das ab Einstellung acht anzieht, drei gezielte Soundeffekte (Karabinergeräusch, Atem, Seilspannung).
Schritt 7 – Schnitt: Die Clips werden auf 2,5 bis 5 Sekunden gekürzt, harte Schnitte auf den Takt, ein einziger langsamer Übergang vor dem Höhepunkt.
Ergebnis: ein Trailer, der in wenigen Stunden entsteht und visuell zusammenhängend wirkt – nicht, weil ein Modell perfekt ist, sondern weil der Workflow die Schwächen der einzelnen Werkzeuge auffängt.
Häufige Fehler, die Projekte ausbremsen
Zu viel Handlung in einem Clip
Generative Systeme verlieren die Kontrolle, sobald mehr als eine Handlung pro Einstellung gefordert wird. Teilen Sie komplexe Aktionen auf mehrere Clips auf.
Modell-Hopping
Wer nach jeder enttäuschenden Generierung das Werkzeug wechselt, produziert Clips in zehn verschiedenen Looks. Bleiben Sie pro Projekt bei einem Hauptmodell und wechseln Sie nur für klar definierte Sonderaufgaben.
Inkonsistenter Ton
Zwei Einstellungen mit unterschiedlicher Hintergrundatmosphäre zerstören die Illusion sofort. Prüfen Sie jede Szene stumm und dann mit Ton – viele Schnittfehler hört man früher als man sie sieht.
Fehlende Ausgabeplanung
Legen Sie vor der Produktion fest, wohin das Video geht: Hochformat für Social Media, Querformat für Web, quadratisch für Anzeigen. Das Seitenverhältnis beeinflusst die Bildkomposition erheblich und lässt sich nachträglich kaum retten.
Ton als Nachgedanke
Musik und Atmo sind keine Dekoration. Sie bestimmen, wie schnell ein Schnitt wirkt und wie viel Spannung eine Einstellung trägt. Planen Sie den Ton im Skript mit.
Werkzeugauswahl: Kriterien statt Hype
Neue Modelle erscheinen im Wochentakt. Wer jedem Versprechen folgt, verliert Zeit. Sinnvoller ist ein festes Bewertungsraster.
Die fünf Entscheidungskriterien
- Kontrolle: Wie stark lassen sich Kamera, Bewegung und Bildaufbau steuern?
- Konsistenz: Wie stabil bleibt eine Figur über mehrere Generierungen?
- Cliplänge: Reichen 4 Sekunden oder brauchen Sie 10?
- Geschwindigkeit: Wie lange dauert eine Iteration?
- Rechte und Nutzung: Welche Lizenz gilt für die erzeugten Inhalte?
Ein Testprotokoll für neue Modelle
Testen Sie jedes neue Werkzeug mit demselben Set aus fünf Aufgaben: eine Porträtaufnahme, eine Bewegung mit Figur, eine Landschaft mit Kamerafahrt, eine Detailaufnahme und eine Szene mit zwei Personen. Bewerten Sie jeden Test nach Kontrolle, Konsistenz und Nachbearbeitungsaufwand. Nach fünf Modellen haben Sie ein belastbares Bild der Landschaft, ohne sich von Marketingmaterial beeinflussen zu lassen.
Wann sich welcher Ansatz lohnt
Für kurze, einzeln stehende Clips reicht ein schnelles Modell. Für erzählerische Sequenzen brauchen Sie einen Workflow mit Bild-zu-Video, festen Referenzen und konsequenter Postproduktion. Für Produktvideos ist ein Motion-Spezialist oft die günstigste Lösung, weil er aus wenigen Bildern viel herausholt.
Qualitätssicherung, Upscaling und Ausgabe
Ausschuss einplanen
Rechnen Sie damit, dass nur etwa ein Drittel der generierten Clips verwendbar ist. Das ist keine Fehlfunktion, sondern normale Streuung. Produzieren Sie pro Einstellung zwei bis vier Varianten und wählen Sie anschließend aus.
Upscaling und Interpolation
Viele Modelle liefern niedrige Auflösungen. Ein Upscaling-Werkzeug wie Topaz Video AI verbessert Details deutlich. Bildinterpolation verdoppelt die Framerate und macht Bewegungen flüssiger – allerdings nur, wenn die Bewegung bereits sauber ist. Interpolation kaschiert keine Fehler, sie verstärkt sie.
Farbanpassung als Klebstoff
Ein einheitliches Grading ist der schnellste Weg, heterogenes Material zusammenzuführen. Setzen Sie alle Clips auf eine gemeinsame Farbpalette, vereinheitlichen Sie Kontrast und Schwarzpunkt. Die Szenen wirken danach wie aus einer Produktion.
Export
Exportieren Sie das Master in hoher Qualität und erstellen Sie daraus die Formate für die Zielplattformen. Bitraten zwischen 12 und 20 Mbit/s sind für Web-Ausgaben in Full HD ein guter Ausgangspunkt.
FAQ
Wie lang sollte ein einzelner KI-Clip sein?
Vier bis acht Sekunden sind der Bereich, in dem die meisten Modelle brauchbare Ergebnisse liefern. Längere Einstellungen wirken oft weich oder instabil. Erzeugen Sie lieber mehrere kurze Clips und schneiden Sie sie zusammen.
Brauche ich zwingend ein Bildmodell?
Nein, aber es hilft enorm. Der Bild-zu-Video-Weg ist kontrollierbarer, schneller zu korrigieren und spart Rechenzeit. Für abstrakte Hintergründe reicht oft der direkte Text-zu-Video-Weg.
Warum sieht meine Figur in jeder Szene anders aus?
Meist fehlen Referenzbilder und feste Formulierungen. Erstellen Sie ein Charakterblatt und wiederholen Sie dieselbe Beschreibung wortgleich in jedem Prompt. Vermeiden Sie starke Perspektiven in der Referenz.
Wie verhindere ich verzerrte Hände?
Reduzieren Sie Bewegung, halten Sie die Figur näher an der Kamera, und vermeiden Sie Gesten im Prompt. Hände im Ruhezustand oder teilweise verdeckt sind deutlich stabiler als gestikulierende Hände.
Wie viele Generierungen brauche ich für ein einminütiges Video?
Rechnen Sie mit zwölf bis fünfzehn Einstellungen und zwei bis vier Varianten pro Einstellung. Das ergibt grob 30 bis 60 Generierungen plus Korrekturläufe.
Ist KI-Video für Werbung geeignet?
Ja, besonders für Konzeptvisualisierungen, Social-Media-Clips und Produktanimationen. Prüfen Sie vor der Veröffentlichung die Lizenzbedingungen des jeweiligen Werkzeugs und kennzeichnen Sie generierte Inhalte dort, wo es erforderlich ist.
Welcher Fehler kostet am meisten Zeit?
Mit Abstand die fehlende Stilbibel. Wer ohne feste Referenzen arbeitet, generiert jeden Clip neu und verbringt die meiste Zeit mit Suchen statt mit Produzieren.
Was mache ich, wenn ein Modell eine Szene nicht versteht?
Zerlegen Sie die Szene in kleinere Teile: erst die Umgebung, dann die Figur, dann die Bewegung. Meist liegt das Problem in einer überladenen Beschreibung und nicht im Modell selbst.
