
Perché la coerenza visiva è il vero collo di bottiglia
Generare una singola clip fotorealistica è ormai alla portata di chiunque: si descrive una scena, si sceglie un modello di diffusione video, si attendono pochi secondi o minuti e il risultato è spesso sorprendente. Il problema emerge quando serve qualcosa di più ambizioso: una sequenza di dieci, venti o sessanta secondi in cui lo stesso volto, lo stesso abbigliamento, la stessa automobile o la stessa architettura restano riconoscibili da un'inquadratura all'altra. In quel momento la maggior parte dei flussi di lavoro mostra le sue crepe: i capelli cambiano colore, la giacca perde una cucitura, la luce salta da mezzogiorno a tramonto, il logo sul prodotto si deforma.
Questa perdita di identità visiva è il motivo per cui tanti progetti di video generativo si fermano allo stadio di prototipo. Un brand non può pubblicare uno spot in cui il volto del protagonista cambia tra il secondo tre e il secondo quattro; una serie non può permettersi un personaggio che si trasforma in modo casuale; un'agenzia immobiliare non può mostrare una casa che modifica la disposizione delle finestre durante un carrello. La coerenza non è un dettaglio estetico: è un requisito tecnico e commerciale insieme.
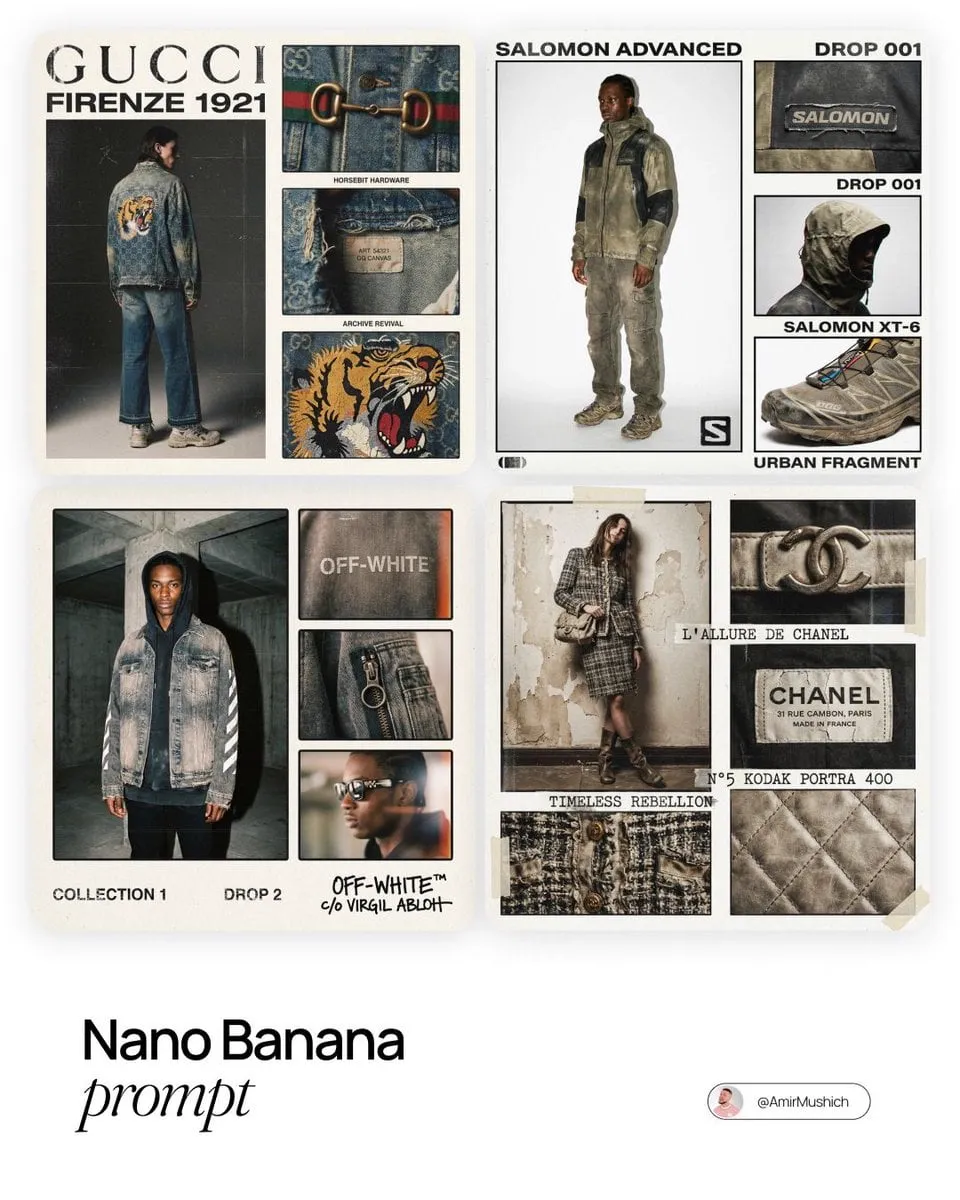
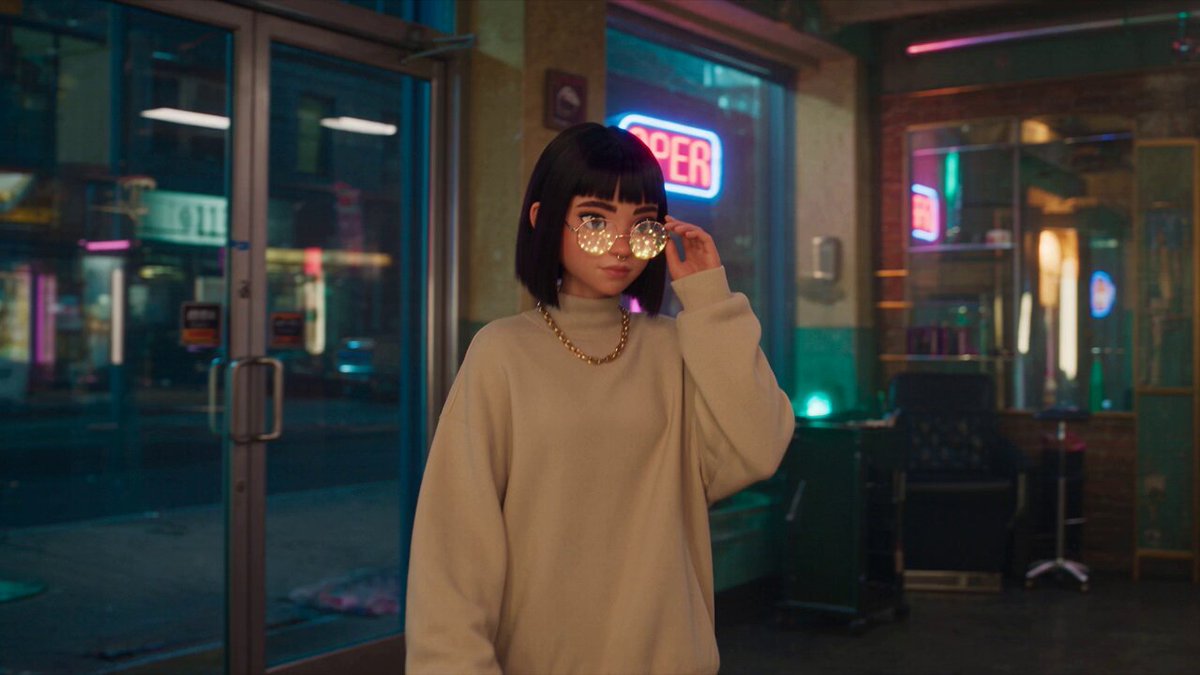
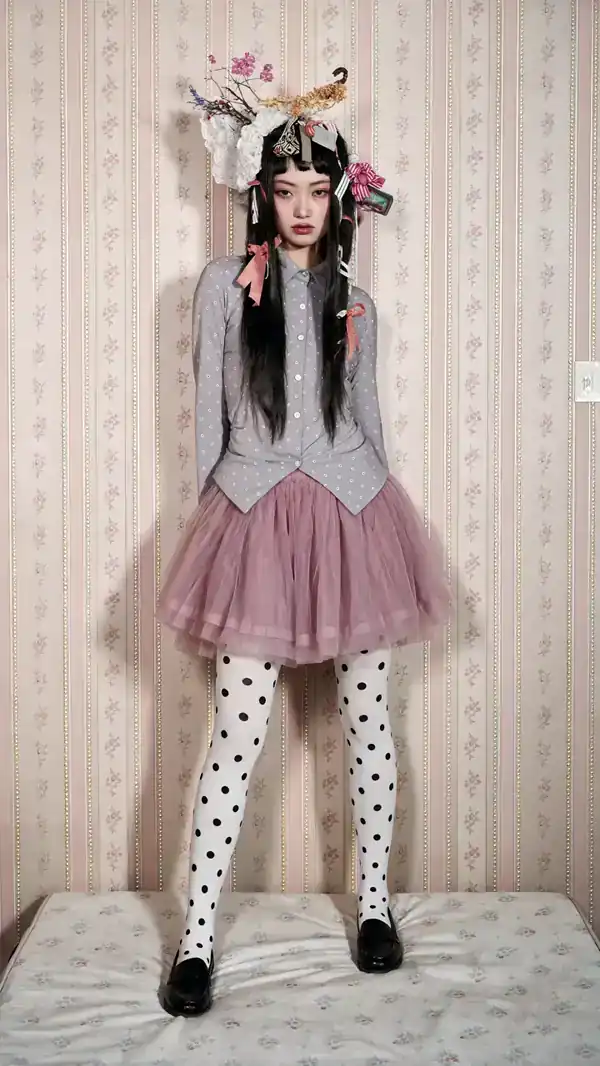
La fusione multi-immagine nasce esattamente per risolvere questo problema. Invece di affidarsi a un singolo fotogramma di partenza o a un prompt testuale, il flusso di lavoro utilizza più immagini di riferimento — volti, oggetti, ambienti, dettagli materici — e le combina per vincolare il modello generativo. Il risultato è una sequenza in cui l'identità visiva resta stabile mentre la scena evolve. Capire come funziona questo meccanismo, e soprattutto come prepararlo, è la differenza tra un esperimento curioso e un video realmente utilizzabile in produzione.
Come funziona la fusione multi-immagine
Prima di entrare nel workflow pratico conviene capire cosa fa davvero il sistema quando "fonde" più immagini. Non si tratta di un collage né di un morphing: il modello costruisce una rappresentazione latente condivisa della scena e vi inietta vincoli provenienti da ciascun riferimento.
L'ancoraggio visivo: tre categorie di riferimento
Nella pratica si lavora con tre famiglie di ancoraggi, e ciascuna ha un ruolo diverso:
- Ancoraggi di identità: primi piani del volto, profilo, tre quarti, dettagli di capelli, barba, accessori ricorrenti come occhiali o orecchini. Servono a mantenere il personaggio riconoscibile.
- Ancoraggi di stile: immagini che definiscono palette, contrasto, grana della pellicola, direzione e morbidezza della luce. Servono a mantenere un look uniforme su tutte le clip.
- Ancoraggi di ambiente e oggetto: fotografie del set, della location, del prodotto, riprese da angolazioni diverse. Servono a evitare che la geometria della scena si reinventi a ogni taglio.
Confondere queste categorie è una delle cause più comuni di risultati instabili: se si fornisce al modello un unico gruppo di immagini eterogenee, la fusione produce una media confusa invece di un vincolo preciso.
Interpolazione temporale e coerenza del personaggio
Dal punto di vista tecnico, i modelli video contemporanei generano fotogrammi in uno spazio latente e usano meccanismi di attenzione temporale per far dialogare i fotogrammi tra loro. Quando si aggiungono più immagini di riferimento, il condizionamento avviene su due fronti: il primo fotogramma viene vincolato all'ancoraggio principale, mentre i fotogrammi successivi vengono spinti verso gli stessi tratti attraverso il richiamo incrociato dei riferimenti.
Il risultato è che l'identità visiva non dipende più da un singolo punto di partenza ma da una distribuzione di esempi. È il motivo per cui tre o quattro riferimenti ben scelti battono quasi sempre un unico riferimento perfetto: il modello ha più materiale per capire cosa deve restare costante e cosa può cambiare. Un secondo vantaggio riguarda i movimenti di camera: se il set di ancoraggio contiene la stessa scena da angolazioni diverse, il modello ricostruisce una vaga idea della tridimensionalità dell'ambiente e tende a produrre parallasse più credibile nei carrelli e nelle panoramiche.
Perché un singolo seed non basta
Il seme di generazione garantisce riproducibilità, non coerenza semantica: ripetere lo stesso seed con prompt leggermente diversi produce variazioni imprevedibili del volto e dell'abbigliamento. Il seed è utile per il debug, per capire come un parametro influenza il risultato, ma non è uno strumento di continuità narrativa. La continuità si costruisce con i riferimenti visivi, con prompt coerenti tra loro e con una pipeline che tratta ogni clip come estensione della precedente anziché come progetto autonomo.
Costruire un set di riferimento che funziona
La qualità dell'output è limitata dalla qualità dell'input. Un set di ancoraggio costruito male produce video che sembrano fotorealistici per due secondi e poi tradiscono il personaggio.
Angolazioni, distanze e illuminazione
Servono almeno quattro immagini per un personaggio ricorrente: un primo piano frontale, un profilo, un tre quarti e un piano medio. Le immagini devono condividere la stessa temperatura di colore e la stessa direzione della luce principale. Se un riferimento ha luce morbida e diffusa e un altro ha luce dura laterale, il modello interpreterà la differenza come un cambiamento della scena e non come una variazione di inquadratura. Quando possibile, scatta o genera il set nella stessa sessione, con la stessa ottica e la stessa sorgente luminosa.
Risoluzione, formato e pulizia
Lavora a risoluzione uniforme e sufficientemente alta: riferimenti sfuocati o molto compressi degradano la nitidezza di tutta la sequenza. Evita ritagli aggressivi che tagliano parte del volto o delle mani, perché il modello tenderà a ricostruire in modo inventato le zone mancanti. Rimuovi dagli sfondi gli elementi che non vuoi replicare: un poster con scritte, una persona di passaggio, un riflesso anomalo possono ricomparire nel video come dettagli ricorrenti.
Sfondo e coerenza cromatica
Lo sfondo è parte dell'identità quanto il volto. Se il personaggio deve muoversi in un ambiente preciso, fornisci anche tre o quattro immagini dell'ambiente vuoto, ripreso da punti diversi. In questo modo il modello mantiene coerenti finestre, arredi e proporzioni mentre la camera si sposta. Per gli esterni, aggiungi un riferimento che definisca il cielo e la luce dominante: eviterai il classico salto da cielo terso a cielo nuvoloso nella stessa scena.
Gli errori più comuni nella preparazione
- Riferimenti con abbigliamento diverso tra un'immagine e l'altra.
- Volti in ombra, con occhiali scuri o con espressioni estreme che alterano i lineamenti.
- Immagini trattate con filtri o look diversi, che introducono un'ambiguità di stile.
- Un solo riferimento per oggetto, insufficiente a definirne la forma tridimensionale.
- Riferimenti con più persone: il modello può fondere i tratti di soggetti diversi.
- Immagini con watermark, testo o loghi indesiderati.
Workflow operativo in sette fasi
Fase 1 — Scrivere il canovaccio visivo
Prima di generare qualsiasi cosa, elenca le inquadrature in una tabella: numero, durata prevista, movimento di camera, elementi di continuità obbligatori (abbigliamento, capelli, oggetti di scena, ora del giorno). Questo documento diventa il riferimento per valutare se una clip è utilizzabile o va rigenerata.
Fase 2 — Costruire il set di ancoraggio
Raccogli i riferimenti per identità, stile e ambiente. Assegna a ciascun gruppo un ruolo chiaro e verifica che non ci siano contraddizioni. Se un ancoraggio contraddice un altro, decidi quale prevale prima di generare, non dopo.
Fase 3 — Pre-validare con immagini fisse
Genera alcuni fotogrammi chiave con gli stessi riferimenti. Le immagini statiche costano molto meno in termini di tempo e risorse, e ti permettono di correggere proporzioni, luce e palette prima di affrontare il video. Se il volto non è credibile in un fermo immagine, non lo sarà nemmeno in movimento.
Fase 4 — Generare la clip madre
Scegli l'inquadratura più rappresentativa e genera la clip "madre" alla qualità più alta disponibile. Questa clip definisce il look di tutta la sequenza: esposizione, grana, resa della pelle, comportamento del movimento. Da qui in avanti l'obiettivo non è creare clip belle a caso, ma clip compatibili con questa.
Fase 5 — Estendere con fusione multi-immagine
Per ogni clip successiva usa come input l'ultimo fotogramma della precedente insieme agli ancoraggi di identità e ambiente. Mantieni una sovrapposizione di circa mezzo secondo o un secondo tra clip adiacenti, così da avere materiale per la transizione in montaggio. Cambia una sola variabile per volta: se modifichi contemporaneamente movimento di camera, azione e illuminazione, diventa impossibile capire quale parametro ha causato un eventuale errore.
Fase 6 — Verificare i punti di cucitura
Guarda al rallentatore i fotogrammi intorno alle giunzioni. Controlla mani, capelli, tessuti, testo e riflessi: sono le aree in cui la coerenza cade per prima. Se una cucitura non regge, rigenera solo la seconda clip con un ancoraggio più forte, senza rifare l'intera sequenza.
Fase 7 — Montaggio e post-produzione
Completa il lavoro con color grading uniforme, stabilizzazione leggera dove serve, sound design e, se necessario, upscaling e interpolazione dei fotogrammi per portare tutto a un frame rate coerente. La post-produzione non corregge un personaggio incoerente, ma può nascondere piccole differenze di esposizione tra clip.
Scegliere il modello: criteri di decisione
Non esiste un modello migliore in assoluto: esiste il modello giusto per il tipo di coerenza che ti serve. Valuta quattro dimensioni.
Fotorealismo
Alcuni modelli eccellono nella resa della pelle, nei capelli e nei microdettagli; altri sono più stabili ma con una resa più pittorica. Per primi piani pubblicitari serve il massimo fotorealismo; per riprese ampie di paesaggi la differenza è meno visibile e puoi privilegiare la stabilità.
Durata e continuità
Verifica la durata massima gestibile senza perdita di coerenza e il modo in cui il modello accetta input multipli. Un modello che accetta più immagini di riferimento ma perde identità dopo pochi secondi va usato con clip brevi, montate insieme, piuttosto che con sequenze lunghe generate in un colpo solo.
Controllo del movimento
Movimenti semplici e motivati — carrelli lenti, panoramiche contenute, leggere spinte ottiche — sopravvivono molto meglio di movimenti complessi come orbite complete o zoom rapidi. Se il tuo progetto richiede movimenti articolati, scegli un modello con controllo esplicito della camera o prevedi di rigenerare più volte.
Tempo di iterazione e costo operativo
Misura quanto tempo serve per ottenere una clip accettabile, non quanto tempo serve per generarne una. Un modello leggermente meno fotorealistico che richiede due tentativi è più economico di un modello spettacolare che ne richiede quindici. Tieni traccia dei tentativi per inquadratura: è il dato che determina la sostenibilità del progetto.
Prompt e controllo fine
Descrivere la scena, non il fotogramma
Un prompt utile descrive soggetto, azione, ambiente, luce e movimento di camera in una frase coerente. Evita elenchi di aggettivi contraddittori e non ripetere i dettagli già presenti nei riferimenti visivi: se l'ancoraggio mostra una giacca blu, non serve specificare il colore, e anzi rischi di introdurre un conflitto.
Bloccare i tratti identitari
Quando un elemento deve restare identico, dichiaralo in modo esplicito e inseriscilo anche nel prompt negativo: nessun cambio di abbigliamento, nessun cambio di acconciatura, nessuna modifica del logo. Nei modelli che supportano prompt negativi, questa è la difesa più economica contro le derive.
Camera e fisica
Specifica il movimento con termini concreti: carrello laterale lento, panoramica verso destra, camera fissa con soggetto che entra in campo. Aggiungi vincoli fisici quando necessario — i piedi restano a terra, la tazza non si deforma, i capelli si muovono con il vento — perché i modelli video tendono a inventare movimenti non richiesti.
Scenari applicativi concreti
Pubblicità e product demo
Il prodotto è l'ancoraggio principale: servono immagini da più angolazioni, con la stessa illuminazione, su sfondi neutri e su sfondi d'uso. La fusione multi-immagine permette di mantenere inalterati logo, proporzioni e finiture mentre la camera si muove nello spazio. Un errore tipico è concentrarsi solo sull'estetica e trascurare la leggibilità del marchio nei primi fotogrammi.
Serie narrative e contenuti seriali
Qui la coerenza si gioca sul lungo periodo: un set di ancoraggio riutilizzabile, un canovaccio visivo condiviso e una libreria di clip già validate. La tentazione di rigenerare tutto a ogni episodio è il modo più rapido per perdere uniformità. Meglio riutilizzare i riferimenti e cambiare solo gli elementi narrativi.
Architettura, interni e ambienti
Gli ambienti richiedono ancoraggi geometrici: piante, prospetti, dettagli di materiali. La fusione multi-immagine aiuta a mantenere coerenti proporzioni e finiture durante i movimenti, ma serve una particolare attenzione alle linee rette, che nei modelli generativi tendono a curvarsi. Movimenti lenti e campo lungo riducono molto questo rischio.
Errori comuni e come risolverli
| Sintomo | Causa probabile | Rimedio |
|---|---|---|
| Il volto cambia tra clip | Ancoraggi di identità insufficienti o incoerenti | Aggiungi profilo e tre quarti, uniforma luce e abbigliamento |
| La scena si reinventa a ogni taglio | Nessun ancoraggio di ambiente | Inserisci immagini della location da più punti di vista |
| Movimenti innaturali | Prompt troppo generico o camera troppo ambiziosa | Semplifica il movimento, aggiungi vincoli fisici espliciti |
| Colori diversi tra clip | Ancoraggi con palette contrastanti | Crea un riferimento di stile unico e usalo in tutte le clip |
| Dettagli che vibrano | Risoluzione dei riferimento troppo bassa | Usa immagini più nitide e pulite |
| Testo e loghi deformati | Il modello reinterpreta la tipografia | Riduci il testo generato, inserisci la grafica in post-produzione |
Ottimizzazione di tempi, qualità e risorse
Lavorare con la fusione multi-immagine richiede disciplina più che potenza di calcolo. Tre principi riducono drasticamente gli sprechi. Primo: valida in immagine fissa prima di generare video, perché ogni minuto speso a correggere un fermo immagine ne fa risparmiare molti in movimento. Secondo: genera a bassa risoluzione per testare la coerenza e solo dopo porta a risoluzione finale le clip approvate, mantenendo gli stessi riferimenti. Terzo: archivia i set di ancoraggio come veri e propri asset di progetto, con nomi chiari e note su luce e abbigliamento, così che chiunque riprenda il lavoro possa rigenerare clip compatibili.
Checklist finale prima del render
- Il canovaccio visivo è aggiornato e tutte le inquadrature hanno un riferimento assegnato.
- Gli ancoraggi di identità, stile e ambiente sono separati e non in contraddizione.
- La prima e l'ultima clip della sequenza sono già validate.
- Le giunzioni sono state controllate al rallentatore.
- Il color grading è stato applicato in modo uniforme, non clip per clip.
- Esiste un backup dei riferimenti e dei prompt nella versione approvata.
Domande frequenti
Serve un modello diverso per ogni tipo di scena?
No, ma serve consapevolezza dei limiti. Un unico modello può coprire la maggior parte delle esigenze se accetti compromessi su durata o fotorealismo. Se il progetto include primi piani di volti e ampie vedute di ambienti, valuta due pipeline separate e unifica il look in post-produzione.
Quanti riferimenti servono per un personaggio?
Quattro sono un buon punto di partenza: frontale, profilo, tre quarti e piano medio. Aggiungi un dettaglio di capelli o di accessorio se il personaggio è ricorrente in molte clip. Oltre sei riferimenti, il beneficio marginale cala e il rischio di contraddizioni aumenta.
Posso usare immagini generate dall'AI come riferimenti?
Sì, ed è spesso la soluzione più comoda perché puoi controllare luce e abbigliamento fin dall'inizio. Attenzione però a non usare immagini che contengono già difetti: arti deformati, mani errate o prospettive impossibili verranno replicati con fedeltà.
Come gestisco i cambi di costume nella stessa storia?
Tratta ogni costume come un set di ancoraggio separato e mantieni invariati identità e ambiente. Se possibile, evita di cambiare costume all'interno della stessa clip: è più sicuro introdurre il cambio in corrispondenza di un taglio.
Perché le prime clip sono migliori delle ultime?
Perché gli errori si accumulano lungo la catena di estensioni. Ogni clip eredita piccole imprecisioni dalla precedente. Rimediare è semplice: invece di estendere all'infinito, riparti periodicamente dall'ancoraggio originale, usando l'ultima clip solo come riferimento di continuità secondario.
La fusione multi-immagine funziona anche per gli oggetti?
Funziona bene, a patto che gli oggetti siano inquadrati da più lati e con luce coerente. Per prodotti con superfici riflettenti o trasparenti la sfida è maggiore: in quei casi conviene semplificare il movimento di camera e affidare i dettagli di finitura alla post-produzione.
Quanto tempo serve per una sequenza di trenta secondi?
Dipende dal numero di inquadrature e dal tasso di accettazione. Con un set di ancoraggio solido e movimenti semplici, una sequenza di sei-otto clip si gestisce in una giornata di lavoro, includendo test, rigenerazioni e montaggio. Senza una preparazione adeguata, lo stesso lavoro può richiedere diversi giorni di tentativi casuali.
Devo sempre usare il primo fotogramma della clip precedente?
Non è obbligatorio, ma è la strategia più affidabile per la continuità. In alternativa puoi usare un fotogramma intermedio della clip precedente come punto di partenza, ottenendo una sovrapposizione maggiore e una transizione più morbida in montaggio.
