
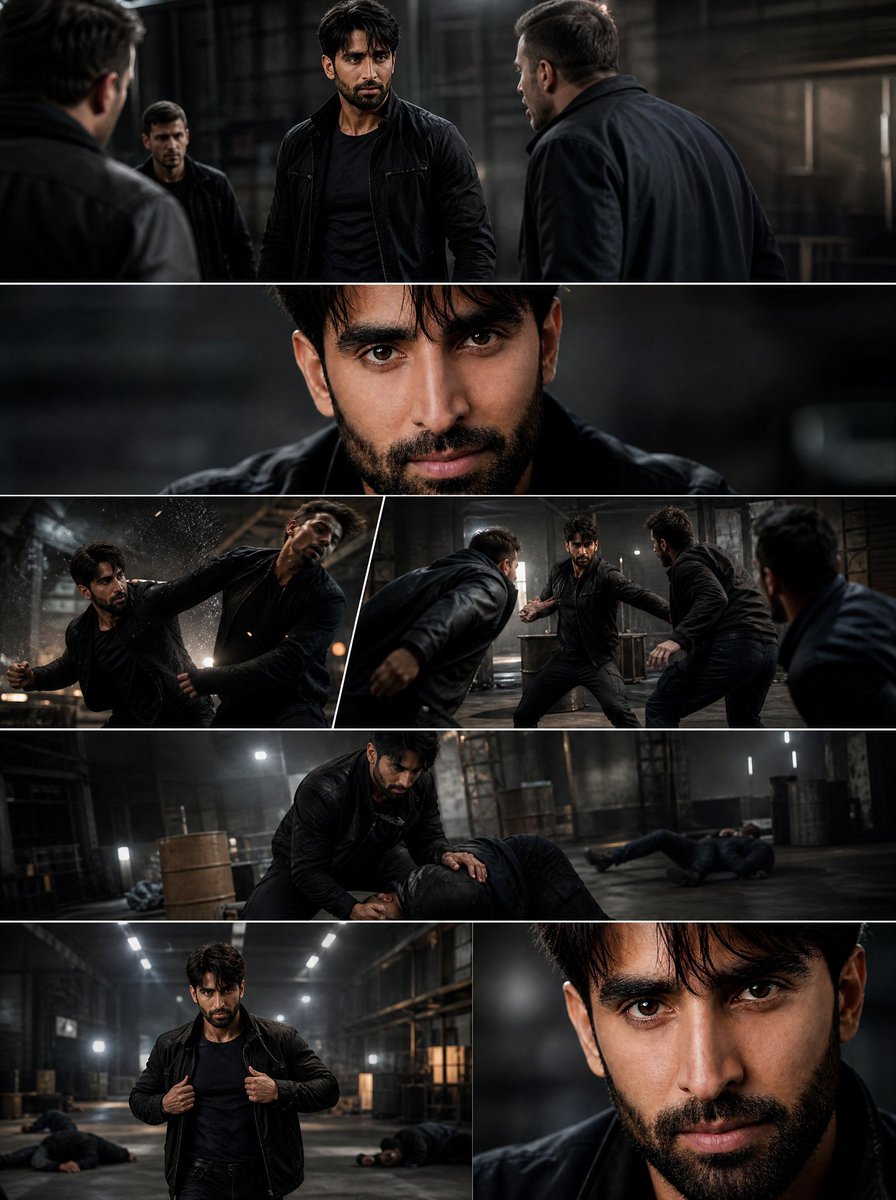
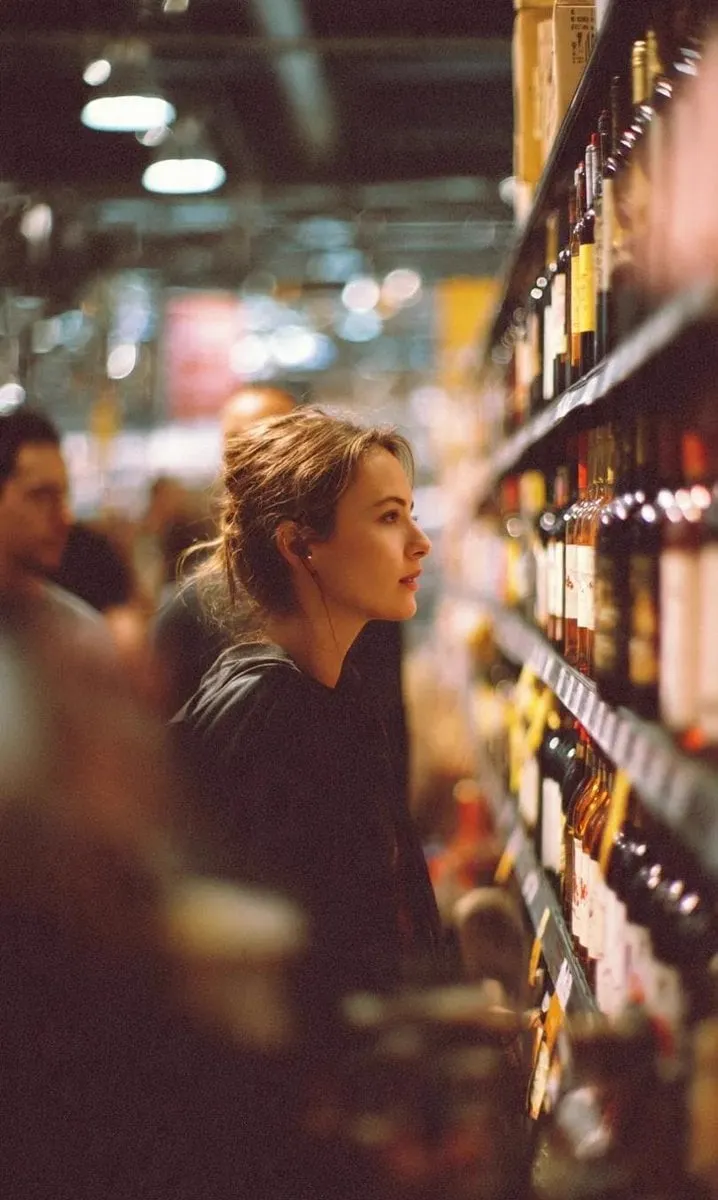
Trasformare una frase in un'inquadratura che sembra girata da una vera macchina da presa è oggi una delle frontiere più interessanti della produzione audiovisiva assistita dall'intelligenza artificiale. Eppure, tra il prompt scritto di getto e un risultato credibile c'è di mezzo un metodo: lessico tecnico, controllo della luce, gestione della coerenza tra le scene e una buona dose di disciplina in post-produzione. Questa guida raccoglie tutto ciò che serve per passare da output casuali a sequenze fotorealistiche utilizzabili in un progetto reale.
Perché il fotorealismo generativo è diventato una competenza
Fino a poco tempo fa la generazione video con AI produceva materiali dai contorni morbidi, volti instabili e movimenti gommosi. Oggi i modelli più avanzati riescono a sostenere dettagli come la porosità della pelle, il riflesso dell'umidità sull'asfalto o la grana di un sensore ad alta sensibilità. Il risultato è che il collo di bottiglia non è più la potenza del modello, ma la capacità di chi scrive il prompt di descrivere con precisione ciò che vuole vedere.
Questa competenza è trasversale. Serve al filmmaker indipendente che vuole testare uno storyboard senza noleggiare attrezzatura, al creatore di contenuti che pubblica ogni giorno e ha bisogno di riprese difficili da girare, all'agenzia che deve presentare concept visivi a un cliente prima che il budget venga approvato, al docente che vuole illustrare un fenomeno con una ricostruzione plausibile.
Il punto chiave è che il fotorealismo non è un effetto da attivare con un pulsante. È il risultato di una catena di decisioni: quale modello usare, come è strutturato il testo, quale fotogramma di partenza viene fornito, come vengono impostati durata e movimento, quanto lavoro di rifinitura viene fatto dopo. Chi controlla l'intera catena ottiene risultati consistenti; chi si affida solo alla fortuna ottiene qualche scatto felice e molta frustrazione.
Come funziona davvero un modello text-to-video
Capire l'architettura aiuta a scrivere prompt migliori. Anche senza entrare nei dettagli matematici, sapere come il modello interpreta le istruzioni cambia il modo in cui si descrive una scena.
Diffusione e transformer: due famiglie con comportamenti diversi
I modelli a diffusione partono da rumore casuale e lo ripuliscono progressivamente, guidati dal testo. Sono spesso più forti sulla qualità estetica dell'immagine e sulla resa materica: pelle, metallo, tessuto, acqua. I modelli basati su architetture transformer, invece, eccellono nel mantenere relazioni coerenti tra gli elementi nel tempo, il che si traduce in movimenti più stabili e in una maggiore fedeltà all'azione descritta.
Nella pratica, questo si traduce in una regola semplice: se il tuo obiettivo è un primo piano di forte impatto visivo, i modelli a diffusione tendono a dare soddisfazioni immediate; se devi raccontare un'azione con più passaggi, un transformer specializzato offre spesso una struttura narrativa più solida. Molte piattaforme combinano le due cose in pipeline ibride, ed è lì che si ottengono i risultati migliori.
Il limite della coerenza temporale
Ogni modello text-to-video ha una durata efficace oltre la quale la scena comincia a degradarsi: gli oggetti si moltiplicano, i volti cambiano, le mani perdono dita. Non è un difetto da correggere con un prompt più lungo, ma un limite strutturale da aggirare con la frammentazione. Invece di chiedere un piano sequenza di venti secondi, conviene progettare tre inquadrature da cinque secondi ciascuna, ognuna con un'azione chiara e un punto di taglio naturale.
Questo approccio ha un vantaggio ulteriore: rende il montaggio più semplice e permette di rigenerare solo il frammento problematico, senza buttare via tutto il lavoro.
L'anatomia di un prompt fotorealistico
Un prompt efficace non è una poesia, è una specifica tecnica scritta in linguaggio naturale. La struttura che funziona meglio è quasi sempre la stessa: soggetto, azione, ambiente, luce, ottica, movimento, atmosfera, audio.
Soggetto, azione e ambiente
Inizia dal centro dell'inquadratura. Non "una donna in città", ma "una donna sulla quarantina, capelli mossi raccolti in una coda bassa, giacca di pelle consumata, cammina sotto la pioggia su un marciapiede di una strada secondaria". Poi aggiungi l'azione con un verbo preciso: non "si muove", ma "si volta lentamente verso la vetrina e solleva il mento". Infine colloca la scena in uno spazio concreto, con materiali e dettagli che il modello possa rendere: asfalto bagnato, insegne al neon sbiadite, pozzanghere che riflettono le luci.
Linguaggio tecnico: ottiche, sensori, emulsioni
Il vocabolario della fotografia è uno degli strumenti più potenti a disposizione. Frasi come "obiettivo 35mm, apertura f/1.8, profondità di campo ridotta" oppure "ripresa con teleobiettivo 85mm, compressione dello sfondo" cambiano radicalmente la resa prospettica. Anche il formato conta: un 16:9 cinematografico, un formato verticale per i social o un 4:3 che richiama il documentario televisivo producono sensazioni diverse.
Aggiungere riferimenti a pellicole o sensori aiuta a definire la grana e la risposta cromatica: "grana fine da pellicola 35mm", "immagine pulita da sensore full frame", "leggero blooming sulle alte luci". Sono indicazioni che il modello traduce in texture visiva.
Luce, ora del giorno e atmosfera
La luce è il fattore che più incide sulla sensazione di realismo. Descrivila in termini di direzione, qualità e colore: "luce laterale morbida dell'ora blu, temperatura fredda, ombre lunghe", "sole diretto di mezzogiorno, ombre dure e contrasto elevato", "neon misto a luce naturale proveniente da una finestra, dominante verde".
Aggiungi elementi atmosferici solo se servono: nebbia leggera, pulviscolo in controluce, vapore che sale da un tombino. Troppi effetti sovrapposti confondono il modello e producono un'immagine sporca.
Movimento di camera e ritmo
Il movimento va specificato con chiarezza perché definisce il tempo della scena. Le opzioni più affidabili sono poche: camera fissa su cavalletto, panoramica orizzontale lenta, carrello in avanti, carrello laterale, steadycam che segue il soggetto, drone in salita. I movimenti combinati e troppo veloci aumentano il rischio di artefatti.
Specifica anche la velocità: "lento e costante", "impercettibile", "scatto rapido". Se vuoi un effetto realistico, ricorda che nella fotografia reale i movimenti a mano libera hanno micro-oscillazioni, mentre i movimenti su binario sono fluidissimi. Descrivere quale dei due vuoi aiuta il modello a scegliere il registro giusto.
Suono e dialogo
Se il modello supporta l'audio, il prompt dovrebbe includere anche l'ambiente sonoro: pioggia sui cofani, brusio di un mercato, ronzio di un frigorifero, eco di un corridoio vuoto. Per i dialoghi è meglio limitarsi a brevi battute: la sincronizzazione labiale perfetta resta uno dei punti più fragili, e le frasi corte riducono il rischio di risultati stranianti.
Un flusso di lavoro in sette tappe
La differenza tra un esperimento e un progetto finito sta nella ripetibilità. Questo schema funziona sia per un singolo clip sia per una sequenza articolata.
Tappa 1 — Concept e shot list
Scrivi a mano, su carta o in un documento, cosa deve accadere in ogni inquadratura. Una riga per scena: soggetto, azione, luogo, durata prevista. Questo passaggio sembra superfluo ma è quello che evita di generare trenta clip scollegate tra loro.
Tappa 2 — Raccolta di riferimenti visivi
Cerca immagini o fotogrammi che assomiglino al risultato desiderato. Ti serviranno sia come ispirazione per il testo sia, se il modello lo consente, come input visivo. Descrivi i riferimenti a parole: "come un controluce in interni con finestra a est" è più utile di un aggettivo vago.
Tappa 3 — Passaggio esplorativo
Genera versioni brevi, da tre a cinque secondi, con prompt sintetici. L'obiettivo non è la qualità finale ma capire come il modello interpreta la tua descrizione. Salva tutto, anche i risultati sbagliati: spesso contengono dettagli utili da riutilizzare.
Tappa 4 — Raffinamento dei parametri
Una volta trovata la direzione giusta, lavora su una variabile alla volta: prima la luce, poi l'ottica, poi il movimento. Cambiare cinque elementi insieme rende impossibile capire cosa ha migliorato il risultato.
Tappa 5 — Coerenza tra le inquadrature
Prima di generare le scene successive, congela i parametri che definiscono l'identità visiva: descrizione del personaggio, palette, tipo di luce, formato, grana. Riutilizza gli stessi blocchi di testo e modifica solo l'azione e l'angolazione.
Tappa 6 — Audio e montaggio
Assembla le clip in ordine, verifica i raccordi di movimento e di sguardo, aggiungi l'audio. Spesso una colonna sonora ben costruita maschera piccole imperfezioni visive e rende la sequenza molto più credibile.
Tappa 7 — Controllo qualità
Guarda il montaggio a velocità normale, poi fotogramma per fotogramma nei punti critici: mani, occhi, bordi degli oggetti, riflessi. Se un dettaglio cede, rigenera solo quella clip con un prompt più vincolato.
Coerenza di personaggio e ambiente tra le inquadrature
È il problema numero uno di chi lavora su sequenze più lunghe di un singolo piano. Il modello non ricorda nulla tra una generazione e l'altra, quindi la memoria va costruita dall'esterno.
Il metodo più affidabile è la scheda personaggio: un blocco di testo fisso, sempre identico, che descrive età, corporatura, capelli, abbigliamento, tratti distintivi e postura. Va copiato e incollato in ogni prompt, anche quando sembra ridondante.
Il secondo strumento è il fotogramma di riferimento. Se il modello accetta un'immagine come input, genera prima un ritratto frontale pulito, poi usalo come base per le altre inquadrature. In alternativa, estrai il fotogramma migliore da una clip già approvata e usalo come punto di partenza.
Il terzo è la coerenza ambientale: definisci la scena con tre o quattro elementi fissi (un lampione, un'insegna, un tipo di pavimentazione) e ripetili in ogni prompt che si svolge nello stesso luogo. Il pubblico percepisce la continuità attraverso i dettagli ricorrenti, non attraverso la precisione geografica.
Immagine-to-video e controllo del movimento
Partire da un'immagine statica è spesso la scorciatoia più efficace verso il fotorealismo. Il vantaggio è che composizione, luce e identità visiva sono già risolte: il modello deve solo animare. Funziona particolarmente bene per paesaggi, primi piani, nature morte e scene in cui il movimento è contenuto.
Il rovescio della medaglia è il rischio di un risultato "fotografia che respira": l'immagine si muove ma non accade nulla. Per evitarlo, inserisci nel prompt un micro-evento: un colpo di vento, lo spostamento di uno sguardo, il passaggio di un veicolo sullo sfondo, una tenda che si gonfia.
Quando il modello offre controlli aggiuntivi per guidare il movimento, conviene usarli con parsimonia. Una traiettoria semplice e realistica batte sempre una coreografia complessa che il modello non riesce a sostenere.
Errori frequenti e correzioni rapide
Prompt enciclopedici. Elenchi di venti aggettivi producono immagini caotiche. Riduci a cinque o sei elementi davvero importanti e lascia che il modello riempia i vuoti.
Linguaggio astratto. "Atmosfera malinconica" non è visibile. Traduci sempre le emozioni in elementi concreti: luce, posa, oggetti, meteo.
Movimenti impossibili. Carrello, panoramica e zoom simultanei generano distorsioni. Scegli un solo movimento primario per clip.
Incoerenza tra clip. Se cambi formato, palette o descrizione del personaggio tra una scena e l'altra, il montaggio sembrerà un collage. Tieni un documento con i blocchi fissi.
Fiducia cieca nel primo risultato. Le clip migliori sono quasi sempre la quarta o quinta iterazione. Pianifica il tempo per le rigenerazioni.
Ignorare l'audio. Una clip visivamente perfetta con un audio sbagliato risulta falsa. Curate il suono con la stessa attenzione dell'immagine.
Criteri per scegliere lo strumento giusto
Non esiste un modello migliore in assoluto, esiste il modello giusto per il tuo caso d'uso. Valuta questi criteri in ordine di importanza.
Fedeltà al prompt. Alcuni strumenti interpretano bene le istruzioni tecniche, altri privilegiano la bellezza dell'immagine. Prova lo stesso prompt su due o tre sistemi e confronta.
Durata utile. Verifica per quanti secondi la scena resta stabile. Una durata nominale lunga non serve se gli ultimi tre secondi sono inutilizzabili.
Controllo del movimento. Se lavori su animazione di prodotto o su inquadrature di design, la possibilità di definire traiettorie è più importante della resa estetica.
Gestione del formato. Per i social verticali serve un modello che non degradi il soggetto quando si cambia proporzione.
Costo per secondo utilizzabile. Non guardare il prezzo nominale: calcola quante generazioni servono per ottenere un secondo accettabile. Un sistema apparentemente economico che richiede dieci tentativi costa più di uno che ne richiede due.
Integrazione nel flusso. Se devi produrre molte clip, la possibilità di riutilizzare preset, descrizioni salvate e input immagine fa risparmiare più tempo di qualsiasi miglioramento marginale nella qualità.
Post-produzione: dove l'AI finisce e inizia il montaggio
Anche la clip migliore ha bisogno di rifinitura. Il primo intervento è il color grading: uniformare le clip tra loro è più importante che renderle singolarmente spettacolari. Un leggero contrasto in più e una dominante coerente fanno sembrare un montaggio molto più professionale.
Il secondo è la stabilizzazione selettiva. Alcune clip hanno micro-oscillazioni innaturali: un filtro di stabilizzazione leggero le rende più credibili, purché non venga applicato in modo aggressivo.
Il terzo è il sound design. Passi, respiri, tessuti, ambiente: sono gli elementi che il pubblico associa al realismo più di qualsiasi dettaglio visivo. Se possibile, registra suoni reali e sovrapponili alle clip generate.
Il quarto è la grana unificata. Applicare una texture di pellicola uniforme su tutta la sequenza è il trucco più semplice per nascondere le differenze tra clip generate separatamente.
Infine, il montaggio vero e proprio. Taglia l'inizio e la fine di ogni clip: i primi e gli ultimi fotogrammi sono quasi sempre i meno stabili. Mantieni il ritmo e non aver paura di sacrificare un'inquadratura spettacolare se rallenta la narrazione.
FAQ
Serve esperienza di fotografia per ottenere risultati fotorealistici? Non è obbligatoria, ma conoscere termini come apertura, focale e temperatura colore accelera molto il processo. Bastano poche nozioni di base per scrivere prompt più precisi.
Quante parole deve avere un buon prompt? Non c'è una regola fissa. Nella maggior parte dei casi un prompt efficace sta tra le cinquanta e le centoventi parole, molto denso di informazioni tecniche e privo di ripetizioni.
Perché il mio personaggio cambia aspetto tra le scene? Perché il modello non conserva memoria tra le generazioni. Usa una scheda personaggio fissa e, se possibile, un'immagine di riferimento come input.
Meglio text-to-video o image-to-video? Dipende dal controllo che ti serve. Il text-to-video è più veloce per esplorare, l'image-to-video è più affidabile quando composizione e identità visiva devono essere esatte.
Si possono generare dialoghi credibili? Frasi brevi sì, conversazioni lunghe restano difficili da sincronizzare. Una buona strategia è generare il video senza dialogo e registrare le voci separatamente.
Quanto materiale bisogna generare per avere una sequenza finita? Come ordine di grandezza, aspettati di produrre da tre a cinque volte il metraggio finale. È normale: la selezione fa parte del mestiere.
I video generati si possono usare in progetti commerciali? Dipende dalle condizioni del servizio utilizzato e dalla giurisdizione in cui operi. Verifica sempre le licenze prima di pubblicare.
Qual è il modo più rapido per migliorare? Rigenerare lo stesso prompt modificando una sola variabile alla volta, per dieci o quindici iterazioni. Si impara molto più da un confronto controllato che da cento prompt diversi.
