
Perché conviene costruire un modello video su misura
I modelli generici hanno raggiunto una qualità sorprendente, ma lavorano su un principio preciso: ogni clip nasce come un evento autonomo. Se chiedi la stessa donna con i capelli rossi in tre scene diverse, otterrai tre donne simili ma non identiche. Se chiedi lo stesso packaging di prodotto, otterrai loghi deformati e proporzioni ballerine. Questo non è un difetto del modello, è la conseguenza logica di un sistema addestrato per produrre varietà, non ripetibilità.
Un modello su misura ribalta la prospettiva. Invece di sperare che il modello generalista indovini il tuo soggetto, gli insegni esplicitamente come appare, come si muove e come si comporta. Il risultato non è solo più somiglianza: è prevedibilità. E la prevedibilità, in produzione, vale più della qualità pura.
Vale la pena investire in un modello personalizzato quando ricorrono almeno due di queste condizioni:
- Hai un personaggio che deve apparire in più episodi, spot o clip di una serie.
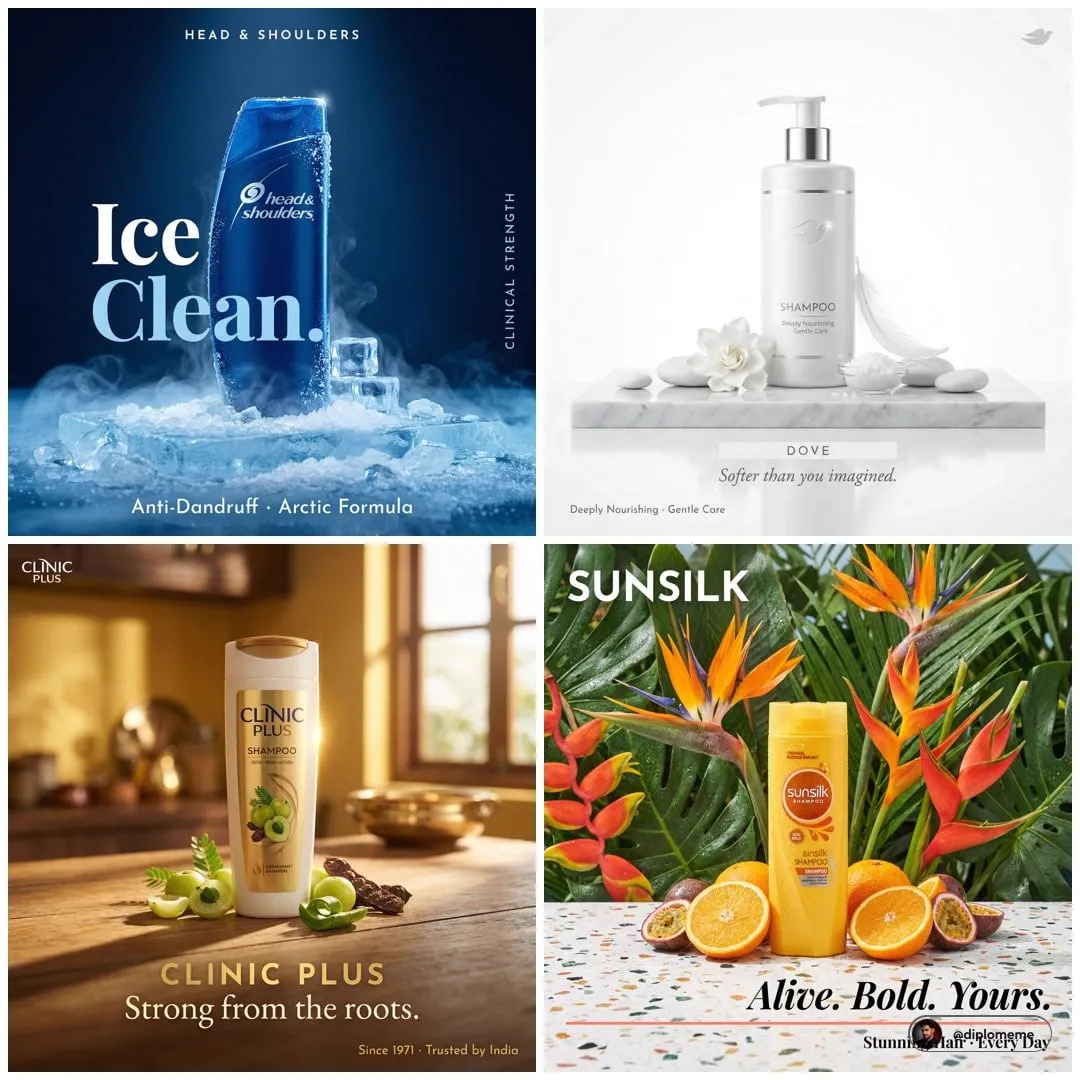
- Devi mostrare ripetutamente un prodotto fisico con dettagli tecnici riconoscibili.
- Hai uno stile visivo proprietario (grana, palette, tipo di movimento di camera) che vuoi replicare all'infinito.
- Produci volumi elevati e ogni rigenerazione manuale ti costa ore di lavoro.
- Hai bisogno di un linguaggio di movimento specifico, difficile da descrivere a parole a un modello generalista.
Al contrario, se stai realizzando un video isolato, se il budget è limitato o se l'output dei modelli generalisti ti soddisfa già, l'addestramento è uno spreco di tempo. La regola pratica è semplice: personalizza quando la ripetizione è parte del valore, non quando la sorpresa è il punto.
Anatomia di un pipeline di generazione video
Prima di parlare di addestramento, serve chiarezza su come è fatto un pipeline di generazione video moderno. Chi lo tratta come una scatola magica finisce per non capire dove intervenire quando qualcosa non funziona.
Dal testo alla clip
Il primo strato è la comprensione del prompt: un encoder testuale traduce la descrizione in una rappresentazione numerica. Il secondo strato è il generatore vero e proprio, che a partire da rumore casuale costruisce frame coerenti nel tempo. Il terzo strato è il decodificatore, che riporta il risultato in pixel visibili. Ogni passaggio ha parametri propri, e intervenire su quello sbagliato è l'errore più comune di chi inizia.
Image-to-video e controllo del movimento
La generazione da immagine singola è spesso più utile della generazione da testo, perché ti permette di fissare composizione, volto e luce prima di animare. Il modello si occupa solo del movimento, che è esattamente la parte in cui i modelli sono più deboli. Aggiungere un primo frame di riferimento riduce drasticamente le variazioni indesiderate.
Upscaling e interpolazione
Una clip generata a risoluzione contenuta, portata a risoluzione di consegna e rifinita con interpolazione dei fotogrammi, spesso batte una clip generata direttamente in alta risoluzione. Il motivo è economico e tecnico: generare in grande formato richiede molte più risorse e tende a introdurre artefatti, mentre l'upscaling lavora su un materiale già stabile.
Orchestrazione e code di lavoro
Un pipeline serio non lancia una clip alla volta. Accoda i job, gestisce i fallimenti, conserva i parametri usati e permette di riprodurre esattamente una generazione fatta giorni prima. Senza questa disciplina, ogni risultato è irripetibile e il progetto diventa impossibile da mantenere.
Addestrare e rifinire un modello: dataset, etichette e igiene dei dati
La qualità di un modello personalizzato dipende per l'ottanta per cento dal dataset e per il venti per cento dai parametri di addestramento. Chi inverte queste proporzioni passa settimane a ritoccare valori mentre il vero problema è nelle immagini.
Quanti esempi servono davvero
Per un volto o un personaggio, un piccolo insieme ben curato di quindici-venti immagini ad alta qualità può bastare per una personalizzazione leggera. Per uno stile visivo più astratto servono più esempi, spesso cinquanta o più, perché il modello deve astrarre una regola e non memorizzare un soggetto. Per un prodotto con dettagli tecnici conviene combinare immagini pulite su fondo neutro e immagini in contesto reale.
Pulizia, duplicati e bilanciamento
Elimina le immagini sfocate, quelle con motion blur eccessivo e quelle in cui il soggetto è tagliato. Rimuovi i duplicati quasi identici: non aggiungono informazione, ma spostano il bilanciamento. Bilancia le pose, le angolazioni e le condizioni di luce. Se il tuo dataset contiene solo primi piani frontali, il modello saprà fare solo primi piani frontali.
Prompt di training e cattura del concetto
Ogni immagine va accompagnata da una descrizione onesta. Se scrivi sempre «personaggio» senza descrivere abbigliamento e sfondo, il modello assocerà il concetto anche allo sfondo, e poi lo replicherà in ogni generazione. Descrivi ciò che vuoi che sia variabile e ometti ciò che vuoi che diventi identità.
Valutazione con un set di test
Prima di integrare il modello nella produzione, prepara una decina di prompt di test che coprono i casi realistici: primo piano, piano medio, movimento rapido, controluce, azione. Confronta i risultati con quelli di un modello generalista. Se la differenza non è evidente a colpo d'occhio, il modello non è pronto.
Scegliere il modello giusto per ogni scena
Non esiste un modello migliore in assoluto. Esiste il modello giusto per una scena, un budget e una scadenza.
Priorità: qualità cinematografica
Quando la scena è il cuore del progetto, servono modelli capaci di gestire luce complessa, profondità di campo e movimenti di camera fluidi. Sono i più lenti e i più costosi, quindi si usano per pochi piani chiave, non per l'intero montaggio.
Priorità: velocità e costo
Per animatic, previsualizzazioni, test di montaggio e contenuti social quotidiani, la velocità batte la perfezione. Modelli più leggeri permettono decine di iterazioni in un pomeriggio, e l'iterazione è ciò che produce qualità finale.
Priorità: stile e animazione
Per contenuti illustrati, animazione stilizzata o estetiche non fotorealistiche, i modelli specializzati in stile offrono risultati che quelli fotorealistici non raggiungono nemmeno con prompt elaborati.
Tabella decisionale
| Obiettivo | Tipo di modello | Quando usarlo |
|---|---|---|
| Piano chiave di uno spot | Alta qualità cinematografica | Pochi secondi, massima resa |
| Test di montaggio | Veloce e leggero | Molte iterazioni rapide |
| Personaggio ricorrente | Personalizzato su dataset | Serie, episodi, campagne |
| Prodotto tecnico | Image-to-video con riferimento | Packaging, dettagli, logo |
| Contenuto social | Modello rapido con formato verticale | Volume alto, ciclo breve |
| Animazione stilizzata | Modello specializzato per stile | Estetiche non fotorealistiche |
Workflow completo: uno spot di prodotto in otto passaggi
Vediamo come tutto questo si traduce in pratica, con un esempio realistico: uno spot di trenta secondi per un prodotto fisico.
- Brief visivo. Definisci palette, tono, ritmo e i tre momenti narrativi essenziali. Un video AI senza struttura narrativa sembra sempre una demo tecnica.
- Raccolta riferimenti. Seleziona venti immagini del prodotto, cinque riferimenti di luce e tre riferimenti di movimento di camera.
- Preparazione dataset. Ritaglia, uniforma e descrivi le immagini del prodotto. Questo passaggio è noioso e insostituibile.
- Addestramento leggero. Allena una personalizzazione sul prodotto e valuta con il set di test. Non proseguire finché il packaging non è stabile.
- Generazione dei piani chiave. Produci i tre momenti principali in image-to-video, partendo da frame di riferimento fissi. Genera quattro varianti per piano.
- Generazione dei piani di raccordo. Riempì i vuoti con piani brevi generati da testo, coerenti per luce e lente.
- Selezione e assemblaggio. Monta su una timeline, taglia sull'azione, verifica che il ritmo regga anche senza audio.
- Rifinitura. Upscaling, stabilizzazione, color grading, sonoro e consegna nei formati richiesti.
Ogni passaggio produce artefatti che diventano input del successivo. Se salti la preparazione del dataset, il passaggio cinque ti restituirà un prodotto irriconoscibile e dovrai ricominciare dal punto tre.
Coerenza del personaggio, dello stile e del brand
La coerenza è la metrica che distingue un progetto amatoriale da uno professionale, ed è anche la più difficile da ottenere con la sola scrittura di prompt.
Sul piano del personaggio, la strategia più affidabile è fissare elementi immutabili: un primo frame di riferimento per ogni scena, un set di descrizioni consolidate da riutilizzare parola per parola, e una verifica visiva prima di generare la clip completa. Cambiare l'ordine delle parole nel prompt cambia il risultato più di quanto si immagini.
Sul piano dello stile, conviene definire un piccolo vocabolario visivo interno: tipo di lente, altezza della camera, direzione della luce, grana, saturazione. Ripetere questi elementi in ogni prompt fa più per la coerenza di qualsiasi parametro tecnico.
Sul piano del brand, la coerenza riguarda anche ciò che non deve apparire: loghi deformati, colori fuori palette, testo illeggibile. La soluzione pragmatica è generare senza loghi e aggiungerli in post-produzione, dove hai controllo totale su nitidezza e posizionamento.
Audio, labiale e sound design
Il video generato è silenzioso, e il silenzio è la ragione principale per cui molti contenuti AI sembrano finti. Il suono arriva da un pipeline separato, che va progettato con la stessa cura.
Per la voce, la sintesi vocale moderna permette di scegliere timbro, ritmo e intonazione, e di rigenerare una singola frase senza rifare tutto il resto. Per il labiale, l'approccio più sicuro è generare prima il parlato, poi adattare il movimento della bocca alla traccia audio: fare il contrario porta a inseguire un audio che non esiste.
Per l'ambiente, i suoni di fondo — passi, tessuto, vento, ambiente urbano — fanno più lavoro di convincimento di qualsiasi effetto spettacolare. Un piano di prodotto che galleggia nel silenzio assoluto sembra un rendering; lo stesso piano con un leggero rumore d'ambiente sembra girato.
Infine, la musica. Scegli un brano con licenza chiara e costruisci il montaggio sul suo ritmo, non viceversa.
Post-produzione e consegna multi-formato
La post-produzione è dove il materiale generato diventa un video. Le operazioni che danno il miglior rapporto tra sforzo e risultato sono quattro.
La prima è l'upscaling selettivo: applicalo solo ai piani effettivamente visibili a schermo intero, non a tutto il girato.
La seconda è la stabilizzazione mirata. Alcune clip hanno micro-oscillazioni che l'occhio percepisce come disturbo, e un leggero stabilizzatore risolve senza introdurre artefatti.
La terza è il color grading. Un modello di colore coerente applicato a tutte le clip nasconde le differenze tra generazioni fatte in momenti diversi ed è il trucco più efficace per unificare il materiale.
La quarta è la consegna multi-formato. Oggi un singolo progetto deve vivere in verticale, orizzontale e quadrato. Genera i piani chiave già pensando all'inquadratura verticale, oppure riquadra in post-produzione con un soggetto posizionato al centro: rifare la generazione per ogni formato è la voce di costo che fa esplodere i tempi.
Errori frequenti, checklist e criteri decisionali
Alcuni errori ricorrono con una frequenza quasi statistica.
- Addestrare troppo poco o troppo. Un modello sovraddestrato replica il dataset alla lettera e non generalizza; uno sottodestrato ignora le istruzioni.
- Usare immagini di bassa qualità nel dataset. Il modello impara la sfocatura insieme al soggetto.
- Scrivere prompt lunghissimi. Frasi sovraccariche confondono l'encoder; meglio un soggetto, un'azione, un'ambientazione.
- Dimenticare il primo frame. Rinunciare al controllo dell'inquadratura iniziale è la causa numero uno di varianza.
- Non conservare i parametri. Senza registrazione di prompt, seed e impostazioni, ogni rigenerazione è una scommessa.
- Valutare solo in anteprima. Un difetto che non vedi in un fotogramma diventa evidente a schermo intero.
Checklist prima di considerare finito un progetto: personaggio stabile in tutte le scene, prodotto riconoscibile, palette coerente, audio sincronizzato, nessun fotogramma con artefatti evidenti, formati di consegna esportati, parametri archiviati.
Sui criteri decisionali, valuta ogni scelta su tre assi: impatto sullo spettatore, tempo di produzione, consumo di risorse. Una scena che non sposta la narrazione non merita venti iterazioni. Una scena che apre il video merita anche trenta.
Domande frequenti
Serve una scheda grafica potente per un pipeline di questo tipo?
Dipende da dove gira il modello. Se usi servizi esterni, il collo di bottiglia è la connessione e il budget, non l'hardware. Se esegui in locale, la memoria video è il vincolo principale: senza una scheda adeguata, alcuni modelli semplicemente non si avviano.
Quanto tempo richiede addestrare un modello personalizzato?
Per una personalizzazione leggera su poche immagini, poche ore tra preparazione, addestramento e test. Il tempo vero viene assorbito dalla preparazione del dataset, che è anche la fase che determina il risultato.
Posso usare un modello personalizzato per più clienti diversi?
Tecnicamente sì, ma è una cattiva idea mescolare soggetti nello stesso modello: le identità si contaminano. Conviene mantenere un modello per soggetto o per stile, e richiamarlo solo quando serve.
Come capisco se il problema è il prompt o il modello?
Prova lo stesso prompt su un modello generalista. Se il risultato è ragionevole, il problema è nel modello personalizzato, quasi sempre nel dataset. Se anche il generalista fallisce, il prompt è ambiguo o sovraccarico.
Quante varianti conviene generare per ogni piano?
Quattro è un buon punto di partenza: abbastanza per avere scelta, non così tante da paralizzare la selezione. Per i piani di apertura puoi salire a otto.
I video generati possono essere usati commercialmente?
Dipende dalla licenza del modello e dalle condizioni del servizio che usi. Verifica sempre i termini prima di pubblicare, soprattutto per contenuti con volti riconoscibili o marchi di terzi.
Come mantengo la coerenza tra sessioni diverse?
Salva prompt, seed, parametri e frame di riferimento in un documento condiviso. La coerenza tra sessioni è un problema di documentazione, non di tecnologia.
In sintesi, un pipeline video affidabile non nasce dalla scelta del modello più costoso, ma dalla disciplina con cui prepari i dati, controlli l'inquadratura, generi varianti e rifinisci in post-produzione. Il modello è uno strumento; il metodo è ciò che rende il risultato ripetibile.
