
Vídeo gerado por inteligência artificial deixou de ser experimento técnico e passou a ocupar o centro da produção de conteúdo digital no Brasil. Quem trabalha com redes sociais, tráfego pago, e-commerce ou educação online já percebeu que a pergunta mudou: não é mais "vale a pena usar IA para criar vídeos?", e sim "como manter qualidade e consistência quando a produção escala?". Este guia mostra o caminho prático, do roteiro ao corte final, para produzir vídeos verticais com Text-to-Video e Image-to-Video, com decisões explicadas, critérios de escolha e erros que vale evitar.
Por que a produção de vídeo com IA mudou a economia do conteúdo
A produção audiovisual sempre teve dois gargalos claros: custo por minuto e tempo de execução. Uma campanha com três variações de vídeo exigia locação, elenco, equipamento, edição e aprovação. Com modelos generativos, o gargalo se desloca: em vez de filmar mais, você descreve melhor. Isso muda o perfil de quem produz. Pequenos negócios conseguem manter uma esteira diária de conteúdo; agências multiplicam testes criativos sem multiplicar diárias; criadores independentes competem em repertório visual, não em orçamento de set.
A consequência prática é que o diferencial competitivo saiu da câmera e foi para o processo: roteiro, padronização de prompts, biblioteca de assets e critérios de corte. Quem organiza esse processo produz mais e com menos retrabalho. Quem improvisa a cada peça gasta o mesmo tempo de um workflow estruturado e entrega resultados irregulares.
Também muda a matemática do teste. Plataformas verticais premiam volume com qualidade mínima: dez variações de um mesmo conceito ensinam mais sobre o público do que uma peça impecável. IA permite gerar essas dez variações em horas, desde que exista um sistema para não se perder no caminho. É por isso que bibliotecas de imagens geradas, pastas nomeadas por campanha e um documento de padrões visuais valem tanto quanto o modelo escolhido.
Há ainda um efeito menos comentado: a barreira de entrada caiu, mas a barreira de atenção subiu. Se qualquer pessoa consegue gerar um plano bonito, o que diferencia é a narrativa, o som e o encadeamento. Vídeos genéricos com estética de banco de imagens em movimento têm desempenho pior do que vídeos simples com ideia clara. A ferramenta resolve a produção, não a mensagem.
Text-to-Video ou Image-to-Video: como escolher o ponto de partida
A primeira decisão de qualquer projeto é o tipo de geração. Text-to-Video (T2V) parte de uma descrição textual e cria a cena do zero. Image-to-Video (I2V) parte de uma imagem existente e a anima, preservando composição, identidade visual e enquadramento. As duas abordagens não competem: elas resolvem problemas diferentes dentro do mesmo vídeo.
Quando o Text-to-Video é a escolha certa
Use T2V quando o objetivo é explorar. É a rota natural para cenas de ambiente, aberturas, transições, planos de produto em contexto, paisagens, metáforas visuais e qualquer ideia que ainda não tem referência visual. Também é a melhor opção quando você precisa de velocidade máxima: descrever uma cena e receber três variações em minutos é imbatível para testar direção de arte.
O ponto de atenção do T2V é o controle. Como o modelo interpreta tudo a partir do texto, pequenas mudanças de redação alteram enquadramento, luz e até a aparência do sujeito. Isso significa que T2V funciona melhor para planos isolados do que para sequências com continuidade. Se o vídeo exige o mesmo personagem em cinco cenas distintas, começar por T2V costuma gerar retrabalho.
Quando o Image-to-Video resolve o problema
I2V entra em cena quando a consistência importa mais do que a descoberta. Você gera ou seleciona uma imagem-chave, aprova essa imagem e só então anima. O resultado é previsível: o figurino não muda, o rosto se mantém, o cenário permanece coerente. Para séries de conteúdo, produtos com identidade visual rígida, avatares de marca e narração em primeira pessoa, essa é a rota principal.
O fluxo híbrido é o mais eficiente na prática: imagens-chave em geradores de imagem, animação em modelos de I2V, e T2V apenas para planos de apoio que não exigem continuidade. Isso reduz o número de gerações descartadas e economiza tempo de curadoria, que é a etapa mais subestimada do processo.
Critérios rápidos de decisão
- Precisa de continuidade de personagem? Vá de I2V.
- Precisa de variedade de cenários sem referência? Vá de T2V.
- Precisa de produto real com fidelidade? Fotografe, trate a imagem e use I2V.
- Precisa de abertura impactante e única? T2V com várias tentativas.
- Precisa de muitos planos por dia? Padronize um template de I2V e reaproveite.
O fluxo de trabalho completo, do briefing ao corte final
Um pipeline confiável tem cinco etapas. Pular qualquer uma delas transfere o problema para a frente e encarece o resultado.
Etapa 1: briefing, promessa e roteiro em blocos
Antes de abrir qualquer ferramenta, defina a promessa central do vídeo em uma frase. Depois quebre o roteiro em blocos de três a cinco segundos, cada um com uma função clara: gancho, contexto, demonstração, prova, chamada para ação. Esse esqueleto evita o erro mais comum da produção com IA, que é gerar planos bonitos sem saber onde eles encaixam.
Etapa 2: geração e seleção de imagens-chave
Para cada bloco, gere de três a seis variações de imagem. Aprove uma ou duas. Nomeie os arquivos com o padrão campanha_cena_versao para não se perder em pastas. Ao aprovar uma imagem, verifique três coisas: legibilidade no formato vertical, espaço para texto sobreposto e coerência de paleta com o restante do vídeo.
Etapa 3: animação e controle de movimento
Aqui entram os modelos de I2V. Descreva movimento de câmera (aproximação lenta, panorâmica lateral, tilt suave), movimento de sujeito (cabelo ao vento, passo à frente, olhar para a câmera) e atmosfera (névoa, partículas, luz de fim de tarde). Movimentos simples e curtos funcionam melhor do que descrições complexas. Planos de três a quatro segundos com deslocamento leve raramente apresentam artefatos.
Etapa 4: som, legenda e ritmo
Vídeo vertical vive de áudio. Escolha a trilha antes de finalizar os cortes, para que os cortes sigam a batida. Grave narração ou gere locução sintética e ajuste a velocidade para caber no tempo da cena. Legendas embutidas aumentam retenção, especialmente em consumo silencioso. Revise linha por linha: erros de transcrição automática matam credibilidade mais rápido do que uma imagem imperfeita.
Etapa 5: publicação e iteração
Publique em lotes de duas ou três variações do mesmo conceito, mudando apenas o gancho ou a chamada final. Registre desempenho de retenção nos três primeiros segundos, tempo médio assistido e taxa de salvamentos. Depois de alguns ciclos, você terá um mapa de quais estilos visuais e quais aberturas funcionam melhor para o seu público.
Como escrever prompts eficazes em português
A língua do prompt influencia o repertório visual do modelo. Descrever em português costuma produzir estética mais próxima do público local em cenários cotidianos, enquanto modelos treinados majoritariamente em inglês respondem melhor a termos técnicos de cinema. A saída prática é um prompt híbrido: estrutura em português, terminologia de câmera em inglês quando necessário.
Uma boa estrutura segue esta ordem:
- Sujeito e ação principal, com idade aparente, figurino e contexto.
- Ambiente, hora do dia e clima emocional.
- Câmera: plano, lente aproximada, movimento.
- Luz e paleta de cores.
- Formato e proporção, como vertical 9:16.
- Restrições: sem texto na tela, sem marcas, sem membros deformados.
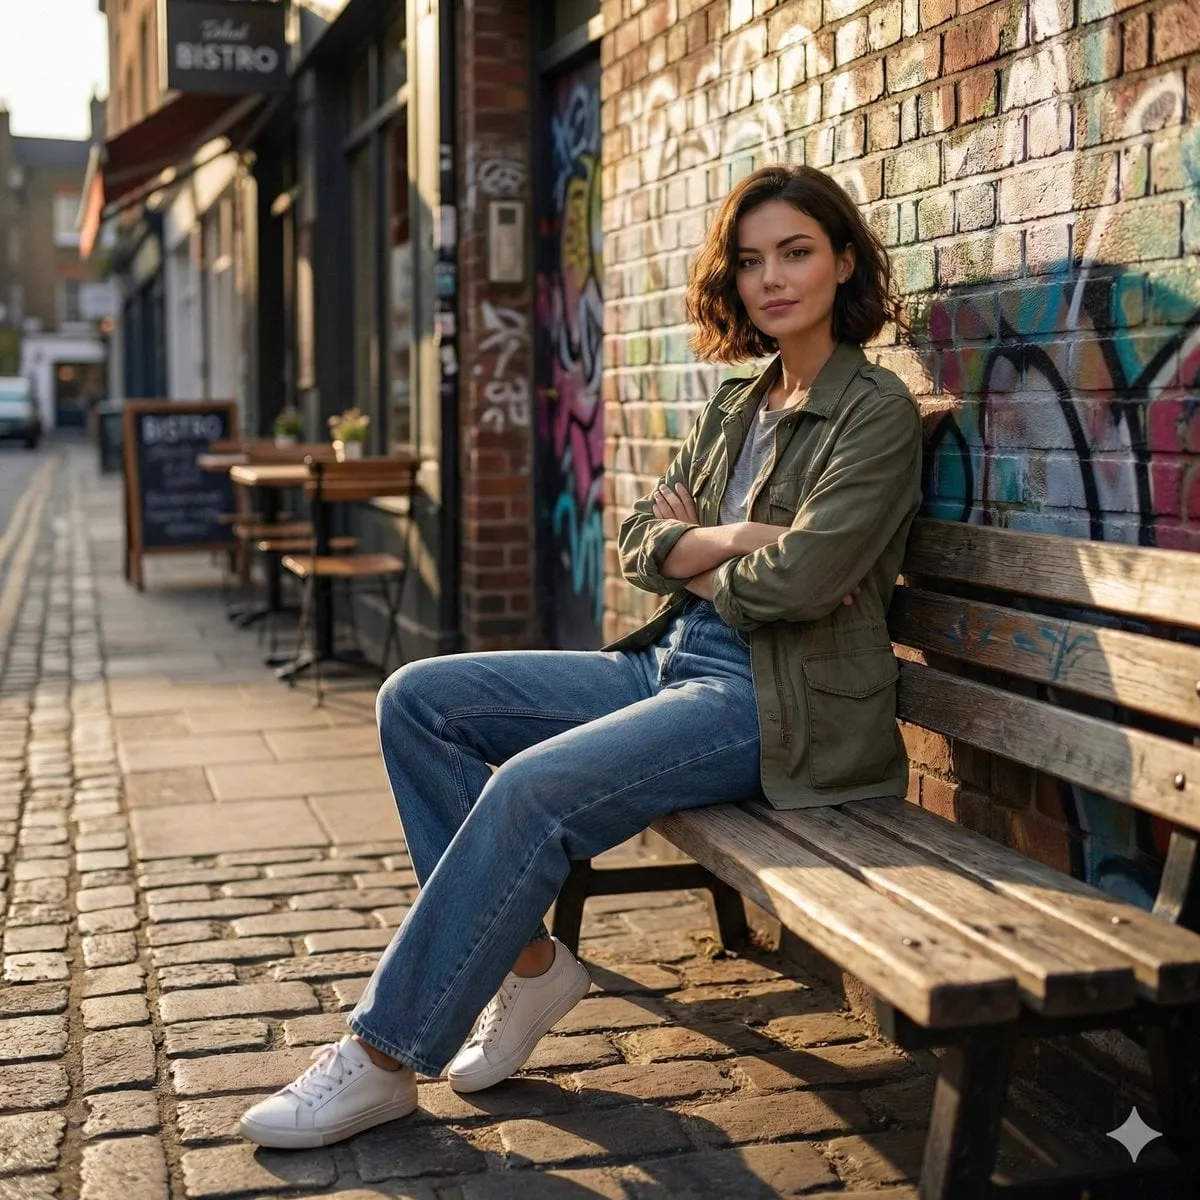
Exemplo de prompt de ambiente: "Mulher de cerca de 30 anos caminhando em feira de rua ao amanhecer, vestindo jaqueta jeans, plano médio, câmera na mão com leve movimento, luz dourada lateral, cores quentes e saturadas, vertical 9:16, sem texto na imagem".
Exemplo de prompt de produto: "Frasco de vidro sobre bancada de mármore, vapor sutil saindo, close lateral, macro, foco suave, fundo escuro com reflexo azul, movimento lento de aproximação, vertical 9:16".
Três hábitos que aumentam muito a taxa de acerto: mantenha um arquivo com prompts que funcionaram, evite três ou mais ações no mesmo plano, e nunca tente corrigir um plano ruim adicionando palavras. Gere de novo com uma descrição mais simples.
Consistência de personagem, figurino e cenário entre cenas
Consistência é a diferença entre um vídeo amador e uma série reconhecível. Existem quatro técnicas que resolvem a maior parte dos problemas.
A primeira é a imagem de referência fixa. Gere um retrato-base do personagem e use sempre o mesmo arquivo como ponto de partida em I2V. Isso trava traços faciais e formato de rosto.
A segunda é o bloco de identidade no prompt. Copie e cole a mesma descrição de personagem em todos os prompts da série: cor de cabelo, tipo físico, peça de roupa principal, acessório marcante. Consistência nasce de repetição, não de criatividade no texto.
A terceira é a paleta travada. Escolha três cores dominantes e descreva-as em todas as cenas. Isso cria unidade visual mesmo quando o cenário muda radicalmente.
A quarta é o enquadramento repetido. Se o vídeo tem cinco cenas do personagem falando, mantenha o mesmo tipo de plano e a mesma altura de câmera. Variedade de cenário com estabilidade de câmera lê como profissional; variedade de câmera com personagem instável lê como erro.
Quando o personagem precisa aparecer de corpo inteiro, gere primeiro o retrato e depois uma imagem de corpo inteiro usando o retrato como referência. Animando as duas imagens com os mesmos parâmetros de movimento, a transição entre planos fica natural.
Os primeiros três segundos: ritmo, formato e retenção
Nenhuma decisão técnica compensa um gancho fraco. O início do vídeo precisa responder mentalmente à pergunta "por que eu continuaria assistindo?". Três padrões funcionam bem com conteúdo gerado por IA.
O primeiro é o movimento imediato. Comece com a câmera já em deslocamento, não com um plano parado que lentamente ganha vida. Modelos de vídeo entregam mais impacto quando o primeiro frame já tem energia.
O segundo é a quebra de expectativa visual. Um cenário cotidiano com um detalhe impossível, ou um objeto comum em escala absurda, prende atenção sem precisar de explicação. A IA é especialmente boa nesse tipo de imagem improvável.
O terceiro é a tensão narrativa em uma linha. Uma frase curta na tela, seguida de corte seco para a demonstração, mantém o espectador até a solução. Evite introduções longas, logotipos animados no início e vinhetas.
Em termos de formato, vertical 9:16 é o padrão, mas deixe margens de segurança: cerca de 12% no topo e 20% na base, onde ficam legendas e botões da interface. Revise sempre no celular, não no monitor, porque contraste e legibilidade mudam bastante.
Erros comuns que reduzem alcance
Excesso de planos por vídeo é o erro mais frequente. Uma peça de 30 segundos com 15 cortes parece frenética e impede que o espectador processe qualquer imagem. Prefira cinco a sete planos bem escolhidos.
Uso de movimento de câmera em todos os planos é o segundo. Alterne planos com deslocamento e planos estáveis para criar respiração.
Descrições contraditórias no prompt geram resultados deformados. Pedir "close-up" e "plano aberto" na mesma instrução confunde o modelo. Divida em duas gerações.
Ignorar o áudio é um erro silencioso. Trilha mal cortada, locução dessincronizada e ausência de legendas derrubam a retenção mesmo quando a imagem é excelente.
Reaproveitar o mesmo plano em vídeos diferentes cansa o público. Se precisar economizar tempo, mude o enquadramento ou a paleta antes de reutilizar.
Por último, não publicar em lotes. Sem variações, você não aprende nada sobre o que funciona e acaba decidindo por intuição, que é justamente o que a produção com IA permite substituir por teste.
Ferramentas, custos e critérios de escolha
O ecossistema é amplo e muda rápido. Em vez de perseguir o modelo da semana, avalie por critérios estáveis.
- Controle de movimento: o modelo respeita instruções de câmera sem distorcer o sujeito?
- Consistência em I2V: os traços faciais se mantêm estáveis ao longo de três segundos?
- Duração útil: gera clipes longos o suficiente sem quebrar a continuidade no meio?
- Velocidade de fila: quanto tempo entre enviar o prompt e receber o resultado em horário de pico?
- Custo por minuto finalizado, considerando as tentativas descartadas, não apenas o preço da geração.
- Licenciamento e uso comercial: a política permite uso em anúncios e conteúdo pago?
Para imagem-base, geradores de imagem com controle de referência e ajuste fino de estilo resolvem a etapa de aprovação visual. Para animação, modelos focados em movimento de câmera e preservação de identidade tendem a ser mais confiáveis em planos curtos. Para áudio, ferramentas de locução sintética com controle de ênfase e pausa economizam muitas regravações.
Na edição, o essencial é timeline com boa gestão de legendas e exportação vertical sem perda. Softwares de edição profissionais ou aplicativos móveis conhecidos dão conta, desde que você padronize presets de exportação e mantenha um projeto-modelo com trilhas, estilos de legenda e posicionamento de marca já configurados.
Uma última observação sobre custos: o gasto real não é o preço por geração, é o número de tentativas até aprovar. Reduzir tentativas com prompts mais simples e imagens-chave bem feitas economiza mais do que trocar de ferramenta.
Perguntas frequentes
Preciso saber editar vídeo para produzir com IA?
Não é obrigatório, mas ajuda muito. O mínimo é saber cortar na batida, ajustar volume, inserir legendas e exportar no formato correto. Esse conjunto leva poucas horas para aprender e melhora o resultado mais do que qualquer troca de modelo.
Quantos vídeos por semana uma pessoa consegue produzir?
Com um pipeline pronto e biblioteca de imagens organizada, é realista produzir de três a cinco vídeos curtos por dia sozinho, incluindo edição e publicação. No começo, espere metade disso enquanto ajusta prompts e padrões.
Vale a pena usar IA para conteúdo de marca?
Vale, desde que a marca tenha diretrizes visuais claras. Sem paleta, tipografia e tom definidos, a produção com IA gera inconsistência. Com diretrizes, ela acelera a execução de ideias que já existem.
Como evitar que o vídeo pareça artificial?
Diminua a complexidade das cenas, use movimentos de câmera suaves, evite close-ups extremos de rostos por muito tempo e capriche no áudio. Som natural com trilha bem escolhida disfarça limitações visuais com eficiência.
Posso usar imagens reais como base?
Pode, e costuma dar ótimos resultados. Trate a imagem antes, ajuste contraste e recorte, e use I2V para animar. Verifique se você tem direito de uso sobre a imagem original.
O que fazer quando o modelo deforma mãos ou objetos?
Reenquadre: troque o plano por um mais aberto, esconda a região problemática com movimento ou recorte, ou aceite um plano mais curto. Tentar corrigir com texto raramente funciona.
Checklist final para publicar com confiança
Antes de soltar o vídeo, passe por esta lista rápida: promessa clara nos primeiros três segundos; cinco a sete planos; personagem consistente entre cenas; paleta de três cores; margens de segurança respeitadas; legendas revisadas; áudio nivelado sem picos; trilha cortada na batida; chamada para ação única; arquivo exportado no formato e no peso corretos.
Se todos os itens estiverem marcados, publique duas variações e observe o comportamento nos primeiros minutos, quando o algoritmo decide a distribuição inicial. Depois compare retenção e salvamentos, mantenha o que funcionou e descarte o que não gerou resposta. Com o tempo, você deixa de criar vídeos isolados e passa a operar um sistema de produção, que é exatamente o que torna a produção com IA sustentável no dia a dia.
