
Warum 2D-zu-3D kein Zaubertrick ist, sondern ein Pipeline-Problem
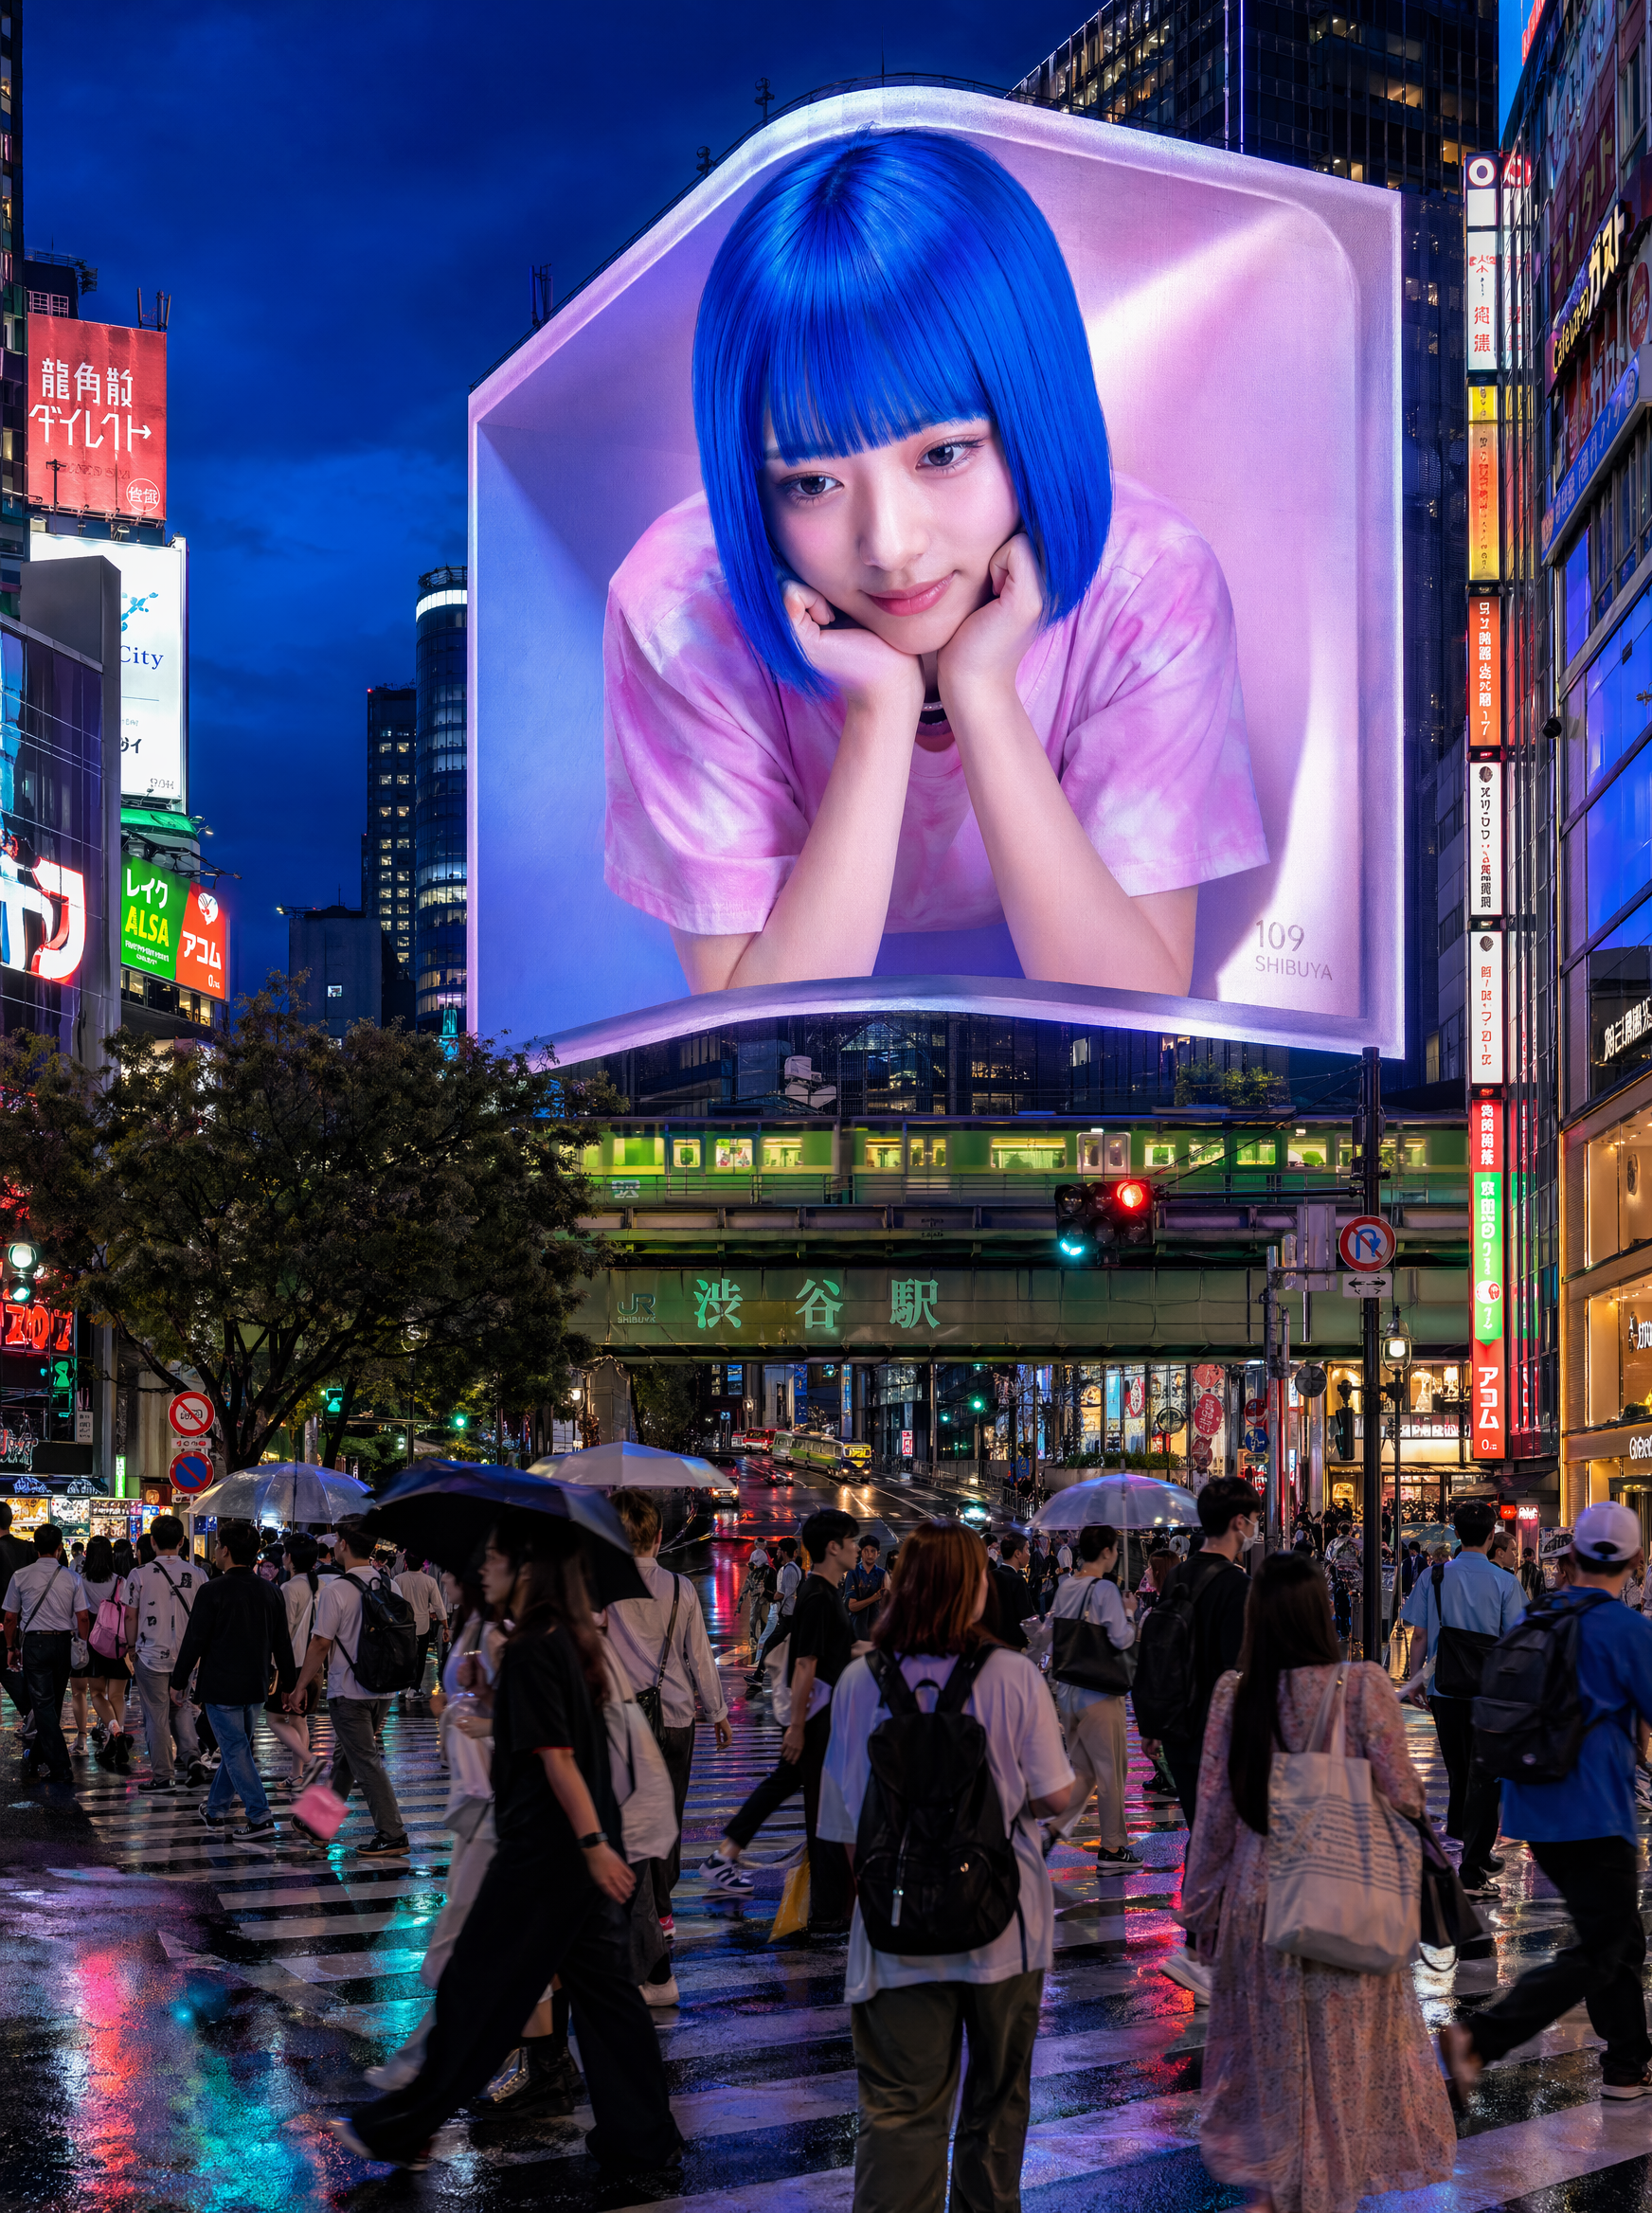
Die Vorstellung, man lade ein flaches Bild hoch und erhalte auf Knopfdruck ein räumlich wirkendes, fotorealistisches Video, hält sich hartnäckig. In der Praxis sieht die Sache anders aus: Was wir als „3D-Wirkung" wahrnehmen, ist kein einzelnes Modellmerkmal, sondern das Ergebnis mehrerer ineinandergreifender Arbeitsschritte. Tiefenschätzung, Kameraführung, Bewegungslogik, Lichtkonsistenz und Nachbearbeitung greifen zusammen. Fällt einer dieser Bausteine aus, wirkt das Ergebnis sofort flach, kippelig oder künstlich – selbst wenn die Texturqualität hoch ist.
Deshalb lohnt es sich, den Prozess nicht als Werkzeugfrage, sondern als Pipelinefrage zu denken. Wer versteht, welche Signale das Auge für Räumlichkeit benötigt, kann Fehler gezielt isolieren, statt wahllos an Reglern zu drehen. Die gute Nachricht: Moderne generierende Systeme liefern bereits sehr brauchbare Rohdaten für Tiefe, Bewegung und Beleuchtung. Die eigentliche Arbeit liegt darin, diese Signale zu führen, zu stabilisieren und über mehrere Einstellungen hinweg konsistent zu halten.
In diesem Leitfaden geht es darum, wie aus flachem Ausgangsmaterial räumlich überzeugende Clips entstehen – mit wiederholbaren Schritten, klaren Entscheidungskriterien und realistischen Erwartungen an das, was automatisiert werden kann und was nicht.
Die drei Signale, aus denen unser Gehirn Räumlichkeit liest
Bevor man Modelle auswählt, sollte man die Wahrnehmungsebene klären. Räumlichkeit ist eine Illusion, die auf wenigen, gut erforschten Hinweisen beruht. Wer diese Hinweise gezielt verstärkt, braucht keine echte 3D-Geometrie, um überzeugende Tiefe zu erzeugen.
Tiefenkarten, Kantenverläufe und Verdeckungen
Das offensichtlichste Signal ist die Abstufung von Vordergrund zu Hintergrund. Tiefenschätzer erzeugen aus einem Einzelbild eine Graustufenkarte, in der nahe Objekte hell und ferne dunkel erscheinen. Diese Karte ist die Grundlage für fast alles Weitere: Sie steuert, wie stark sich Bildebenen bei Kamerabewegung verschieben, wo Schärfe liegen soll und welche Bereiche beim Neuzeichnen geschützt werden müssen. Wichtig ist die Kantenqualität. Unsaubere Tiefenkanten an Haaren, Blattwerk oder Gitterstrukturen führen später zu ausfransenden Rändern („Halos"), die den 3D-Eindruck sofort zerstören.
Parallaxe richtig dosieren
Parallaxe bezeichnet die unterschiedlich starke Verschiebung von Bildebenen bei einer Kamerabewegung. Sie ist der stärkste 3D-Hinweis überhaupt – und gleichzeitig der am leichtesten überdrehte. Zu viel Parallaxe wirkt wie eine wackelige Pappkulisse, zu wenig lässt die Szene flach erscheinen. Als Faustregel gilt: Bei einer moderaten seitlichen Kamerafahrt sollten sich nahe Objekte etwa zwei- bis dreimal so stark bewegen wie mittlere Ebenen. Alles darüber wirkt cartoonhaft, alles darunter beliebig.
Schärfentiefe, Dunst und Lichtverlauf
Tiefenwirkung entsteht auch ohne Bewegung. Schärfentiefe sortiert Bildebenen hierarchisch: Ein scharfes Motiv vor unscharfem Hintergrund liest das Auge sofort als räumlich. Atmosphärischer Dunst reduziert Kontrast und Sättigung mit wachsender Entfernung – ein Effekt, den man in der Postproduktion billig simulieren kann und der Erstaunliches leistet. Und schließlich der Lichtverlauf: Objekte, die aus derselben Lichtrichtung beleuchtet werden, wirken kohärent. Sobald die generierte Beleuchtung zwischen den Frames springt, bricht die Illusion.
Der Werkzeugkasten: Welcher Baustein welche Aufgabe übernimmt
Eine funktionierende 2D-zu-3D-Pipeline besteht aus vier klar getrennten Rollen. Wer sie vermischt, verliert die Kontrolle über die Fehlersuche.
Tiefen- und Normalenschätzung
Hier entstehen die geometrischen Hilfsdaten. Neben Tiefenkarten sind Normalenkarten nützlich, weil sie Flächenorientierungen beschreiben und Relighting ermöglichen. Für bewegtes Material gibt es zwei Wege: entweder pro Frame schätzen und zeitlich glätten, oder ein Video-Tiefenmodell verwenden, das die zeitliche Kohärenz bereits berücksichtigt. Der zweite Weg kostet mehr Rechenzeit, spart aber deutlich Nacharbeit.
Bild-zu-Video und Text-zu-Video
Generierende Video-Modelle übernehmen die eigentliche Bewegungssynthese. Für 2D-zu-3D-Aufgaben ist die Bild-zu-Video-Fähigkeit entscheidend: Man gibt ein Standbild und eine Bewegungsbeschreibung vor und erhält einen Clip. Qualitätsunterschiede zeigen sich weniger in der Textur als in der Bewegungsstabilität – also darin, wie gut das Modell Objekte über die Zeit zusammenhält.
Kamera- und Bewegungskontrolle
Ohne Kameraplan wird die Bewegung dem Zufall überlassen. Steuerungssignale wie Kamerafahrt, Schwenk, Zoom, Dolly und Rollen sollten explizit gesetzt werden. Manche Systeme akzeptieren Tiefenkarten oder Pose-Sequenzen als zusätzliche Bedingung, was die Kontrolle erheblich verbessert. Für wiederkehrende Formate lohnt es sich, einen kleinen Katalog wiederverwendbarer Kamerabewegungen anzulegen.
Inpainting, Relighting und Upscaling
Nach dem ersten Durchlauf folgt die Reparatur- und Veredelungsschicht. Inpainting füllt Bereiche, die durch Kamerabewegung neu sichtbar werden. Relighting passt Beleuchtung an eine konsistente Richtung an. Upscaling und Deflicker glätten zeitliche Artefakte. Diese Schicht entscheidet oft stärker über den Gesamteindruck als die Wahl des Generators.
Ein belastbarer Workflow in sieben Schritten
Die folgende Reihenfolge hat sich bewährt, weil sie Fehler früh sichtbar macht. Wer direkt in hoher Auflösung rendert, verbrennt Zeit und erkennt Probleme erst spät.
Schritt 1: Referenzmaterial aufräumen
Entfernen Sie Kratzer, Sensorstaub, harte Kompressionsartefakte und störende Wasserzeichen. Bereinigen Sie außerdem die Tiefenstaffelung: Ein Bild mit vielen feinen, halbtransparenten Strukturen ist schwerer zu verarbeiten als eine klare Vorder-/Mittel-/Hintergrund-Aufteilung. Falls möglich, wählen Sie Ansichten mit erkennbaren Fluchtlinien – diese geben dem Modell geometrische Ankerpunkte.
Schritt 2: Tiefe und Normalen erzeugen
Erstellen Sie Tiefenkarten und prüfen Sie sie visuell, nicht nur numerisch. Achten Sie auf drei Dinge: keine harten Sprünge innerhalb zusammenhängender Objekte, saubere Kanten an Haaren und Laub, plausibler Verlauf am Horizont. Korrigieren Sie problematische Regionen mit einem einfachen Malwerkzeug nach – ein paar Minuten manuelle Nacharbeit sparen später Stunden.
Schritt 3: Szenengraph und Kameraplan festlegen
Skizzieren Sie schriftlich, welche Ebenen es gibt, wie sie sich bewegen sollen und welche Kamerabewegung die Szene trägt. Ein kurzer Plan mit drei bis fünf Sätzen genügt. Beispiel: „Langsame seitliche Fahrt nach rechts, Motiv bleibt zentriert, Hintergrund bewegt sich halb so schnell, Licht bleibt von links oben." Dieser Plan wird zur Prüfliste, wenn der erste Durchlauf nicht überzeugt.
Schritt 4: Erster Durchlauf in niedriger Auflösung
Rendern Sie bewusst klein und kurz – etwa vier Sekunden bei halber Zielauflösung. Bewerten Sie nur drei Dinge: Bewegungsstabilität, Parallaxeverhältnis, Lichtkonsistenz. Details wie Texturschärfe interessieren in dieser Phase nicht. Verwerfen Sie Durchläufe ohne Reue: Ein schlechter Ausgangspunkt wird durch Nachbearbeitung nie gut.
Schritt 5: Konsistenz über die Zeit sichern
Jetzt geht es um Stabilität. Prüfen Sie Objektidentität (bleibt das Gesicht dieselbe Person?), Materialverhalten (flattert Stoff unnatürlich?) und Hintergrunddetails (verschwinden Fenster oder Geländer?). Nützlich sind Referenzframes: Speichern Sie einen besonders gelungenen Frame als Anker und führen Sie ihn dem Modell erneut zu, wenn die Szene später im Clip zu driften beginnt.
Schritt 6: Upscale, Deflicker, Filmkorn
Erst jetzt in Zielauflösung rendern und anschließend veredeln. Ein leichter zeitlicher Deflicker glättet Helligkeitsschwankungen. Feines, gleichmäßiges Filmkorn überdeckt kleinere Unstimmigkeiten und lässt das Ergebnis weniger glatt erscheinen. Vermeiden Sie aggressive Schärfung: Sie hebt genau die Artefakte hervor, die Sie verbergen wollen.
Schritt 7: Ton und Schnitt
Räumlichkeit entsteht auch im Ton. Eine dezente Raumhall-Spur, die zur Entfernung der Objekte passt, verstärkt die Tiefenwirkung hörbar. Im Schnitt gilt: Räumliche Einstellungen brauchen etwas mehr Standzeit als flache, damit das Auge die Tiefe erfassen kann. Sehr kurze Schnitte zerstören den Effekt.
Konsistenz über mehrere Einstellungen hinweg
Ein einzelner gelungener Clip ist eine Demo, eine konsistente Sequenz ist ein Produkt. Der schwierigste Teil der 2D-zu-3D-Arbeit liegt deshalb zwischen den Einstellungen, nicht innerhalb einer.
Charakterkonsistenz
Legen Sie für jede Figur ein Referenzpaket an: eine frontale Ansicht, ein Dreiviertelprofil, eine Detailaufnahme des Gesichts und eine Ganzkörperaufnahme mit typischer Kleidung. Diese Pakete werden bei jeder neuen Einstellung mitgegeben. Für Kostümwechsel lohnt sich ein eigenes Paket pro Zustand, statt ein Modell mit Varianten zu überfordern.
Umgebungskonsistenz
Orte verhalten sich ähnlich. Erstellen Sie eine kleine Ortskarte mit festen Merkmalen: Lichtrichtung, dominante Farbtemperatur, Materialien, wiederkehrende Objekte. Wenn eine Szene am Fenster eines Raumes spielt, sollte die Lichtrichtung in keiner Einstellung wechseln. Solche Fehler fallen Zuschauern sofort auf, auch wenn sie sie nicht benennen können.
Übergänge bewusst planen
Schnittstellen sind Risikozonen. Ein harter Schnitt vom Weitwinkel ins Detail verzeiht kleine Abweichungen, ein durchgehender Schwenk nicht. Planen Sie Übergänge so, dass neue Informationen die Aufmerksamkeit binden: Bewegung im Bild, ein Geräusch, ein Perspektivwechsel.
Kameraarbeit, die Tiefe lesbar macht
Kamerabewegung ist das wirksamste Werkzeug für räumliche Wirkung – und dasjenige, das am häufigsten falsch eingesetzt wird. Die entscheidende Frage lautet nicht „welche Bewegung sieht spektakulär aus?", sondern „welche Bewegung macht die Tiefenstaffelung sichtbar?"
Langsame seitliche Fahrten sind ideal, weil sie Parallaxe über die gesamte Bildbreite aufbauen. Ein Dolly nach vorne auf ein Motiv zu erzeugt eine starke Annäherung, kann aber schnell unnatürlich wirken, wenn das Modell die Perspektive nicht konsistent hält. Schwenks sind riskant, weil sie den Hintergrund stark verzerren – hier hilft es, Tiefeninformationen explizit als Bedingung zu übergeben. Zooms sollten sparsam eingesetzt werden, da sie keine echte Parallaxe erzeugen und den 3D-Eindruck kaum stützen.
Wichtig ist außerdem die Ruhe. Zwischen zwei bewegten Einstellungen braucht es eine statische, in der das Auge die Szene verankern kann. Eine Sequenz aus durchgehend bewegten Aufnahmen ermüdet und lässt Fehler deutlicher hervortreten.
Modellwahl nach Aufgabe statt nach Popularität
Es gibt kein einzelnes bestes System, sondern unterschiedliche Stärken. Für die Auswahl helfen vier Fragen:
- Brauche ich Bewegungsstabilität oder Detailtreue? Modelle, die für lange, ruhige Einstellungen optimiert sind, halten Objekte besser zusammen; andere liefern schärfere Texturen, verlieren aber bei längerer Dauer die Konsistenz.
- Wie wichtig ist Steuerbarkeit? Wenn ich präzise Kamerabewegungen und Tiefenkarten vorgeben will, brauche ich ein System, das zusätzliche Bedingungen akzeptiert.
- Wie hoch ist das Tempo? Für Konzepttests zählt Geschwindigkeit, für finale Ausgaben Qualität. Viele Teams fahren daher zweigleisig: schnelle Iteration, langsames Finalrendering.
- Wie gut passt das Ausgabematerial in meine Postproduktion? Auflösung, Bildrate, Farbraum und Dateiformate entscheiden darüber, wie viel Nacharbeit nötig ist.
Sinnvoll ist ein Portfolio-Ansatz: zwei bis drei Systeme für unterschiedliche Aufgaben, kombiniert mit einer festen Nachbearbeitungskette. Wer bei jeder Aufgabe das Werkzeug wechselt, produziert uneinheitliche Ergebnisse.
Typische Fehler und Gegenmaßnahmen
Wabernde Ränder an Haaren und Laub. Ursache ist fast immer eine ungenaue Tiefenkarte. Gegenmaßnahme: Tiefenkarte manuell nachbessern, Kanten weichzeichnen, den betroffenen Bereich bei der Bewegung stärker fixieren.
Flackernde Helligkeit. Entsteht, wenn das Modell die Beleuchtung pro Frame neu interpretiert. Gegenmaßnahme: Referenzframe mitgeben, Lichtrichtung explizit beschreiben, zeitlichen Deflicker nachschalten.
Objekte verschwinden oder verschmelzen. Klassisches Zeichen für Überforderung durch zu viele bewegte Elemente. Gegenmaßnahme: Szene vereinfachen, unwichtige Details vorher entfernen.
Unnatürliche Gesichter im Profil. Profile sind für die meisten Systeme schwierig, weil die Tiefeninformation dort mehrdeutig ist. Gegenmaßnahme: Profilaufnahmen im Referenzpaket ergänzen oder Einstellungen so planen, dass Figuren überwiegend frontal oder im Dreiviertelprofil gezeigt werden.
Zu viel Parallaxe. Wirkt sofort wie eine Kulisse. Gegenmaßnahme: Bewegung reduzieren, Ebenenabstände verkleinern, Kamerageschwindigkeit senken.
Detailverlust beim Upscaling. Gegenmaßnahme: in kleineren Schritten hochskalieren, zwischen den Schritten leicht nachschärfen, niemals zweimal hintereinander stark komprimieren.
Drei Praxisbeispiele
Produktclip aus einem Standfoto. Ein einzelnes Katalogbild wird zur kurzen Kamerafahrt. Entscheidend sind hier saubere Tiefenkanten an den Produktkanten und eine ruhige Lichtsituation. Der Hintergrund bleibt absichtlich weich, damit die Bewegung nicht ablenkt. Ergebnis: ein fünfsekündiger Clip, der sich für Produktseiten und Social-Formate eignet.
Historische Fotografie als bewegtes Porträt. Alte Schwarz-Weiß-Aufnahmen benötigen zusätzliche Arbeitsschritte: Staubentfernung, Tonwertkorrektur und eine behutsame Kolorierung, bevor Bewegung sinnvoll ist. Wichtig ist Zurückhaltung – starke Kamerafahrten wirken bei historischem Material schnell unglaubwürdig. Kleine Bewegungen, etwa Atmen oder ein leichtes Kopfheben, entfalten hier mehr Wirkung.
Animierte Zwischensequenz aus Illustrationen. Bei gezeichnetem Ausgangsmaterial ist die Tiefenkarte häufig mehrdeutig, weil Farbflächen keine natürlichen Schattierungen besitzen. Hier hilft es, die Ebenen händisch zu trennen und als separate Elemente mit eigenen Bewegungsgeschwindigkeiten zu animieren. Der 3D-Eindruck entsteht dann aus dem Zusammenspiel der Ebenen, nicht aus einem Foto-Realismus-Anspruch.
FAQ
Brauche ich echte 3D-Modelle? In den meisten Fällen nein. Tiefenschätzung aus 2D-Material ist für mittlere Bewegungsumfänge ausreichend. Echte Geometrie lohnt sich, wenn sich Objekte stark verdrehen oder die Kamera große Winkel überstreicht.
Wie lang sollten generierte Einstellungen sein? Kurz genug, dass die Konsistenz hält: vier bis acht Sekunden sind ein guter Bereich. Längere Einstellungen lassen sich aus mehreren Durchläufen zusammensetzen.
Welche Auflösung sollte das Ausgangsbild haben? Mindestens das Zwei- bis Dreifache der Zielauflösung, sauber und ohne Kompressionsartefakte.
Was tun, wenn die Bewegung zu stark ist? Bewegung reduzieren, aber auch Zwischenframes einfügen. Oft liegt das Problem nicht in der Geschwindigkeit, sondern in der fehlenden zeitlichen Auflösung.
Wie viele Iterationen sind realistisch? Für einen fertigen Clip sind fünf bis fünfzehn Durchläufe normal. Wer weniger braucht, hat entweder ein sehr einfaches Motiv oder sehr viel Erfahrung.
Lässt sich das Ergebnis farblich an bestehendes Material anpassen? Ja, aber konservativ. Eine Farbanpassung über die gesamte Sequenz wirkt meist besser als Korrekturen pro Einstellung, weil das Auge sonst Farbwechsel als Fehler liest.
Räumliche Videogenerierung aus flachem Material ist heute zuverlässig machbar – nicht durch einen einzelnen Knopf, sondern durch eine disziplinierte Kette von Schritten. Wer Tiefensignale sauber vorbereitet, Bewegung plant statt zufällig erzeugt und Konsistenz aktiv prüft, erhält Ergebnisse, die nicht nach Effekt aussehen, sondern nach Kamerarbeit. Genau das ist der Maßstab.
