
Perché la generazione video AI è ormai una competenza di produzione
Fino a poco tempo fa generare un video con l'intelligenza artificiale significava accettare un compromesso: clip brevi, movimenti instabili, personaggi che cambiavano volto da un fotogramma all'altro. Oggi il problema non è più ottenere un video, ma ottenere un video che regga un montaggio, una narrazione e un formato di pubblicazione. La differenza tra un esperimento e un prodotto finito non sta nel modello scelto, ma nella pipeline che costruisci attorno a quel modello.
Questa guida affronta la generazione video AI come un problema di produzione: quali criteri usare per scegliere un motore di generazione, come combinare più strumenti nella stessa sequenza, come mantenere coerenti volti, costumi e illuminazione, e come organizzare il lavoro quando il progetto supera i trenta secondi. Non troverai una classifica definitiva, perché le classifiche cambiano ogni pochi mesi; troverai invece un metodo che resta valido anche quando i nomi dei modelli cambiano.
Il punto di partenza è una constatazione semplice: nessun modello singolo vince su tutto. Alcuni eccellono nel realismo fotografico, altri nella resa stilizzata, altri ancora nella velocità di iterazione. Chi lavora professionalmente smette presto di cercare "il migliore" e comincia a costruire un piccolo arsenale, con regole chiare su quando usare cosa.
Come funziona una pipeline di video AI oggi
Una pipeline matura si articola in quattro fasi distinte, ognuna con obiettivi e criteri di qualità diversi.
Dalla sceneggiatura all'immagine chiave
La prima fase produce i fotogrammi di riferimento. Puoi generare le immagini chiave con un modello text-to-image, oppure partire da fotografie reali, bozzetti o render 3D. Questa fase determina l'80% del risultato finale: se il fotogramma di partenza ha proporzioni sbagliate, luce piatta o un volto ambiguo, nessun modello video riuscirà a salvarlo. Vale la pena investire tempo qui, generando dieci o quindici varianti della stessa inquadratura e scegliendo la migliore con occhio critico.
Dall'immagine alla clip
La seconda fase trasforma le immagini in movimento. Qui entrano in gioco i modelli image-to-video, che interpretano il fotogramma come primo frame e generano i successivi in base a un prompt di movimento. La qualità del movimento dipende da tre fattori: la descrizione del movimento (velocità, direzione, tipo di camera), la coerenza tra immagine e prompt, e la durata richiesta. Clip da tre a sei secondi sono quasi sempre più pulite di clip da quindici.
Dal movimento al montaggio
La terza fase è il montaggio. Le clip generate raramente si incastrano da sole: hanno velocità diverse, temperature colore leggermente diverse, micro-variazioni nel volto del soggetto. Serve un passaggio in un editor non lineare dove allineare, tagliare, stabilizzare e correggere.
Dalla timeline alla consegna
La quarta fase comprende audio, sottotitoli, color grading finale ed export nei formati richiesti dalle piattaforme. È la fase che molti saltano, ed è quella che distingue un video amatoriale da uno professionale.
Scegliere il modello giusto: criteri pratici
Invece di inseguire ogni nuovo rilascio, valuta i modelli su cinque assi misurabili.
Realismo e resa stilistica
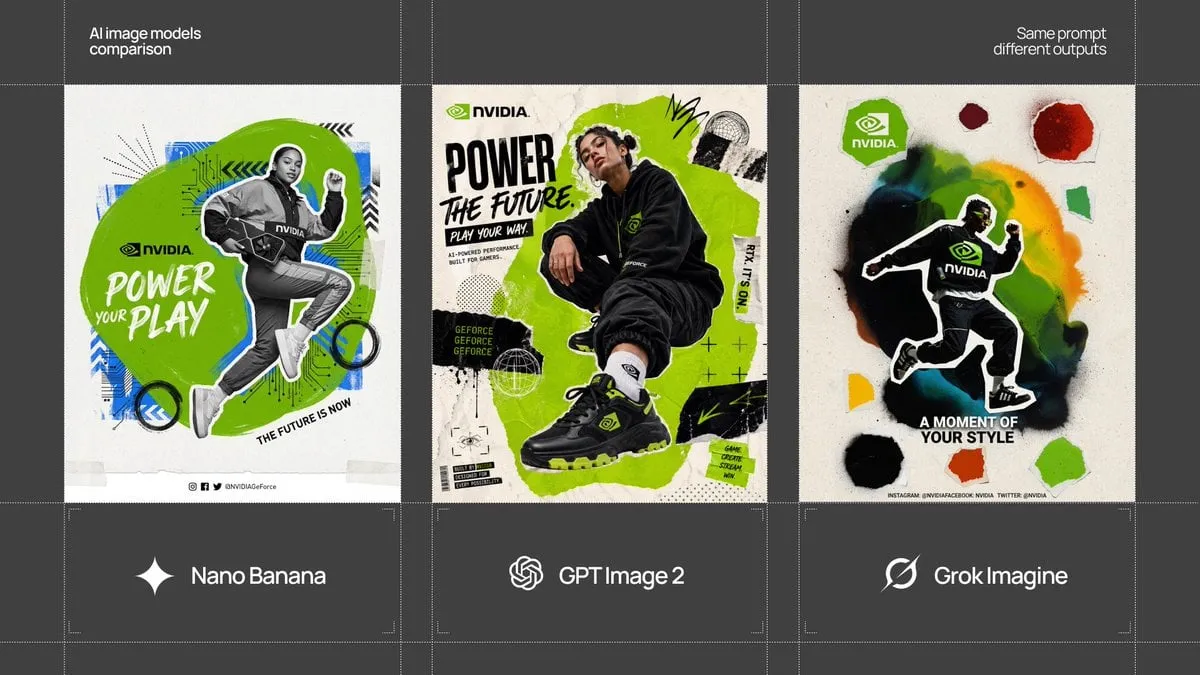
Se il tuo progetto richiede pelle credibile, capelli che si muovono in modo naturale e micro-espressioni, avrai bisogno di un modello con un buon addestramento su materiale live-action. Se invece cerchi un'estetica illustrata, anime o 3D stilizzato, un modello specializzato ti darà risultati migliori con meno tentativi. Prova sempre lo stesso prompt su due o tre motori diversi prima di decidere: la differenza è spesso più evidente nei dettagli che nell'insieme.
Controllo della camera e del movimento
Alcuni modelli accettano istruzioni di regia esplicite, come dolly in, pan laterale, orbita attorno al soggetto, zoom lento. Altri si limitano a un movimento generico. Se il tuo video necessita di continuità di sguardo tra due inquadrature, questa capacità vale più di dieci punti percentuali di realismo in più.
Coerenza del personaggio
È il criterio più sottovalutato. Un modello può produrre una clip splendida e una seconda clip in cui il protagonista ha un naso diverso. Prima di impegnarti su un progetto lungo, fai un test di coerenza: genera cinque clip dello stesso personaggio in cinque situazioni diverse e guardale di fila. Se il volto cambia in modo percepibile, sappi che dovrai compensare in post-produzione.
Velocità e costo per iterazione
Un modello lento ma preciso è utile per gli shot finali; un modello veloce è utile per esplorare. La strategia più efficiente è ibrida: usa un motore rapido per definire inquadrature e ritmo, poi rigenera solo gli shot chiave con un motore di qualità superiore. Questo riduce drasticamente il numero di tentativi costosi.
Controlli avanzati disponibili
Verifica se il modello supporta maschere di movimento, keyframe iniziale e finale, controllo della profondità, riferimenti multipli di personaggio. Questi strumenti fanno la differenza quando devi ripetere una scena identica in momenti diversi della timeline.
Tecniche di fusione immagine e video
La fusione è la competenza che separa chi produce clip isolate da chi produce sequenze.
Multi-image fusion
Il principio è semplice: invece di affidarti a un solo fotogramma di riferimento, fornisci al modello più immagini dello stesso soggetto da angolazioni differenti. Il modello ricostruisce una rappresentazione più stabile dell'identità, riducendo le derive tra una clip e l'altra. Funziona particolarmente bene con personaggi ricorrenti: prepara un piccolo set di riferimento con volto frontale, profilo, mezzo busto e figura intera, e riutilizzalo per ogni shot.
Compositing a blocchi
Quando una scena è troppo complessa per essere generata in un unico passaggio, scomponila in blocchi: sfondo, soggetto, elementi di primo piano, effetti atmosferici. Genera ogni blocco separatamente, poi assembla in compositing. È lo stesso approccio che si usa nelle produzioni 3D, applicato a materiale generato. Il vantaggio è il controllo: puoi correggere un solo elemento senza rigenerare l'intera scena.
Continuità cromatica tra le clip
Le clip generate tendono ad avere bilanciamenti del bianco leggermente diversi. Applica un LUT comune a tutta la sequenza oppure usa gli strumenti di corrispondenza colore dell'editor per allineare ogni clip a una scena di riferimento. Un dettaglio semplice come uniformare la temperatura colore elimina l'effetto "collage" che tradisce i video montati frettolosamente.
Inpainting e rimozione di artefatti
Quasi ogni clip contiene almeno un artefatto: una mano deformata, un oggetto che si dissolve, un testo illeggibile sullo sfondo. Invece di rigenerare l'intera clip, usa strumenti di inpainting su singoli fotogrammi o brevi porzioni, oppure risolvi in compositing con una patch di texture. Il tempo risparmiato è notevole.
Workflow operativo in otto passaggi
Ecco una sequenza collaudata, applicabile a un video narrativo da trenta a novanta secondi.
- Definisci lo script visivo. Scrivi una lista di inquadrature con durata, azione, dialogo e atmosfera. Anche dieci righe bastano: senza questo elenco, la generazione diventa casuale.
- Crea il set di riferimento del personaggio. Genera o seleziona quattro o cinque immagini coerenti del protagonista e salva i prompt che le hanno prodotte.
- Blocca lo stile globale. Scegli una palette, un tipo di illuminazione e un obiettivo virtuale, e ripetilo in ogni prompt. Aggiungi il riferimento stilistico come immagine quando il modello lo consente.
- Itera in bassa qualità. Genera tutte le inquadrature con un motore veloce, montale in ordine e guarda la sequenza senza audio. Qui scopri i problemi di ritmo.
- Rigenera gli shot critici. Solo le inquadrature che reggono la narrazione meritano una seconda passata con un modello superiore.
- Assembla e stabilizza. Monta, correggi la stabilizzazione, allinea i movimenti di camera tra inquadrature adiacenti.
- Aggiungi audio. Voce, ambiente, musica ed effetti. L'audio nasconde piccole imperfezioni visive e rende il montaggio più fluido.
- Rifinisci e consegna. Color grading, sottotitoli, esportazioni multiple per i formati verticale, quadrato e orizzontale.
Errori comuni e come evitarli
Prompt troppo lunghi e contraddittori. Un prompt con quindici aggettivi genera risultati incoerenti. Separa la descrizione dello stile dalla descrizione del movimento e mantieni ciascuna parte breve e concreta.
Ignorare le proporzioni native. Se generi in verticale e poi ritagli in orizzontale, perdi composizione. Genera direttamente nel formato finale, oppure progetta l'inquadratura con margini di sicurezza.
Usare un solo modello per tutto. Ogni motore ha un punto di forza. Alternare non è un tradimento, è mestiere.
Sottovalutare la post-produzione. Il video generato è materiale grezzo. Chi non monta, non color corregge e non gestisce l'audio otterrà sempre un risultato inferiore rispetto a chi dedica il trenta per cento del tempo alla rifinitura.
Non documentare i prompt. Senza un archivio dei prompt e delle impostazioni, non potrai replicare una scena riuscita né correggere una scena sbagliata. Tieni un foglio di calcolo con inquadratura, modello, prompt, seed e note.
Generare clip troppo lunghe. Oltre i sei o sette secondi, la stabilità crolla. Meglio tre clip corte ben raccordate che una clip lunga piena di derive.
Ruoli e organizzazione del lavoro
Anche un piccolo team trae vantaggio da una divisione chiara dei compiti. Un concept artist produce immagini di riferimento e mantiene coerenza stilistica. Un prompt engineer traduce le inquadrature in istruzioni operative e gestisce le iterazioni. Un editor assembla, stabilizza e corregge. Un sound designer costruisce l'ambiente sonoro, che nel video generato ha un peso enorme sulla percezione di qualità. Se lavori da solo, assumi comunque questi quattro cappelli in momenti separati della giornata: mescolarli produce confusione e decisioni incoerenti.
Documenta ogni scena in una scheda con: numero di inquadratura, durata prevista, modello usato, prompt finale, seed, note sui difetti da correggere. È il singolo investimento organizzativo con il miglior rapporto tra sforzo e beneficio.
Adattare il risultato alle piattaforme
Un video che funziona in verticale non funziona automaticamente in orizzontale. Pianifica fin dall'inizio il formato principale e genera le inquadrature con spazio di respiro sui lati. Per il verticale privilegia piani medi e primi piani, che restano leggibili su schermi piccoli. Per l'orizzontale puoi permetterti campi lunghi e movimenti di camera più ampi.
La durata ideale dipende dal contesto: quindici secondi per un annuncio, trenta per un teaser narrativo, oltre un minuto per contenuti didattici in cui l'attenzione è guidata da una voce. Ricorda che la soglia di tolleranza verso le imperfezioni si abbassa quanto più il video è lungo: in quindici secondi lo spettatore perdona, in novanta no.
Infine, esporta sempre una versione con sottotitoli incorporati e una senza, e conserva i file di progetto con i livelli separati. Ti serviranno alla prima richiesta di modifica.
Domande frequenti
Serve una GPU potente per lavorare con il video AI? Non necessariamente. Molti modelli di generazione girano su servizi cloud, quindi il collo di bottiglia è la connessione e il budget di iterazioni, non l'hardware locale. Una GPU dedicata resta utile per l'inpainting, l'upscaling e il rendering in compositing.
Quante clip devo generare per ottenere una buona? Con un prompt ben costruito e un fotogramma di partenza pulito, una clip su tre è utilizzabile. Con prompt vaghi, il rapporto scende a una su dieci. Investi nella preparazione, non nel volume.
Posso usare immagini reali come punto di partenza? Sì, ed è spesso la strada più rapida verso il realismo. Assicurati di avere i diritti sulle immagini e di rispettare le condizioni d'uso dei modelli che impieghi.
Come mantengo lo stesso volto in scene diverse? Usa un set di riferimento con più angolazioni, ripeti la descrizione fisica del soggetto in ogni prompt, mantieni invariati tipo di luce e obiettivo virtuale, e correggi le piccole derive in post-produzione con strumenti di face swap o tracking.
Quanto tempo richiede un video da trenta secondi? Con una pipeline già impostata, da mezza giornata a due giorni, a seconda della complessità delle scene e del numero di iterazioni. La prima volta conta almeno il triplo, perché stai costruendo il metodo.
Meglio generare da testo o da immagine? Da immagine, quasi sempre, quando hai bisogno di controllo. Il text-to-video è utile per esplorare idee e generare b-roll astratto; l'image-to-video è lo standard per scene narrative con personaggi definiti.
Come gestisco i dialoghi? Genera il video senza audio, poi aggiungi la voce con un sintetizzatore vocale o una registrazione reale. Sincronizza il movimento labiale solo se necessario: nel montaggio serrato, un'inquadratura di reazione copre spesso meglio di un primo piano parlante.
Cosa faccio se il modello non capisce un movimento specifico? Scomponi il movimento in due clip più semplici e raccordale con un taglio o una transizione. In alternativa, ottieni il movimento desiderato con la camera virtuale in compositing invece di chiederlo al modello.
Checklist finale prima di pubblicare
- Coerenza del personaggio verificata guardando tutte le clip di fila senza interruzioni.
- Temperatura colore e contrasto uniformati su tutta la sequenza.
- Nessun artefatto visibile nei primi due secondi, dove l'attenzione è massima.
- Audio bilanciato: voce intelligibile, ambiente presente ma non invadente.
- Sottotitoli corretti e leggibili su schermo piccolo.
- Export nei formati richiesti, con nome file ordinato per versione.
- Prompt e impostazioni archiviati per future revisioni.
La generazione video AI premia chi costruisce sistemi, non chi accumula tentativi. Scegli pochi modelli, impara a fondo i loro limiti, documenta ogni scena e tratta il risultato generato come materiale grezzo da montare. Con questo approccio, la differenza tra un video che sembra una demo e un video che sembra prodotto da uno studio dipende da poche decisioni ripetute con disciplina.
