
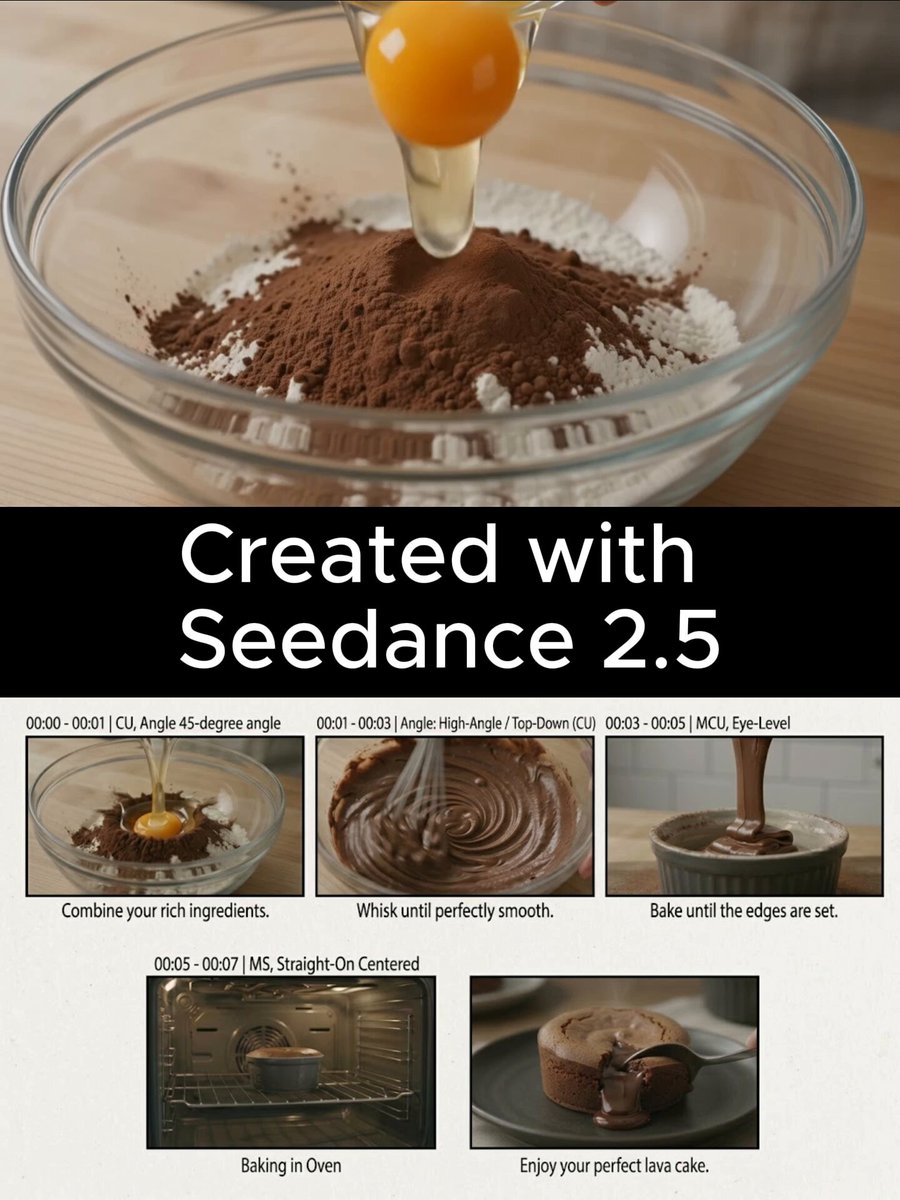
Perché il montaggio video assistito dall'AI non è più un esperimento
Fino a pochi anni fa il montaggio era una sequenza di decisioni manuali: guardare ore di girato, segnare i punti di taglio, allineare le tracce audio, correggere il colore, esportare. Ogni fase richiedeva software dedicato, tempo e soprattutto occhio. L'arrivo dei modelli generativi non ha eliminato queste competenze, ma ha spostato il baricentro del lavoro: oggi la parte più difficile non è premere i tasti giusti, è decidere cosa deve esistere sullo schermo e come deve essere coerente dall'inizio alla fine.
Un montaggio video assistito dall'intelligenza artificiale funziona quando tre condizioni si allineano. Primo: i modelli usati sono adatti al compito specifico, perché un modello ottimo per generare paesaggi non è necessariamente bravo a mantenere il volto di un personaggio tra due inquadrature. Secondo: esiste una pipeline chiara, con passaggi definiti, formati coerenti e nomi dei file comprensibili. Terzo: c'è un controllo umano nelle fasi di selezione, ritmo e sound design, che restano il vero terreno in cui un video si distingue da un altro.
Questo articolo descrive un workflow completo, dalla concept alla pubblicazione, con criteri di scelta tra i modelli, tecniche di coerenza visiva, gestione dell'audio, errori ricorrenti e una checklist finale. L'obiettivo non è automatizzare tutto, ma eliminare le parti ripetitive per dedicare più tempo alle decisioni creative.
Come scegliere i modelli giusti per ogni fase del lavoro
Non esiste un modello unico che risolva l'intera post-produzione. La scelta migliore è ragionare per compiti e assegnare a ciascuno lo strumento più adatto, accettando di alternare più piattaforme nello stesso progetto.
Generazione da testo (text-to-video)
È la fase in cui si produce materiale nuovo partendo da una descrizione. I modelli text-to-video differiscono soprattutto per la resa del movimento: alcuni eccellono in movimenti di camera fluidi, altri in azioni fisiche complesse, altri ancora nella resa dei dettagli ravvicinati. Per un montaggio che funzioni, conviene generare clip brevi (3-8 secondi) e pensare ogni prompt come a un piano sequenza autonomo, con soggetto, azione, ambiente, luce e ottica dichiarati in modo esplicito.
Un errore comune è chiedere a un singolo prompt di raccontare una scena intera. Il risultato è confuso e inutilizzabile in montaggio, perché manca un punto di taglio naturale. Meglio generare più clip brevi e costruire il ritmo in fase di selezione.
Da immagine a video (image-to-video)
Quando esiste già un riferimento visivo — una foto, un'illustrazione, un frame approvato dal cliente — usare un modello image-to-video è la scelta più efficiente. Il modello conserva composizione e palette, e il montatore ottiene continuità tra le inquadrature senza doverla negoziare a parole. Questa tecnica è particolarmente preziosa nei video prodotto, dove il packshot deve restare identico in ogni scena.
Upscaling e restauro
Materiale girato con smartphone, vecchi archivi, clip generate a risoluzione contenuta: tutti questi casi richiedono un passaggio di upscaling. I modelli moderni non si limitano a ingrandire, ma ricostruiscono texture, riducono il rumore e stabilizzano il dettaglio. Attenzione però agli eccessi: un upscaling troppo aggressivo produce un aspetto "plastificato" che tradisce subito l'origine sintetica.
Sincronizzazione labiale e voce
Per interviste finte, avatar, traduzioni multilingua o correzioni di battute, i modelli di lip-sync e clonazione vocale permettono di cambiare le parole senza rigirare. Il criterio di scelta qui è la tolleranza all'errore: nei primi piani il minimo disallineamento è visibile, quindi conviene testare sempre su un frammento di due secondi prima di applicare il modello all'intero dialogo.
Controllo del movimento e della camera
Esistono modelli specializzati nell'imporre una traiettoria di camera — panoramica, dolly, orbita, zoom lento — a una clip esistente. Sono strumenti potenti quando servono transizioni coerenti tra scene, ma vanno usati con misura: due movimenti di camera diversi nella stessa sequenza spezzano la sensazione di continuità.
Il regista automatico: composizione, ritmo e struttura narrativa
Alcuni sistemi di montaggio assistito non si limitano a generare o tagliare clip: propongono una struttura. Analizzano il materiale, riconoscono i momenti salienti, suggeriscono un ordine e costruiscono una scaletta. È un aiuto concreto, soprattutto quando si parte da molto girato o da decine di clip generate senza una gerarchia.
Il punto da capire è che una scaletta automatica è un punto di partenza, non un risultato. Il suggerimento va letto come una prima bozza: spesso il ritmo proposto è troppo uniforme, perché il modello tende a distribuire le clip in modo equilibrato mentre la narrazione ha bisogno di accelerazioni e pause.
Tre strutture che funzionano quasi sempre
- Gancio, sviluppo, chiusura: nei primi cinque secondi si mostra il momento più forte, poi si spiega, infine si chiude con una call to action. Ideale per contenuti verticali brevi.
- Problema, tentativo, soluzione: funziona bene nei tutorial e nelle demo di prodotto, perché crea attesa prima di mostrare il risultato.
- Cronologia visiva: sequenza di immagini legate da un tema, tenute insieme da musica e voce fuori campo. Perfetta per contenuti di brand e montaggi emozionali.
Il ritmo si costruisce con le durate, non con gli effetti
Un montaggio sembra professionale quando la durata delle inquadrature segue un'intenzione. Alternare clip da quattro secondi e clip da mezzo secondo crea tensione; mantenere lo stesso valore per trenta secondi crea noia, indipendentemente dalla qualità delle immagini. Prima di rifinire gli effetti, lavorate sulle durate: è il singolo intervento con il maggiore impatto percepito.
Coerenza visiva: il vero collo di bottiglia
La maggior parte dei progetti AI fallisce sulla coerenza. Singolarmente le clip sono belle, ma messe in sequenza sembrano appartenere a video diversi. Il problema nasce da tre variabili: personaggi, stile e luce.
Personaggi e oggetti ricorrenti
Se lo stesso volto o lo stesso prodotto deve comparire in più scene, serve un riferimento condiviso. Le tecniche più affidabili sono tre: partire sempre da un'immagine base approvata e usare image-to-video; descrivere il personaggio con un blocco di testo identico in ogni prompt, senza sinonimi; combinare più immagini di riferimento quando il modello lo consente, così da vincolare sia il volto sia l'abbigliamento.
Un trucco pratico: create un documento con il "blocco identità" del personaggio — età, capelli, corporatura, vestiti, colore dominante, tipo di ottica usata — e incollatelo senza modifiche in ogni generazione. Sembra banale, ma riduce drasticamente le variazioni indesiderate.
Stile e palette
La coerenza stilistica dipende più dalla palette che dal filtro finale. Scegliete tre colori dominanti e verificate che ogni clip li contenga, anche solo come luce ambientale o oggetto di scena. Un passaggio di color grading uniforme a fine montaggio non salva immagini che partono da temperature cromatiche opposte.
Luce e direzione della sorgente
Una sequenza convincente mantiene la stessa direzione della luce principale. Se nella prima inquadratura il sole è a sinistra, nella successiva deve restare a sinistra. Quando generate da testo, dichiarate sempre la direzione della luce: "luce laterale da sinistra, ora dorata, ombre morbide". È uno dei dettagli che fa la differenza tra un montaggio amatoriale e uno curato.
Workflow operativo in otto passaggi
Ecco una pipeline testata, pensata per progetti da uno a dieci minuti.
Preparazione. Scrivete una scaletta con durata target per ogni scena e un elenco di inquadrature necessarie. Definite formato, risoluzione, frame rate e proporzioni prima di generare: cambiare queste impostazioni a metà progetto crea incompatibilità difficili da correggere.
Generazione. Producete da tre a cinque varianti per ogni inquadratura. Non giudicate durante la generazione: raccogliete materiale e valutate dopo, quando avete il quadro completo.
Selezione. Scegliete la variante migliore per ogni scena usando tre criteri in ordine: leggibilità dell'azione, coerenza con le clip adiacenti, qualità tecnica. Se una clip è perfetta ma stona con il resto, scartatela.
Primo assemblaggio. Montate senza musica e senza effetti, solo immagini e durate. Se la sequenza funziona qui, funzionerà ancora meglio con l'audio.
Rifinitura del ritmo. Accorciate ogni clip di qualche decimo di secondo e verificate se il montaggio guadagna energia. Spesso sì.
Audio. Aggiungete voce, musica e ambiente. L'audio è il 50% della percezione di qualità e la fase in cui i progetti AI si distinguono di più.
Color e upscaling. Uniformate palette e contrasto, poi applicate l'upscaling come ultimo passaggio tecnico, non prima.
Export e verifica. Esportate in due versioni, una per il canale principale e una master ad alta qualità da conservare.
Audio, sottotitoli e accessibilità
Il suono è la parte più sottovalutata del montaggio assistito. Una scena generata con un audio pulito e coerente sembra più costosa di quanto sia.
Tre livelli da gestire separatamente: la voce, la musica, gli ambienti. La voce va normalizzata e tenuta costante; la musica va abbassata di diversi decibel sotto la voce nelle parti parlate, con tagli netti nelle pause; gli ambienti — vento, città, stanza — vanno aggiunti anche quando sembrano inutili, perché riempiono il vuoto e mascherano i difetti di sintesi.
I sottotitoli non sono solo accessibilità: nella maggior parte delle piattaforme social aumentano il tempo di visione. Generateli automaticamente, poi correggete a mano nomi propri, termini tecnici e punteggiatura. Un sottotitolo con un errore evidente danneggia la credibilità più di un'inquadratura imperfetta.
Aggiungete anche una traccia di descrizione testuale se il contenuto verrà distribuito su piattaforme che la supportano, e verificate il contrasto dei testi sovrapposti: il bianco puro su sfondo chiaro scompare, meglio usare una leggera ombra o un pannello semitrasparente.
Errori frequenti e come evitarli
Clip troppo lunghe. Una scena di dieci secondi generata da un solo prompt contiene quasi sempre un momento di deriva. Tagliate prima della deriva.
Prompt sovraccarichi. Aggiungere dettagli non migliora il risultato oltre un certo punto: diluisce il soggetto principale. Meglio un prompt chiaro con un'azione e un ambiente che un paragrafo di aggettivi.
Movimenti di camera contraddittori. Un dolly in avanti seguito da uno zoom indietro nella scena successiva crea un salto percettivo. Mantenete una direzione del movimento per blocco narrativo.
Cambiare modello a metà progetto. Ogni modello ha un aspetto riconoscibile. Alternarne due nello stesso blocco di scene produce discontinuità difficile da mascherare. Se dovete cambiare, fatelo tra un capitolo e l'altro.
Ignorare il suono fino alla fine. Montare con la musica fin dall'inizio è più lento ma produce risultati migliori, perché il ritmo visivo nasce insieme a quello sonoro.
Esportare una sola versione. Servono almeno un master ad alta qualità e una versione ottimizzata per il canale di destinazione, con proporzioni e durata adeguate.
Ottimizzare tempi, risorse e revisioni
Un workflow AI efficiente non si misura sul numero di generazioni, ma sul rapporto tra materiale prodotto e materiale usato. Se generate cinquanta clip e ne usate tre, il problema è a monte: nella scaletta.
Tre abitudini che riducono sensibilmente i tempi:
- Blocchi tematici. Generate tutte le scene dello stesso ambiente consecutivamente, così da riutilizzare lo stesso riferimento visivo e ridurre le variazioni.
- Versioning semplice. Nominate i file con schema chiaro: progetto, scena, variante, data. Un archivio ordinato vale più di qualsiasi automazione.
- Revisioni raggruppate. Raccolte le note, applicatele tutte insieme. Le revisioni frammentate costano il doppio perché richiedono di ricaricare il contesto ogni volta.
Sul piano delle risorse, tenete presente che l'upscaling e il rendering finale sono le fasi più pesanti. Pianificatele in fondo alla giornata o in batch, quando non dovete interagire con il progetto.
Checklist prima della pubblicazione
- La sequenza funziona senza audio e senza effetti?
- La direzione della luce è coerente tra scene adiacenti?
- I personaggi ricorrenti sono riconoscibili in ogni inquadratura?
- La palette resta entro tre colori dominanti?
- La voce è normalizzata e la musica non copre le parole?
- I sottotitoli sono corretti, leggibili e sincronizzati?
- Ci sono ambienti sonori nelle scene silenziose?
- Il primo secondo cattura l'attenzione senza spiegazioni?
- Il formato e la durata corrispondono al canale di destinazione?
- Esiste un master ad alta qualità archiviato?
FAQ
Serve esperienza di montaggio per lavorare con l'AI?
Aiuta molto, ma non è obbligatoria. Le competenze che contano davvero sono la scrittura di una scaletta solida e la capacità di valutare il ritmo. Entrambe si acquisiscono con la pratica, analizzando video che funzionano.
Quante clip bisogna generare per un minuto di video?
Con clip da tre-cinque secondi, un minuto richiede dalle dodici alle venti inquadrature. Generando tre varianti per inquadratura, il totale si aggira tra trenta e sessanta clip. È un intervallo realistico, non una regola fissa: dipende molto dalla densità del montaggio desiderata.
Qual è la fase in cui si perde più tempo?
La selezione e la coerenza visiva. La generazione è ormai veloce; scegliere tra varianti simili e mantenere continuità tra scene è ciò che assorbe la maggior parte delle ore.
Meglio generare a risoluzione alta o fare upscaling dopo?
Per progetti lunghi conviene generare a risoluzione media e fare upscaling solo sulle clip selezionate. Così si risparmiano risorse e si evita di trattare materiale che verrà scartato.
Come si mantiene lo stesso volto tra scene diverse?
Partendo da un'immagine di riferimento approvata, riutilizzando lo stesso blocco descrittivo senza variazioni e, quando possibile, sfruttando le funzioni di riferimento multiplo offerte dal modello.
L'audio generato è utilizzabile in un progetto professionale?
Per musiche di sottofondo e ambienti sì, con una revisione attenta dei volumi. Per la voce, la qualità è migliorata molto ma richiede comunque un controllo di pronuncia su nomi propri e termini tecnici.
Quanto dura in media un progetto breve?
Un video verticale da trenta secondi, ben fatto, richiede tipicamente dalle quattro alle otto ore tra concept, generazione, selezione, montaggio e rifinitura. I primi progetti richiedono più tempo; con una pipeline consolidata i tempi si dimezzano.
Conclusione operativa
Il montaggio video assistito dall'intelligenza artificiale non sostituisce il montatore: sposta il suo lavoro dal premere pulsanti al prendere decisioni. I modelli risolvono la generazione, l'upscaling, la sincronizzazione e parte dell'analisi, ma restano fuori dalla portata dell'automazione il ritmo, il tono, la scelta di cosa mostrare e cosa nascondere.
Se state iniziando, costruite prima la scaletta, poi la pipeline, e solo alla fine esplorate nuovi modelli. Un workflow semplice applicato con disciplina batte quasi sempre un insieme di strumenti all'avanguardia usati senza metodo. E quando un progetto funziona, annotate cosa avete fatto: la pipeline che si ripete è il vero vantaggio competitivo.
