
プロンプトは呪文ではなく設計図である
画像生成AIに同じ言葉を投げたのに、人によって出力がまったく違う。そういう光景はもう珍しくありません。理由は単純で、プロンプトは「魔法の呪文」ではなく「設計図」だからです。設計図には、何を作るのか、どんな寸法か、どの素材を使うのか、どこから光が当たるのかという情報が段階的に書かれています。プロンプトも同じで、主題・構図・光・質感・スタイルを順序立てて記述すると、モデルは意図をはるかに正確に再現します。
逆に言えば、単語を思いつくまま並べただけのプロンプトは、モデルにとって「なんとなくこういう雰囲気」という曖昧な依頼でしかありません。曖昧な依頼からは曖昧な結果しか返ってきません。生成の品質を左右しているのは、モデルの性能差以上にプロンプトの構造であることが多いのです。
この記事では、画像生成AIから安定して高品質な結果を引き出すための考え方と手順を、実務でそのまま使える形で整理します。単発のコツの寄せ集めではなく、モデル選択からプロンプトの組み立て、再現性の管理、複数カットへの展開、そして失敗したときの修正判断までを一つの流れとして扱います。読み終えたときには、自分の手元で検証を回せる自分用のプロンプト設計手順ができている状態を目指します。
画像生成AIの仕組みとプロンプトの関係を理解する
モデルごとに得意な絵が違う
最初に理解しておくべきは、すべてのモデルが同じテキストを同じ意味で解釈するわけではないという事実です。学習データの傾向によって、写実的な写真表現が得意なモデル、イラストやアニメ調に強いモデル、特定の画角やライティングを好むモデルがあります。
たとえば人物のポートレートを写真のように仕上げたいなら、リアル指向のモデルを選び、肌の質感やレンズの描写に関する語彙を厚めに入れます。一方でキャラクターの三面図やゲーム向けのコンセプトアートを作るなら、線の処理や色のフラットさを得意とするモデルのほうが手戻りが少なくなります。
重要なのは、うまくいかないときにプロンプトだけを疑わないことです。モデルの適性とプロンプトの内容は切り分けて考える必要があります。同じプロンプトを2つのモデルに投げて比較する習慣をつけると、どの語彙がどのモデルに効くのかが短期間で見えてきます。
テキストはどうやって画像になるのか
拡散モデルは、ノイズから画像を徐々に復元していく過程で、テキストの埋め込みを手がかりに方向を決めています。このとき、プロンプト内の単語はすべて同じ重みで扱われるわけではありません。先頭に近い語、珍しい語、具体的な固有名詞は比較的強く効き、ありふれた形容詞は埋もれやすいという傾向があります。
そのため、もっとも伝えたい要素はプロンプトの前半に置き、修飾や雰囲気づくりの語は後半に回すのが基本になります。また、抽象語より具体語のほうが効きます。「美しい」「すごい」といった評価語は情報量がほとんどなく、「夕暮れの逆光」「雨上がりの濡れた路面」「85mm相当の望遠レンズ」といった観察可能な記述のほうがモデルにとっては明確な指示になります。
指示の粒度を揃える
プロンプトが破綻する典型パターンのひとつが、粒度の不一致です。「猫、王冠、超リアル、8K、ファンタジー、悲しげ、縦構図、油絵風」のように、ジャンル・品質・感情・技法が同列に並ぶと、モデルはどれを優先すべきか判断できません。結果として、要素が中途半端に混ざった画像が出てきます。
粒度を揃えるコツは、要素を階層に分けることです。主題の階層、環境の階層、視覚技法の階層、品質指定の階層という4段階に分け、それぞれの中で矛盾しないように言葉を選びます。油絵風を選んだなら、レンズや被写界深度の指定は思い切って削る。写真表現を選んだなら、線画やセルシェーディングの語彙は入れない。この整理だけで失敗率はかなり下がります。
基本の型:5要素でプロンプトを組み立てる
主題・動作・環境・スタイル・品質
実務で使いやすいのは、次の5要素を順番に埋めていく型です。
- 主題(Subject): 誰が、何が。人数、年齢層、服装、持ち物まで具体的に。
- 動作(Action): 何をしているか。静止か動作か。視線の向きや手の位置まで書くと安定します。
- 環境(Environment): 場所、時間帯、天候、背景の要素。屋内か屋外か。
- スタイル(Style): 写真、イラスト、3Dレンダー、フィルム風など。参照したい画風の方向性。
- 品質指定(Quality Modifiers): 解像度感、ディテールの密度、仕上がりの傾向。
この順番には意味があります。前半ほど強い影響力を持ち、後半は全体を整える役割を担います。慣れないうちは、5要素をそれぞれ1行で書き出してから連結すると、何が足りないかに気づきやすくなります。
具体例で見るビフォーアフター
弱い例: 「かっこいい戦士、ファンタジー、高画質」
改善例: 「30代の女性戦士が革の胸当てを身につけ、雨に濡れた石畳の城門前で右手に長剣を下げて立っている。背後に霧のかかった森、夜明け前の青い環境光と左手からの松明の暖色光。35mm相当のミディアムショット、浅い被写界深度、フィルムグレイン、写実的な質感」
後者のほうが長いですが、情報量が段違いです。どこに立っているのか、どの方向から光が来ているのか、カメラがどこにあるのかまで指定されています。生成結果のばらつきは確実に小さくなります。
語順と重みを意識する
同じ単語でも位置によって効き方が変わります。もっとも優先したい要素は前半に、補助的な要素は後半に。逆に、どうしても出てしまう不要な要素はネガティブ側に回すか、ポジティブ側から思い切って削除します。プロンプトは足し算だけでなく引き算が重要です。要素を増やせば増やすほど、モデルは一つひとつの指示を薄く解釈していきます。
ネガティブプロンプトの実践的な使い方
ネガティブプロンプトは、望まない要素を避けるための強力な手段です。ただし使い方を誤ると、画像全体が硬くなったり、逆に指定した要素がにじみ出てきたりします。
実務では、次の3カテゴリに分けて記述すると整理しやすくなります。
- 品質系: ぼやけ、ノイズ、低解像度、圧縮ノイズ、不自然な肌
- 構造系: 余分な指、崩れた手、多重の四肢、歪んだ遠近、切り取られた頭
- 内容系: 避けたいモチーフ、不要な文字、透かし、ロゴ
特に手や指の破綻は多くのモデルで起きやすいため、構造系の指定を入れておく価値があります。ただし、ネガティブに大量の単語を詰め込むと、モデルが混乱して全体的に平板な絵になることがあります。多くても10項目程度に絞り、効果を検証しながら調整するのが現実的です。
再現性と一貫性を高めるテクニック
シード値の管理
同じ構図で色違いを出したい、表情だけ変えたいという場面では、シード値を固定するのが基本です。シードを固定したうえでプロンプトを1要素だけ変えると、変化の原因がその要素に絞り込めます。
ただしシードを固定しても完全に同じ画像は出ません。サンプラー、ステップ数、解像度、モデルのバージョンが変われば結果は変わります。再現性を確保するというのは完全な同一を意味するのではなく、変化を制御できる状態を意味すると考えると実践的です。
記録しておくべき項目は次のとおりです。
- モデル名とバージョン
- プロンプト全文とネガティブプロンプト全文
- シード値、ステップ数、サンプラー、CFGスケール
- 画像サイズとアスペクト比
- 生成日時
これらをテキストファイルや表計算に残しておくと、数週間後に同じテイストを再現したいときに大きな差が出ます。
重み付けで要素の強弱をつける
多くのツールには、単語の強調や抑制の構文があります。一般的な書き方は、強調したい語を括弧でくくる、数値で重みを指定する、といった形式です。書き方はツールごとに異なるため、必ずそのツールの記法を確認してください。
注意点は、重みを上げすぎると画像が破綻しやすいことです。極端な数値を入れると、色が飽和したり構図が崩れたりします。まずは控えめな値で試し、効果が足りなければ少しずつ上げる。この順序を守るだけで無駄な試行が減ります。
キャラクターの一貫性を保つ
同じ人物を複数のカットで登場させたい場合、プロンプトの文章だけでは限界があります。実務では次の手段を組み合わせます。
- 参照画像を使った条件付け。顔や服装の特徴を画像から引き継ぐ。
- 追加学習した軽量なモデルや埋め込みを併用する。
- 特徴を短文のタグセットとして固定し、毎回同じ順序で書く。
もっとも効果が大きいのは参照画像の併用です。文章は補助として使い、特徴の記述は「髪型、目の色、服装、体格」の4項目に絞って固定する。これを守ると、カット間の揺れが大幅に減ります。
ディテールを制御する:カメラ・ライティング・質感
カメラとアングルの語彙
写真表現を使うなら、カメラ用語は非常に効率のよい指示語です。よく使うものを整理しておきます。
- 焦点距離: 24mm相当(広角で歪みのあるダイナミックな構図)、50mm相当(自然な見え方)、85mm相当(人物の圧縮効果と背景のぼけ)、135mm相当(強い圧縮と背景分離)
- アングル: アイレベル、俯瞰、あおり、ローアングル、肩越し、真上からの俯瞰
- ショットサイズ: クローズアップ、バストショット、ミディアムショット、フルショット、ロングショット
- 被写界深度: 浅い(背景が大きくぼける)、深い(全景にピント)
これらは単独ではなく組み合わせて使います。「85mm相当、アイレベル、バストショット、浅い被写界深度」と指定すると、人物撮影らしい自然な仕上がりになります。
光を設計する
画質の印象を最も大きく左右するのは光です。項目として明示的に指定する価値があります。
- 方向: 順光、斜光、逆光、サイド光、トップ光、バウンス光
- 質: 硬い光(くっきりした影)、柔らかい光(拡散した影)、リムライト、輪郭のハイライト
- 色温度: 暖色のタングステン、寒色の青時間、中立の昼光、ネオンの混合光
- 時間帯: 日の出直後、ゴールデンアワー、曇天、ブルーアワー、夜
たとえば「逆光のリムライトで髪の輪郭が光り、顔は柔らかいバウンス光で照らされている」と書くと、モデルは被写体の立体感を出しやすくなります。光の記述を省くと、多くのモデルは中庸な正面光を選び、結果として平坦で印象の薄い絵になりがちです。
質感とマテリアル
触感の描写は意外に効きます。「濡れた革」「毛羽立ったウール」「傷のついた真鍮」「粉を吹いたような石膏」といった表現は、表面の反射や粗さの情報を含んでいます。金属なら反射の鋭さ、布なら織り目、肌なら産毛や皮脂のツヤといった具体語を足すと、解像感のある仕上がりになります。
逆に、質感の語を一切入れないと、モデルはツルツルとしたプラスチックのような表面を生成しがちです。これはCGっぽさの主要な原因のひとつです。
複数カットと動画への展開
差分設計という考え方
同じシーンの複数カットを作るとき、毎回ゼロからプロンプトを書くのは非効率です。そこで、固定する部分と変える部分を分ける差分設計を行います。
固定ブロックには、登場人物の特徴、世界観、時間帯、画風、ライティングの方針を書きます。変動ブロックには、ショットサイズ、アングル、被写体の動作だけを書きます。こうすると、全体のトーンを保ったまま画角だけを変えるという作業が簡単になります。
映画のコンテhiche的な流れを作るなら、ロングショットで場所を示し、ミディアムショットで人物関係を描き、クローズアップで感情を捉えるという順序が基本になります。この順序自体をテンプレート化しておくと、シーンごとの判断が速くなります。
感情の遷移をどう書くか
感情は直接書くより、身体の反応として書いたほうが伝わります。「悲しんでいる」ではなく「視線が下がり、口角がわずかに下がり、肩が内側に丸まっている」。この書き方なら、モデルは表情筋や姿勢の情報として解釈できます。
複数カットで感情を変える場合は、変動ブロックの感情記述だけを差し替えます。同じ光と画風を保ったまま表情だけを変えると、視聴者は自然な感情の流れとして受け取ります。
静止画から動画へ渡すときの注意
動画生成に進む場合、静止画のプロンプトがそのまま使えるとは限りません。動画モデルは時間方向の一貫性を保つ必要があるため、要素を増やしすぎると揺れや形状の崩れが発生しやすくなります。
実務でのコツは次のとおりです。
- 動画側では主題と動作を中心に絞り、細かい質感の指定は静止画より減らす
- カメラワークは1カットにつき1種類だけ指定する
- 動きの速度や方向を言葉で明示する
- カットの長さを想定し、複雑な動作を1カットに詰め込まない
静止画で詰めたディテールを動画で再現しようとすると破綻しやすいため、動画は構図と動きに集中し、質感は色調整の工程で補うという分担が現実的です。
反復と検証のワークフロー
探索と収束を分ける
作業を二段階に分けるのが効率的です。第一段階は探索で、プロンプトを大きく変えながら方向性を探ります。第二段階は収束で、当たりの出た構図を固定し、細部を詰めます。
探索段階では、解像度を下げて枚数を多く回します。低解像度でも構図の良し悪しは判断できます。収束段階で解像度を上げ、仕上げの調整に入ります。最初から高解像度で大量生成すると、時間も計算資源も無駄になります。
一度に一要素だけ変える
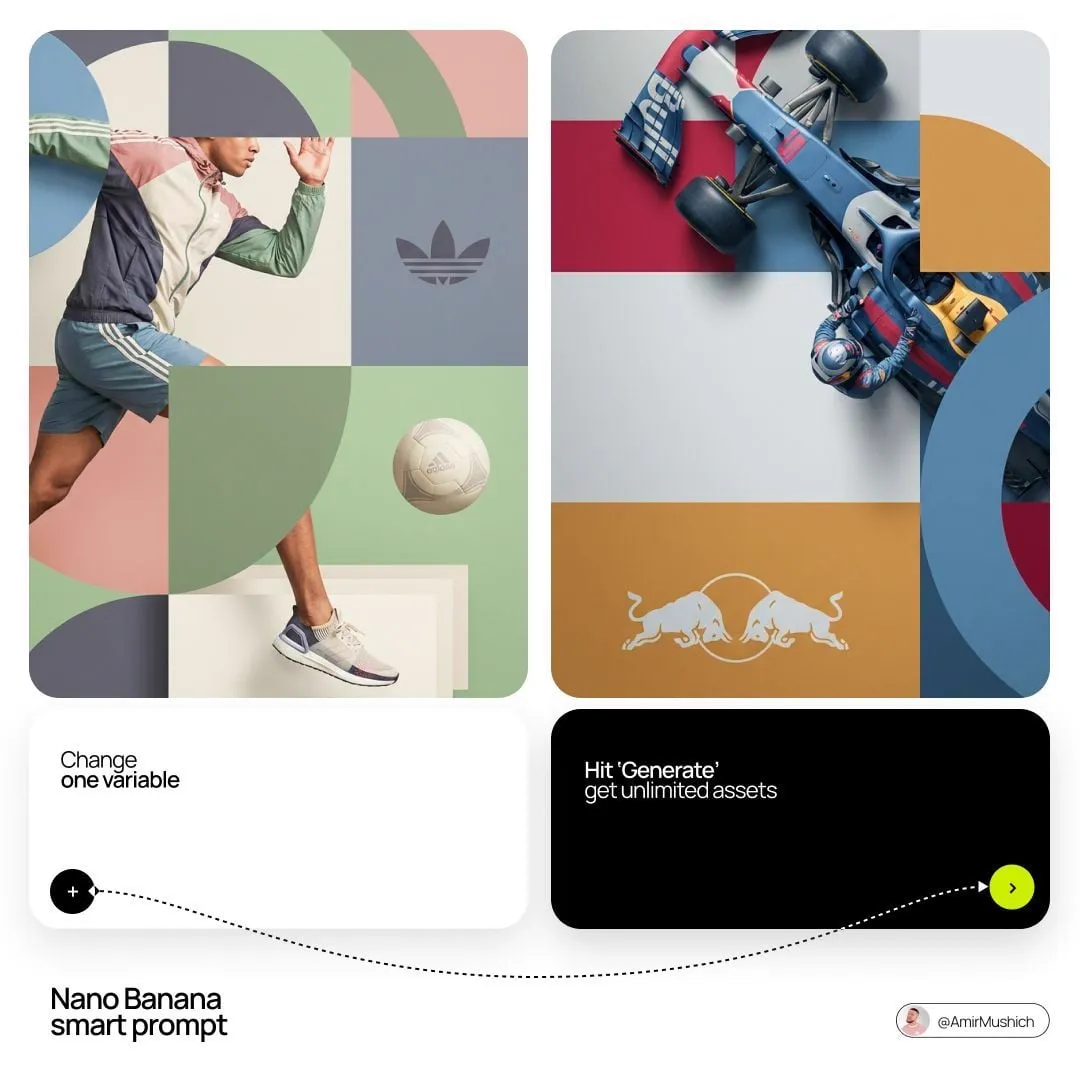
改善が止まる典型例は、複数の要素を同時に変えてしまうことです。構図も光も服装も一度に変えると、良くなった理由も悪くなった理由も分かりません。変えるのは常に一つ。これを守るだけで学習速度が変わります。
失敗パターンと修正の判断基準
生成結果が意図と違うとき、原因は大きく4つに分かれます。
- 構図が違う: ショットサイズ、アングル、被写体の位置の記述が不足している。
- 光が違う: 方向、質、色温度のいずれかが未指定。
- 質感が違う: マテリアルや表面状態の語彙が足りない。
- 崩れがある: 手や顔など構造の複雑な部位で発生しやすい。ネガティブ指定と解像度、ステップ数を見直す。
それぞれの症状に対して、直すべき場所は異なります。やみくもに単語を追加するのではなく、どの層の情報が足りないのかを切り分けてから修正します。
プロンプトを管理する
プロンプトは資産です。バージョン管理をしておくと、後から再利用できます。おすすめの方法は、1つのプロンプトを1ファイルとして保存し、冒頭に用途、モデル、シード、日付をメモとして書いておくことです。
さらに、よく使う定型句をパーツとして切り出しておきます。人物記述パーツ、ライティングパーツ、画風パーツをそれぞれ数種類用意し、組み合わせて使う運用にすると、新しいシーンでも短時間で質の高いプロンプトが組めます。
よくある間違いと改善のヒント
品質ワードを盛りすぎる
「最高品質」「超リアル」「マスターピース」といった語は、効果が薄いわりに語数を消費します。これらを10個並べるより、光とレンズと質感を具体的に書いたほうが結果は良くなります。品質ワードは2〜3個までに抑え、残りは観察可能な記述に回します。
抽象的な感情語だけに頼る
「悲しい」「怒っている」だけでは、モデルは誇張されたステレオタイプの表情を作りがちです。身体の姿勢、視線、筋肉の緊張として書くほうが自然な結果になります。
否定形をポジティブ側に書く
「帽子をかぶっていない」と書くと、帽子が生成されやすくなることがあります。モデルは否定語の処理が苦手なためです。避けたい要素はネガティブ側に移すのが原則です。
アスペクト比を後回しにする
縦長の構図が欲しいのに横長で生成すれば、後から構図を直すのは困難です。アスペクト比は最初に決め、それに合ったショットサイズと被写体配置を選びます。
1回の結果で判断する
同じプロンプトでも出力は確率的に変わります。1枚の結果で良し悪しを決めると、偶然に振り回されます。同じ条件で4〜8枚出し、傾向を見てから判断するのが基本です。
用途別のプロンプト設計例
商品撮影風のカット
白い背景に置かれた陶器のカップを、柔らかい大型ソフトボックスで照らす想定で組み立てます。主題に形状と素材、環境に背景の明るさ、光に拡散光源と弱い影、レンズに90mm相当のマクロ、質感に釉薬の反射を指定します。影の柔らかさを明示すると、通販用の写真らしい清潔感が出ます。
キャラクターの立ち絵
ゲームやアニメ向けの立ち絵は、線の処理と色の平坦さが重要になります。ポーズは左右対称か軽いS字、背景は単色か軽いグラデーション、ライティングは正面からの均一な光。質感の語彙は最小限にし、代わりに線の太さや塗りの傾向を指定します。
風景のコンセプトアート
広い空間を見せる場合、前景・中景・遠景の3層を意識して書きます。前景に小さな人物を置くとスケール感が生まれます。大気遠近の表現として、遠景のコントラストと彩度を下げる指定を入れると、奥行きが明確になります。
SNS用のサムネイル
小さく表示されることを前提に、要素を3つ以内に絞ります。主題を大きく、背景はシンプルに、明暗差を強く。細かいテクスチャは潰れるため、面の構成で見せる発想に切り替えます。
よくある質問
プロンプトは英語で書くべきですか
多くのモデルは英語の学習データが多いため、英語のほうが反応が素直な傾向があります。ただし近年は日本語の理解も向上しており、日本語で十分に意図が伝わる場面も増えています。判断基準としては、狙った画風に固有の英語表現があるかどうかです。写真や映像の技術用語は英語のまま入れたほうが精度が上がることが多いため、日本語の文章に英語の専門語を混ぜる方法が実務的です。
プロンプトが長すぎると良くないですか
長さそのものが問題なのではなく、情報密度が問題です。長くても各語が具体的なら有効ですが、抽象語や重複した品質ワードで埋めると効果が薄まります。目安として、主題・環境・光・技法・品質の5層がそれぞれ1〜2文で説明できているかを確認してください。
ネガティブプロンプトは必須ですか
必須ではありませんが、人物を扱う場合や高解像度を狙う場合には有効です。まずは品質系と構造系の少数項目から始め、効果を確認しながら調整するのが安全です。
同じ人物を何度も出したいのですが
文章だけでの再現は難しいため、参照画像を併用し、特徴の記述を短いタグセットとして固定してください。髪型、目の色、服装、体格の4項目を毎回同じ順序で書くだけでも、安定性は大きく向上します。
生成結果が毎回バラバラで困ります
要素を減らし、固定する部分と変える部分を分けてください。シード値を固定し、変更は一度に一つだけにする。この2点を守るだけで、ばらつきの原因が特定しやすくなります。
動画生成にそのまま流用できますか
多くの場合、そのままではうまくいきません。動画では時間方向の一貫性が必要になるため、要素を絞り、カメラワークを一つに限定し、動きの速度と方向を明示する調整が求められます。
まとめ:今日から始められる3つの習慣
第一に、5要素の型を毎回埋めること。主題、動作、環境、スタイル、品質の順に書き出すだけで、抜けが可視化されます。
第二に、変更は一度に一つだけにすること。これを守ると、どの語が効いたのかが正確に分かるようになります。
第三に、結果を記録すること。プロンプト、シード、モデル名、設定値を残しておけば、成功は再現でき、失敗は繰り返さずに済みます。
プロンプト設計はセンスではなく手順です。手順を回し続ければ、誰でも安定して意図に近い画像を出せるようになります。まずは手元の1枚を、5要素に分解して書き直すところから始めてみてください。
