
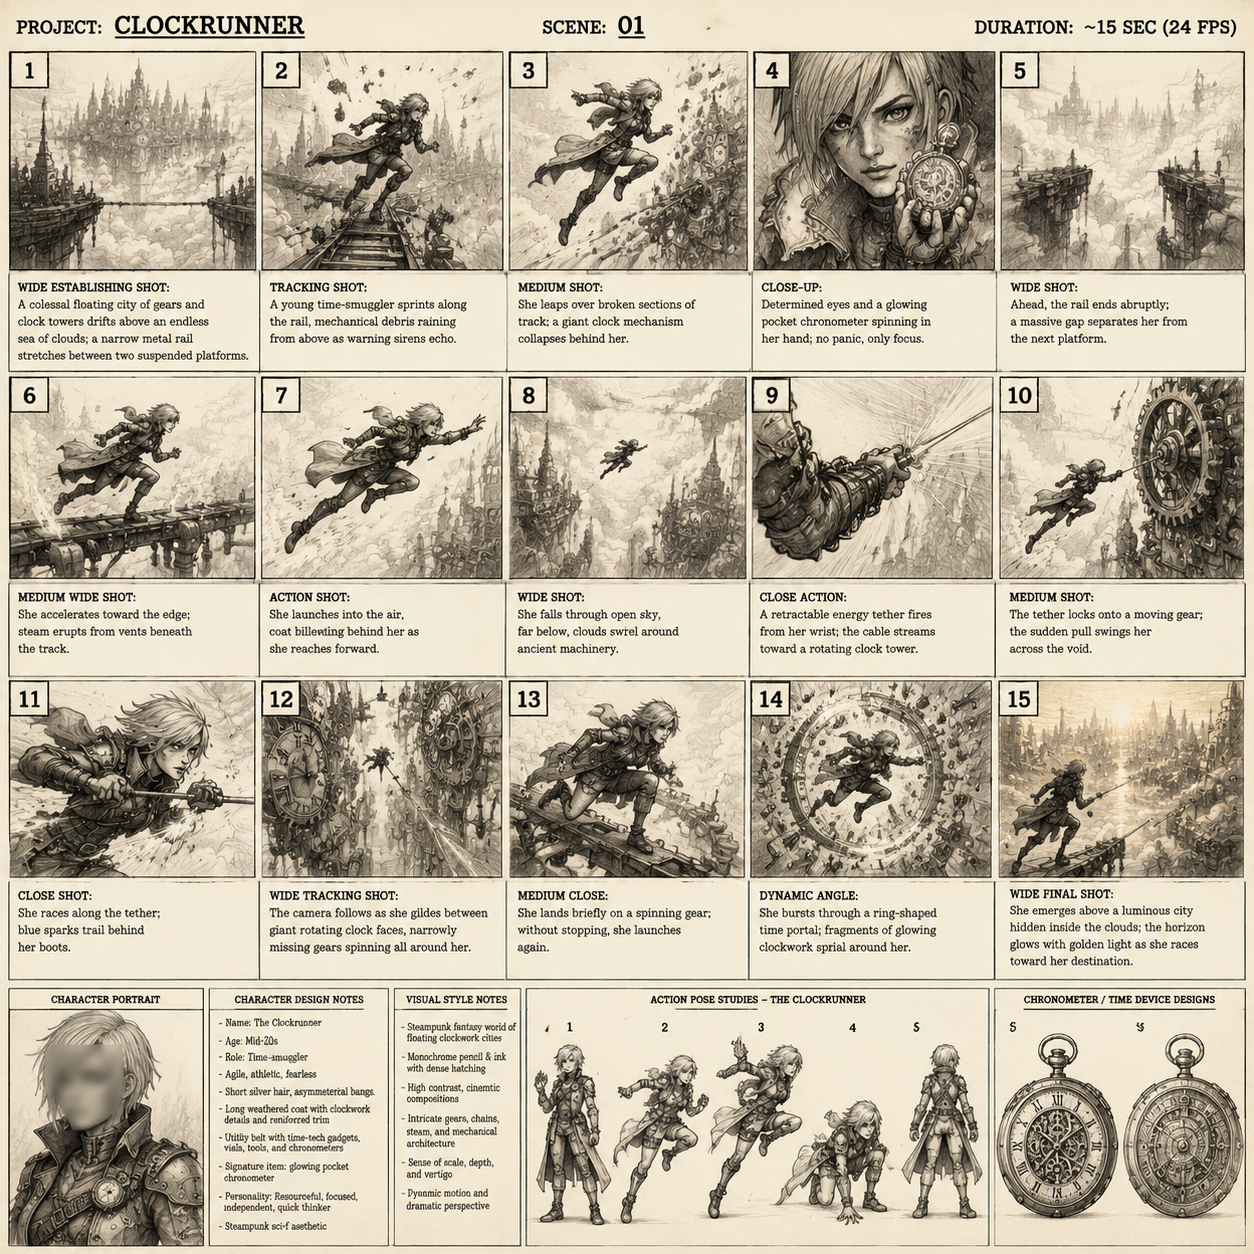
AI動画生成の現在地:テキストと画像から映像を作る意味
生成AIによる動画制作は、もはや実験的な遊びではありません。広告のプレビズ、SNS向けの短尺コンテンツ、商品紹介、教育教材、ゲームのコンセプト映像、音楽のリリックビデオなど、実際の制作工程の一部として使われるようになっています。背景にあるのは、拡散モデルによる画像生成の成熟と、トランスフォーマー系アーキテクチャによる時系列処理の精度向上です。この二つが組み合わさったことで、「静止画として破綻しない画」を「数秒間だけ自然に動かす」という難易度の高い処理が現実的な品質に到達しました。
現在のAI動画生成で安定してできることは、主に次のような範囲です。
- 5秒から15秒程度の短いクリップ生成(カット単位の映像素材)
- テキストプロンプトによる被写体・動作・カメラワークの指定
- 1枚の参照画像からのアニメーション化(画像to動画)
- 既存動画のスタイル変換や一部の動きだけを変える編集
- カメラのパン、ズーム、ドリー、オービットといった動きの再現
- ライティングや色調の一括トーン合わせ
一方で、まだ苦手な領域もはっきりしています。
- 数十秒を超える長尺での一貫性維持(人物の顔、服装、背景が崩れやすい)
- 手指や足元など細部の構造
- 画中に文字を正確に描画する処理
- 物理法則の厳密な再現(液体、衝突、布の挙動)
- 複数人による会話とリップシンクの同時制御
重要なのは、これらを「AIの限界」として諦めるのではなく、ワークフロー側で吸収する発想です。長尺が苦手なら短いカットを積み上げる。人物が崩れるなら参照画像とカット割りで守る。文字は別レイヤーで後から載せる。こうした工程設計の巧拙が、完成映像の品質を大きく左右します。AI動画生成は「プロンプトを打ち込む作業」ではなく、プリプロダクションからポストプロダクションまでの設計作業だと捉え直すのが第一歩です。
モデルの選び方:テキストto動画と画像to動画の違いを理解する
一口にAI動画生成といっても、入力の形式によって得意分野が分かれます。用途に合わない方式を選ぶと、どれだけ試行を重ねても狙った画になりません。まずは方式の違いを整理しましょう。
テキストto動画が向くケース
テキストto動画は、プロンプトだけでゼロから映像を生成する方式です。参照素材が存在しない新規カット、抽象的なイメージ、風景の確立カット、雰囲気重視のBロールなどに向いています。強みは自由度の高さと準備の軽さで、アイデアを最短で映像化できます。逆に、特定の人物や商品を正確に再現する用途には向きません。同じプロンプトでも毎回異なる結果が出るため、厳密な再現性が求められる場面では他の方式と組み合わせる必要があります。
画像to動画が向くケース
画像to動画は、1枚または複数の参照画像を起点に動きを与える方式です。キャラクターの外見を固定したい、商品の形状を保ちたい、絵コンテのタッチを維持したいといった目的では、こちらが圧倒的に有利です。参照画像が「設計図」の役割を果たすため、カット間のばらつきを抑えやすく、シリーズものの制作に向いています。事前に画像生成モデルでキービジュアルを作り込み、それを動かす流れが実務的です。
動画to動画・編集系の活用
既存の動画を入力として、スタイル変換、フレーム補間、解像度向上、一部の動きの差し替えを行う方式もあります。撮影済みの素材を別の画風に変換したり、低フレームレートの素材を滑らかにしたりする用途で力を発揮します。撮影素材とAI生成素材を混在させる場合、この系統の処理でトーンを揃えると違和感が減ります。
モデル選定のチェックリスト
| 判断軸 | 確認する内容 | 向いている選択 |
|---|---|---|
| 被写体の再現性 | 特定の人物・商品を固定する必要があるか | 画像to動画、参照画像併用 |
| カメラワーク | 複雑な移動や回転が必要か | カメラ制御に強いモデル |
| スタイルの強さ | アニメ調・実写調・絵画調の指定 | スタイル特化型 |
| 尺 | 必要なクリップ長 | 長尺対応か分割前提か |
| 解像度 | 最終的な納品サイズ | アップスケール前提の可否 |
| 動きの激しさ | アクションか静かな会話か | 動体に強いモデルと静穏系 |
| ライセンス | 商用利用の条件 | 利用規約の確認必須 |
| 連携方法 | 手動かAPIか | 量産ならAPI、単発なら画面操作 |
判断に迷ったときは、「完成映像の中でどのカットが視聴者の印象を決めるか」を先に決め、その1カットに最も適した方式を選ぶのが現実的です。全カットを同じ方式で統一する必要はありません。
制作ワークフロー全体像:企画から納品までの流れ
AI動画制作は、思いつきでプロンプトを打つほど迷走します。次の7ステップを固定すると、作業の抜け漏れと手戻りが激減します。
- 目的と制約の定義:尺、縦横比、公開先、トーン、納品形式を決める
- 脚本と構成:伝えたい内容をカット単位に分解する
- ショットリスト作成:各カットの画角、動き、尺を表にまとめる
- 参照素材の準備:キャラクター設定画、背景、スタイル見本を用意する
- 生成と選別:カットごとに複数案を出し、合格ラインで選ぶ
- 編集と音声:つなぎ、テンポ、BGM、効果音、ナレーションを整える
- 仕上げと書き出し:カラー調整、アップスケール、形式変換
各ステップの成果物を明確にしておくと、後工程でのやり直しが減ります。たとえばステップ3のショットリストは、生成時のプロンプトの下書きそのものになります。ここを丁寧に作ると、生成フェーズの試行回数が半分以下になることも珍しくありません。
反復サイクルの設計
AI動画は一発で決まりません。ただし「とりあえず何度も回す」のは時間の浪費です。おすすめは三段階の反復です。
- 粗探索:低解像度・短尺で構図と動きの方向性を探る(多数試行)
- 中精度:当たりの構図を固定し、動きと尺を詰める(少数試行)
- 本番:解像度を上げ、必要なカットだけ再生成する(最小試行)
この設計により、高コストな高解像度生成の回数を最小限に抑えられます。
企画とプリプロダクション:絵コンテとプロンプト設計
生成の品質は、生成前の設計でほぼ決まります。特にショットリストとプロンプトの構造化は投資対効果が高い工程です。
ショットリストの作り方
各カットについて、最低限次の項目を埋めます。
- カット番号と尺(例:3秒)
- 画面の目的(状況説明、感情の強調、商品のディテール)
- 被写体とその動作
- カメラの位置と動き(固定、パン、ドリーイン、オービット)
- レンズ感と被写界深度
- 照明の方向と色温度
- 背景の情報量
- 前後のカットとのつながり
この表があると、生成時に「何を固定し、何を変えて試すか」が明確になります。逆に表がないと、毎回すべての要素を同時に変えてしまい、どの変更が効いたのか分からなくなります。
プロンプトの構造
プロンプトは、思いついた単語を並べるのではなく、役割ごとに積み上げるのが有効です。基本の並びは次のとおりです。
被写体 → 動作 → 環境 → カメラ → 照明 → レンズと質感 → スタイル → 除外指定
具体例を挙げます。
- 被写体:白いコートを着た30代の人物、黒いショートヘア
- 動作:ゆっくり振り返り、わずかに微笑む
- 環境:雨上がりの夜の路地、濡れた路面に反射する看板の光
- カメラ:ミディアムショット、ゆっくりしたドリーイン、浅い被写界深度
- 照明:ネオンによるサイドライト、寒色と暖色のコントラスト
- レンズと質感:35mm相当、フィルムグレイン控えめ、自然な肌の質感
- スタイル:シネマティック、彩度は中庸
- 除外指定:余分な人物、文字、極端な手ぶれ、顔の変形
この構造を英語で書く場合も、順序と役割は同じです。長すぎるプロンプトは要素同士が干渉するため、まずは7から10要素程度に絞り、効果を見ながら追加します。
尺とカット割りの設計
AI生成のクリップは短いものが安定します。1カット3秒から5秒を基本単位とし、10秒を超える見せ場は複数カットに分割してつなぐほうが結果的に滑らかです。カットの切れ目は、動きの方向が変わる瞬間や視線が切り替わる瞬間に置くと自然に見えます。
生成フェーズの実践:試行回数を減らすコツ
生成フェーズで最も差がつくのは、無駄な試行をどれだけ削れるかです。
シードとバリエーションの管理
多くのモデルはシード値を指定できます。シードを固定すると、構図の骨格を保ったまま細部だけを変える比較が可能になります。逆に、構図そのものを探している段階ではシードをランダムにして広く探索します。「固定して詰める」「ランダムで探す」を意識的に切り替えるだけで、作業の質が変わります。
一度に変える変数は一つ
失敗の典型は、構図も照明もカメラも同時に変えてしまうことです。変更は一つずつ。構図が決まったら照明を詰め、照明が決まったらカメラを詰める。この順序を守ると、良い結果が再現可能な知識になります。
解像度・フレームレート・尺の初期設定
- 探索段階:短尺・低解像度・低フレームレートで速度優先
- 決定段階:本番の縦横比と同じ比率で確認(比率が変わると構図が崩れる)
- 本番:最終解像度で生成し、必要に応じて補間とアップスケール
比率の確認を後回しにすると、横長で決めた構図が縦長で破綻する事故が起きます。SNSの縦動画、横長の広告、正方形のサムネイルなど、展開先の比率は最初に決めておきましょう。
選別の基準を先に決める
生成した中から選ぶとき、「なんとなく良いもの」を選ぶと後で後悔します。評価軸を先に決めます。
- 顔と手指の破綻がないか
- カメラの動きが意図どおりか
- 前後のカットとトーンがつながるか
- 動作が開始から終了まで自然に完結しているか
- ループ再生やトリミングに耐えるか
1つのカットに5案から10案、決定版に2案から3案という配分が現実的です。
一貫性の設計:キャラクター・スタイル・背景をそろえる
シリーズものやストーリー性のある映像では、一貫性が最大の課題になります。ここで効くのは生成技術そのものより、設計の工夫です。
キャラクターの固定
キャラクターシートを作り、正面・斜め・横・背面の参照画像を用意します。各カットの生成時には、その中から最も近いアングルの参照画像を使います。加えて、服装、髪型、アクセサリー、年齢感をテキストでも明記します。画像とテキストの二重指定は、片方だけより格段に安定します。
スタイルの固定
スタイルの言葉は、抽象語より具体的な手がかりのほうが効きます。「シネマティック」だけでなく、光源の種類、色温度、コントラスト、粒状感、被写界深度の深さまで指定します。全カット共通のスタイル定義をテキストファイルに保存し、各プロンプトの末尾に貼り付ける運用が実務的です。
背景とライティングの連続性
同じ場所で連続するカットは、背景の要素(看板、窓、家具)と光の方向を固定します。光の向きがカットごとに変わると、観客は無意識に違和感を覚えます。朝から夕方へ時間が進むシーンでは、段階的に色温度を変える設計にすると自然です。
マルチイメージ活用の考え方
複数の参照画像を同時に与えて、キャラクターと背景を別々に指定する手法も有効です。人物は参照画像A、環境は参照画像B、スタイルは参照画像Cというように役割を分けると、テキストだけでは伝わらないニュアンスを補えます。
ポストプロダクション:編集・音声・カラー
生成したクリップは素材です。素材を映像作品に変えるのが編集工程であり、ここで品質の印象が大きく変わります。
編集の基本
- テンポ:カットの長さを一定にせず、見せ場は短く、余韻は長く
- つなぎ:動きの方向をそろえると、カットが変わっても視線が迷わない
- トランジション:多用しない。AI素材は繋ぎの粗さが目立つため、ハードカットが安全
- リズム:BGMのビートにカットの切れ目を合わせると、生成素材の粗さが気になりにくい
音声の設計
AI動画は無音で生成されることがほとんどです。音は後から載せます。
- BGM:トーンを決める最重要要素。テンポと感情を先に決める
- 効果音:動きに対応する音を入れると、動きの不自然さが緩和される
- ナレーション:音声合成で生成し、字幕と併用する
- 環境音:街、室内、自然などのベッド音で無音の不自然さを消す
- リップシンク:会話カットでは音声に合わせた口の動きを個別に処理する
カラーとディテール
全カットに共通のLUTを適用すると、トーンが一気に揃います。肌色だけ保護する調整を加えると破綻が減ります。仕上げにアップスケールとノイズ除去を行い、必要に応じてフレーム補間で滑らかにします。ただし補間は動きの激しいカットで破綻することがあるため、カット単位で適用を判断します。
よくある失敗とトラブルシューティング
| 症状 | 主な原因 | 対処 |
|---|---|---|
| 顔がカットごとに変わる | 参照画像なし、記述が曖昧 | キャラクターシートを用意し、特徴を具体化 |
| 手指が崩れる | 手の描写が小さい、動きが速い | 手を画面から外す、寄りすぎない画角にする |
| カメラが勝手に動く | カメラ指定が弱い、動きの指示過多 | カメラを明示し、動作指示を減らす |
| 動きが途中で止まる | 尺が長すぎる | カットを分割し、1カット1モーションにする |
| ちらつきが出る | フレーム間の一貫性不足 | 短尺化、補間、後処理で軽減 |
| 全体がのっぺりする | 照明指定が不足 | 光源の方向と種類を明記 |
| 文字が崩れる | 生成モデルの文字描画が苦手 | 文字は編集ソフトで後載せ |
| 色がカットごとに違う | スタイル定義のばらつき | 共通スタイル定義とLUTで統一 |
| 人物が増殖する | 人数指定が弱い | 人数を明記し、除外指定を追加 |
| 画面が荒れる | 解像度不足 | 生成解像度を上げ、アップスケールを適用 |
トラブルが起きたときは、まず「そのカットを分割できないか」を検討します。AI動画の多くの問題は、1回の生成に詰め込みすぎたことが原因です。
コストと時間を最適化する運用設計
制作を続けると、時間と計算資源の管理が重要になります。
探索と本番を分ける
前述のとおり、低品質で広く探り、高品質で絞り込む流れが最も効率的です。探索段階で完成度を求めると、時間も資源も無駄になります。
テンプレート化する
繰り返し使う要素はテンプレートにします。
- スタイル定義文(照明、色、質感、レンズ)
- キャラクター定義文(外見、服装、性格の見せ方)
- カメラワークの定型句(ドリーイン、オービットなど)
- 除外指定の定型リスト
- 編集プロジェクトのひな形(尺、比率、BGM構成)
これにより、新しい案件でも立ち上がりが速くなります。
分業の設計
役割を分けると手戻りが減ります。
- 構成担当:脚本とショットリスト
- 生成担当:プロンプト設計と選別
- 編集担当:つなぎ、音声、カラー
小規模なら一人で兼任しても、工程を分けて作業する意識が品質を守ります。
成果物の命名とバージョン管理
生成物は必ず命名規則を決めて保存します。カット番号、バージョン、採用可否をファイル名に含めると、編集段階で迷いません。採用しなかった案も残しておくと、後の差し替えで役立ちます。
FAQ:AI動画生成の実務的な疑問
初心者はどの方式から始めるべきですか
画像to動画から始めるのがおすすめです。参照画像があると結果が安定し、学びが蓄積しやすいためです。テキストto動画は構図の探索には強いものの、再現性の学習が難しく、最初の練習には向きません。
1本の短尺動画を作るのにどれくらい時間がかかりますか
15秒から30秒の映像で、慣れれば数時間から1日程度です。ただし最初の数本は試行錯誤に時間がかかります。カット数を5から8に抑えた短い作品から始めると、学習効率が高まります。
長尺の映像は作れますか
可能ですが、1回の生成で長尺を作るのではなく、短いカットをつないで構成するのが現実的です。ストーリー性を持たせる場合は、カット間の一貫性設計に最も時間を割くことになります。
商用利用で気をつけることは
利用するモデルや素材のライセンス条件を確認することが前提です。参照画像に第三者の著作物や実在人物の肖像が含まれる場合は、権利処理が必要になります。生成物の扱いに関する規約はサービスごとに異なるため、案件開始前に必ず確認してください。
スマートフォンだけでも制作できますか
構成と編集は可能ですが、生成そのものはクラウド上のサービスを利用する形になります。最終的な編集やカラー調整はパソコンのほうが効率的ですが、短尺のSNS投稿であればモバイル中心の運用も現実的です。
同じ結果を再現するにはどうすればよいですか
シード値、プロンプト、参照画像、解像度、比率、モデルのバージョンを記録します。この6項目をメモしておけば、近い結果を再現できます。バージョンが更新されると結果が変わることもあるため、採用案は必ず書き出して保存します。
人物以外に向いている題材はありますか
風景、商品、料理、抽象的なモーション、ロゴのアニメーション、テキストモーションなどは比較的扱いやすい題材です。人物の表情や手指に依存しないぶん、破綻が目立ちにくくなります。
生成した素材が不要になったときの判断基準は
「そのカットがなくても内容が伝わるか」で判断します。伝わるなら削除し、尺を詰めます。AI生成素材は数を並べるほど粗さが目立つため、引き算の編集が有効です。
音声と映像の同期がうまくいきません
会話カットは分割し、口の動きを個別に処理します。ナレーション主体の構成にすると同期の問題を回避しやすくなります。また、動きの大きい場面に効果音を重ねると、同期のずれが知覚されにくくなります。
最初の1本は何から作ればよいですか
15秒、5カット、ナレーションなし、BGMのみの構成がおすすめです。題材は自分の身近なもの(部屋、散歩道、コーヒー)にすると、参照画像を自分で用意でき、権利面でも安全です。完成後は、カットごとの所要時間と試行回数を記録します。この記録が、次の作品の見積もり精度を上げ、結果として制作の質と速度の両方を高めます。AI動画生成は、技術の習得よりも工程の設計力がものを言う領域です。小さく作って記録し、少しずつ規模を広げていく進め方が、遠回りのようで最も速い上達の道になります。
