
Perché i modelli open source stanno cambiando la produzione video
La generazione video con intelligenza artificiale ha smesso di essere una curiosità da laboratorio. Chi lavora nel marketing, nel documentario, nel gaming o nella formazione usa ormai pipeline che trasformano un prompt testuale o una singola immagine in clip montabili. La differenza rispetto a pochi anni fa non sta soltanto nella qualità dell'inquadratura, ma nella possibilità di controllare il processo: sostituire il modello, cambiare il sampler, correggere il movimento di camera, rigenerare solo una porzione della sequenza senza rifare tutto da zero.
Quando si parla di open source in questo ambito non si intende gratuità assoluta né assenza di competenze. Si intende accesso al codice, ai pesi del modello e alla possibilità di eseguire l'intera pipeline in locale o su una macchina noleggiata. Questo cambia tre cose in modo radicale.
- Sovranità del dato. Il materiale non pubblicato, i volti degli attori o i prodotti non ancora lanciati restano nell'infrastruttura che scegli.
- Riproducibilità. Un progetto può essere congelato con versioni specifiche di modello, scheduler e prompt, e rigenerato in modo coerente anche a distanza di mesi.
- Assenza di vincoli di piattaforma. Non si dipende dal listino, dalle limitazioni d'uso o dalle policy di un singolo servizio.
Il rovescio della medaglia è la complessità operativa. Installare, ottimizzare e mantenere questi strumenti richiede tempo, una GPU adeguata e una certa dose di pazienza con dipendenze Python. Il resto di questa guida serve a capire dove vale la pena investire quel tempo e dove invece conviene una soluzione gestita.
Il panorama tecnico: famiglie di modelli a confronto
L'ecosistema si divide in poche grandi famiglie, ognuna con un profilo diverso di qualità, requisiti hardware e flessibilità. Riconoscere la famiglia a cui appartiene un modello aiuta più di qualsiasi classifica, perché spiega in anticipo quali risultati aspettarsi e quali problemi saranno ricorrenti.
Diffusione latente applicata al video
Questa è la discendenza più diretta dei modelli di generazione immagini. Il principio è lo stesso: si lavora in uno spazio latente compresso, dove il rumore viene progressivamente rimosso sotto la guida del prompt. La differenza è che qui la coerenza deve reggere nel tempo, non solo nello spazio.
Strumenti come Stable Video Diffusion hanno dimostrato che un modello relativamente leggero può produrre movimento credibile partendo da un'immagine fissa. AnimateDiff ha aggiunto un livello di temporal attention che permette di animare modelli di immagini già esistenti, con un ecosistema di estensioni molto ricco. Soluzioni più recenti come LTX-Video puntano sulla velocità: generano clip brevi in tempi contenuti, il che le rende ideali per iterare rapidamente su molte varianti.
Il vantaggio pratico di questa famiglia è la maturità degli strumenti attorno: interfacce nodali, gestori di modelli, preset condivisi dalla community. Lo svantaggio è che la coerenza su sequenze lunghe resta fragile: oltre i pochi secondi, i dettagli iniziano a scivolare.
Transformer video e modelli a pesi aperti
La seconda famiglia adotta architetture basate su transformer applicati a patch spazio-temporali. È l'approccio che ha permesso di scalare la qualità verso il fotorealismo e di gestire prompt più complessi, con più soggetti e interazioni.
Modelli come CogVideoX, HunyuanVideo, Mochi 1, Wan e Open-Sora appartengono a questo gruppo. Offrono in genere una resa superiore su scene affollate, una migliore comprensione delle istruzioni lunghe e una gestione più solida del movimento complesso. In cambio richiedono molta più memoria video: parliamo spesso di 24 GB di VRAM per configurazioni comode, con possibilità di scendere usando quantizzazioni e offload parziale su CPU.
Qui la differenza tra un modello e l'altro si gioca su dettagli che contano in produzione: quanto fedelmente segue il prompt, quanto stabile è il soggetto, quanto realistico è il movimento della camera, quanto è semplice il fine-tuning su uno stile proprietario.
Cosa insegnano i modelli chiusi di ultima generazione
I grandi modelli proprietari hanno alzato l'asticella su un punto specifico: la sensazione di realismo cinematografico. Illuminazione coerente, profondità di campo credibile, movimenti di camera fluidi e fisica plausibile degli oggetti sono diventati lo standard di riferimento.
La community open source reagisce per imitazione e per specializzazione. Nascono così modelli ottimizzati per il movimento umano, per le riprese di prodotto, per le animazioni stilizzate, per il lip-sync. Per chi produce contenuti questo è un vantaggio: invece di cercare il modello tuttofare, si sceglie lo strumento giusto per il tipo di inquadratura.
Il caso dei modelli asiatici e la loro influenza
Modelli come Kling e Hailuo hanno mostrato per primi quanto velocemente si potesse arrivare a un realismo convincente su soggetti umani e scene dinamiche. Sebbene non siano open source nel senso pieno del termine, il loro impatto sull'ecosistema aperto è stato enorme: hanno definito le aspettative del pubblico e spinto i laboratori a pubblicare pesi aperti con capacità comparabili.
La lezione pratica è che la distanza tra soluzioni chiuse e aperte si misura in mesi, non in anni. Chi costruisce un workflow oggi deve quindi progettarlo per essere sostituibile nel componente modello, non per dipendere da una singola API.
Criteri di valutazione: una griglia in sette punti
Prima di scaricare decine di gigabyte di pesi, conviene valutare i candidati su una griglia esplicita. Questi sono i sette criteri che fanno la differenza in un progetto reale.
- Fedeltà al prompt. Il modello capisce istruzioni articolate o ignora tutto ciò che supera le tre righe?
- Coerenza temporale. Il volto, i vestiti e lo sfondo restano stabili per tutta la durata della clip?
- Controllo del movimento. Si può indicare direzione, velocità e tipo di movimento di camera senza rigenerare da capo?
- Ingombro hardware. Qual è il requisito minimo realistico e quanto rallenta la generazione?
- Licenza d'uso. I pesi e gli output sono utilizzabili commercialmente senza ambiguità?
- Attività della community. Esistono LoRA, adattatori, script di inferenza e guide aggiornate?
- Integrabilità. Il modello espone un'API o una CLI utilizzabile da uno script di automazione?
Una nota sul punto cinque, spesso trascurato: verificare la licenza prima di produrre contenuti per un cliente evita sorprese spiacevoli in fase di consegna. Le licenze dei modelli aperti variano molto, da quelle permissive a quelle con restrizioni sull'uso commerciale o sul numero di utenti.
Coerenza del personaggio e continuità narrativa
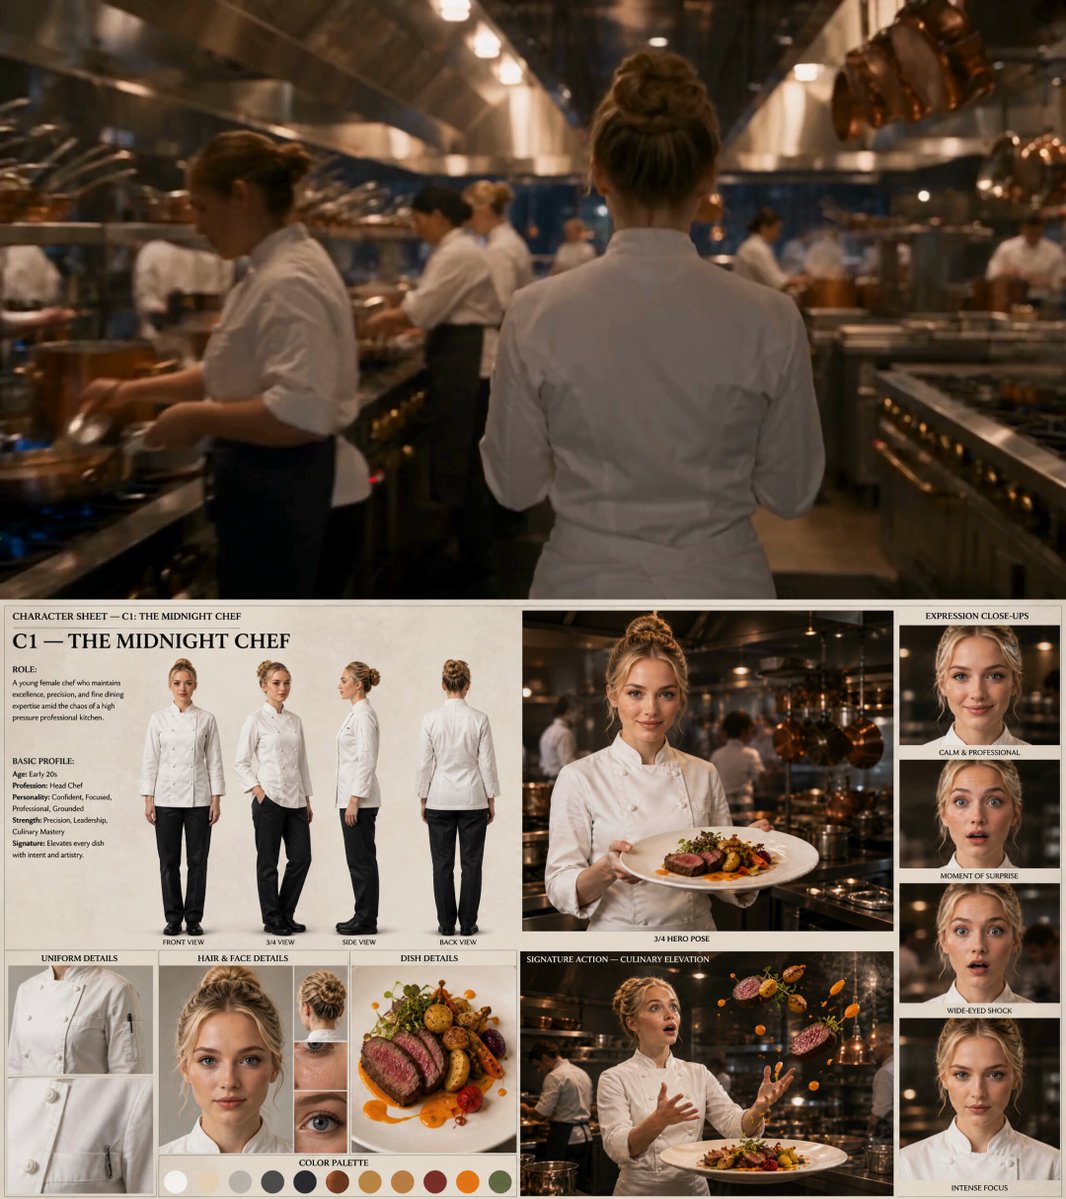
È il problema numero uno di chi prova a raccontare una storia invece di produrre una clip isolata. La domanda è semplice: come faccio a far recitare lo stesso volto in dieci inquadrature diverse?
Tecniche pratiche per stabilizzare un soggetto
Partenza da immagine di riferimento. Generare o selezionare un fotogramma chiave di alta qualità e usarlo come input image-to-video riduce drasticamente la deriva. Il modello ha meno libertà e più vincoli.
Adattatori di identità. Addestrare un piccolo adattatore su 15-30 immagini del soggetto permette di richiamare lo stesso volto con un token dedicato. È il metodo più affidabile su progetti lunghi, ma richiede tempo di preparazione e un dataset pulito.
Segmentazione e compositing. Invece di chiedere al modello di essere perfetto, si genera il movimento e si sostituisce il volto in post-produzione con tecniche di face swap di qualità. È una scorciatoia pragmatica e molto usata in ambito pubblicitario.
Continuità di scena, non di fotogramma. Anche con un volto stabile, la narrazione si perde se cambiano i vestiti, l'ora del giorno o la posizione degli oggetti. Tenere un documento di continuity con descrizioni fisse di outfit, luci e ambienti riduce le incoerenze più di qualsiasi parametro tecnico.
Gestire più personaggi nella stessa inquadrata
Con due o tre soggetti la difficoltà cresce in modo non lineare: i modelli tendono a fondere i volti o a scambiare i ruoli. Le strategie che funzionano sono inquadrature più semplici con un soggetto dominante, prompt che descrivono posizione e azione di ciascuno, e generazione separata delle porzioni di scena da unire in montaggio quando l'interazione non è essenziale.
Controllo cinematografico: lenti, luce e movimento
Un modello video generalista produce un'inquadratura plausibile, non necessariamente quella che serve. Il controllo si costruisce su tre livelli.
Linguaggio della camera
Descrivere il movimento con precisione cambia il risultato più di dieci aggettivi di stile. Espressioni come "carrellata laterale lenta verso destra", "dolly in avvicinamento al volto", "ripresa a mano con micro-tremolio", "drone che sale rivelando il paesaggio" orientano il modello in modo molto più efficace di "cinematico".
Molti strumenti open permettono anche un controllo strutturale: mappe di profondità, pose scheletriche, flussi ottici. Se il progetto richiede un movimento preciso, questa è la strada, perché il risultato è riproducibile e non dipende dalla fortuna del campionamento.
Illuminazione e atmosfera
La luce è ciò che distingue un video amatoriale da uno professionale. Vale la pena specificare direzione della fonte principale, rapporto tra luci e ombre, temperatura colore e ora del giorno. Frasi come "luce finestra morbida da sinistra, ombre lunghe, tonalità calde di tardo pomeriggio" producono risultati molto più coerenti di qualsiasi termine generico come "bella illuminazione".
Scelta dell'ottica e resa della profondità
Anche i termini ottici funzionano: grandangolo, teleobiettivo, macro, profondità di campo ridotta, sfocatura dello sfondo. Attenzione però a non accumulare richieste contraddittorie: chiedere contemporaneamente un grandangolo estremo e uno sfondo completamente sfocato confonde il modello e produce artefatti.
Hardware, tempi e costi reali
Qui si separano i sogni dalle possibilità. La generazione video è l'attività più esigente tra quelle legate all'IA generativa, e il collo di bottiglia è quasi sempre la memoria video.
- 8-12 GB di VRAM. Si lavora con modelli leggeri, risoluzioni ridotte e clip molto brevi. Utile per prototipare, non per la produzione.
- 16-24 GB di VRAM. È la fascia realistica per modelli transformer di media dimensione con quantizzazione. Buon compromesso tra tempi e qualità.
- 40 GB e oltre. Necessaria per lavorare a risoluzione piena senza compromessi e per il fine-tuning.
Il noleggio a ore di una GPU su cloud è spesso la scelta economicamente più sensata per chi produce pochi video al mese: si paga solo il tempo effettivo di rendering e non si immobilizza capitale in hardware che invecchia in diciotto mesi. Chi produce in modo continuativo, invece, ammortizza rapidamente una macchina dedicata.
Un fattore spesso ignorato è il tempo di iterazione. Se una clip richiede dieci minuti e servono venti varianti, la giornata è finita. Modelli più veloci ma leggermente meno raffinati possono essere la scelta vincente in fase esplorativa, lasciando il modello pesante solo alla resa finale.
Flusso di lavoro operativo in otto passi
Pre-produzione
- Scrivere lo script per inquadrature. Ogni clip deve avere una funzione narrativa chiara: chi fa cosa, dove, con quale emozione.
- Definire un documento di stile. Palette, riferimenti visivi, descrizione degli outfit, tipo di luce. Diventa la base dei prompt e riduce la frammentazione estetica.
- Preparare gli asset di riferimento. Immagini chiave, pose, eventuali adattatori di identità.
Generazione
- Prototipare a bassa risoluzione. Si valuta composizione e movimento, non i dettagli. Eliminare presto le idee deboli è la forma più efficace di risparmio.
- Bloccare il seed e versionare i parametri. Salvare prompt, seed, modello e scheduler per ogni clip approvata rende possibile la rigenerazione coerente.
- Rigenerare solo le porzioni difettose. Con tecniche di inpainting video si corregge un dettaglio senza rifare l'intera sequenza.
Post-produzione
- Upscaling e interpolazione dei fotogrammi. L'aumento di risoluzione e l'inserimento di fotogrammi intermedi migliorano la resa percepita più di quanto ci si aspetti.
- Montaggio, suono e correzione colore. Il suono, in particolare, è ciò che rende credibile un video generato: ambiente, passi, respiro, musica. Molti progetti falliscono qui, non nella generazione.
Errori comuni e come evitarli
Prompt enciclopedici. Elenchi di dieci aggettivi producono risultati confusi. Meglio poche indicazioni precise, ordinate per priorità: soggetto, azione, ambiente, luce, camera.
Ignorare la durata. Chiedere venti secondi continui a un modello addestrato su clip di cinque porta a derive evidenti. Meglio comporre sequenze brevi e montarle.
Saltare i test di risoluzione. Valutare un modello su una singola clip fortunata non dice nulla sulla sua affidabilità. Serve una batteria di dieci prompt diversi con lo stesso seed.
Sottovalutare l'audio. Un video tecnicamente perfetto senza sound design sembra finto. Pianificare la colonna sonora fin dall'inizio cambia le scelte di inquadratura.
Dimenticare i diritti. Verificare licenza del modello, provenienza delle immagini di riferimento e consenso delle persone ritratte è parte del lavoro, non un dettaglio burocratico.
Casi d'uso concreti
Pubblicità e prodotto. Qui il controllo vince sulla creatività selvaggia: si usano image-to-video per mantenere il packaging identico, movimenti di camera semplici e ripetibili, e si rigenera finché la resa non è impeccabile.
Contenuti social verticali. Il ritmo conta più della perfezione. Modelli veloci, clip da tre-cinque secondi, tagli frequenti e sottotitoli dinamici funzionano meglio di un piano sequenza raffinato ma lento.
Documentario e divulgazione. La sfida è la credibilità. Servono immagini plausibili di luoghi o processi difficili da filmare, con attenzione a non dichiarare come reale ciò che è generato.
Previsualizzazione. Prima di girare, si generano versioni approssimative delle scene per testare ritmo e inquadrature. È l'uso con il miglior rapporto tra sforzo e beneficio.
Domande frequenti
Serve una GPU costosa per iniziare? No. Si può iniziare con 12 GB di VRAM e modelli leggeri, oppure noleggiando potenza di calcolo a ore. La qualità cresce con l'hardware, ma il collo di bottiglia iniziale è la capacità di scrivere prompt e strutturare sequenze.
Un modello open source può eguagliare le soluzioni commerciali? Su molti tipi di inquadratura sì, sui soggetti umani in movimento complesso resta spesso un divario, che si riduce ogni pochi mesi.
Meglio fine-tuning o adattatori leggeri? Per uno stile o un volto specifico gli adattatori leggeri sono quasi sempre la scelta più rapida ed economica. Il fine-tuning completo ha senso solo con grandi volumi di dati e necessità molto particolari.
Come si mantiene la coerenza tra scene diverse? Con un documento di stile rigido, immagini di riferimento condivise, adattatori di identità e un montaggio che accetta piccole variazioni invece di pretendere uniformità assoluta.
Quanto tempo serve per imparare? Un pomeriggio per la prima clip, una o due settimane per un workflow affidabile e ripetibile. La parte difficile non è il software, ma costruire un metodo.
Conclusione: scegliere in base al progetto, non alla moda
Il panorama della generazione video open source è abbastanza maturo da sostenere progetti professionali, a condizione di smettere di cercare il modello definitivo. La strategia vincente è modulare: un modello veloce per esplorare, uno pesante per la resa finale, adattatori per la coerenza, strumenti di post-produzione per correggere ciò che l'IA sbaglia.
Prima di cambiare strumento, conviene chiedersi quale problema specifico si sta cercando di risolvere: stabilità del volto, realismo della luce, velocità di iterazione o costi di calcolo. Ogni risposta porta a un modello diverso, e nessuna classifica può sostituire questa valutazione fatta sul proprio caso d'uso.
