
Warum Kurzclips allein keine Strategie mehr sind
Kurzvideos sind kein Trend mehr, sondern Grundrauschen. Jede Marke, jede Agentur und jeder Solo-Creator veröffentlicht vertikale Clips im Akkord – oft mehrere pro Woche. Das Format ist omnipräsent und genau deshalb kein Unterscheidungsmerkmal mehr. Die Aufmerksamkeit pro einzelnem Clip sinkt, die Erwartung des Publikums wächst schneller als die Produktionskapazität der meisten Teams, während die Kosten pro fertig geschnittener Sekunde hoch bleiben.
Wer in dieser Lage Reichweite aufbaut, gewinnt nicht über Menge, sondern über drei Faktoren: Erzählqualität, visuelle Wiedererkennbarkeit und Iterationsgeschwindigkeit. Generative KI verschiebt dabei den Engpass. Nicht Kamera, Licht und Location begrenzen heute das Tempo, sondern Konzept, Regie und Konsistenz. Ein Zweierteam kann eine Serienlogik aufbauen, für die früher ein kleines Produktionsstudio nötig war – vorausgesetzt, der Workflow sitzt. Dieser Leitfaden beschreibt genau diesen Workflow: Entscheidungen, Reihenfolgen, Prüfsteine und die Fehler, die man einmal macht und danach vermeidet.
Vom Einzelclip zur Miniaturgeschichte: das neue Format
Der klassische Kurzclip lebte von einem einzigen visuellen Gag, einem schnellen Tipp oder einem überraschenden Schnitt. Das funktioniert weiterhin, aber die Konkurrenz um dieselben drei Sekunden ist enorm. Deshalb verschiebt sich das erfolgreiche Format in Richtung Miniaturgeschichte: 30 bis 90 Sekunden mit klarem Ausgangspunkt, einer Wendung und einem Abschluss.
Ein Beispiel: Ein Hersteller von Fahrradtaschen zeigt nicht das Produkt auf einem Tisch, sondern eine Person, die bei Regen ankommt und trockene Kleidung auspackt. Der Hook ist die nasse Jacke, die Wendung ist der trockene Inhalt, der Abschluss die Handlungsaufforderung. Drei Einstellungen, ein Gedanke, ein Produktnutzen.
Das Aufmerksamkeitsfenster realistisch planen
Die ersten zwei Sekunden entscheiden, ob ein Clip überhaupt bewertet wird. Kein Logo-Intro, keine Erklärung, kein Vorgeplänkel. Der Clip beginnt mitten in einer Situation – einer Bewegung, einer Frage, einem Konflikt. Danach folgt ein Rhythmus aus kleinen Informationshäppchen: alle zwei bis vier Sekunden ein neuer visueller Reiz oder ein neuer Gedanke. Für KI-Produktionen ist das besonders relevant, weil Generierungsfehler in ruhigen, langen Einstellungen am stärksten auffallen. Kurze, motivierte Schnitte kaschieren Ungenauigkeiten und passen zum mobilen Sehverhalten.
Serienlogik statt Einzelclip
Einzelne Clips verpuffen. Wer dieselbe Figur, dieselbe Farbwelt und dieselbe wiederkehrende Frage über mehrere Posts hinweg verwendet, baut Erwartung auf. Zuschauer erkennen den Clip, bevor sie den Namen lesen. Das erhöht die Verweildauer und macht jeden neuen Post günstiger, weil Assets, Bildprompts und Schnittmuster wiederverwendet werden.
Praktisch heißt Serienlogik: eine wiederkehrende Figur oder ein wiederkehrendes Produkt, ein festes Set an Kameraeinstellungen, eine begrenzte Farbpalette, ein wiedererkennbares Audio-Signet. Der Aufwand liegt einmalig am Anfang – danach produziert man Variationen statt Neuentwicklungen. Ein brauchbarer Maßstab: Wenn ein neuer Clip mehr als eine Stunde Konzeptionsarbeit braucht, obwohl die Serie schon steht, ist das Regelwerk zu locker.
Konsistenz als Kernkriterium
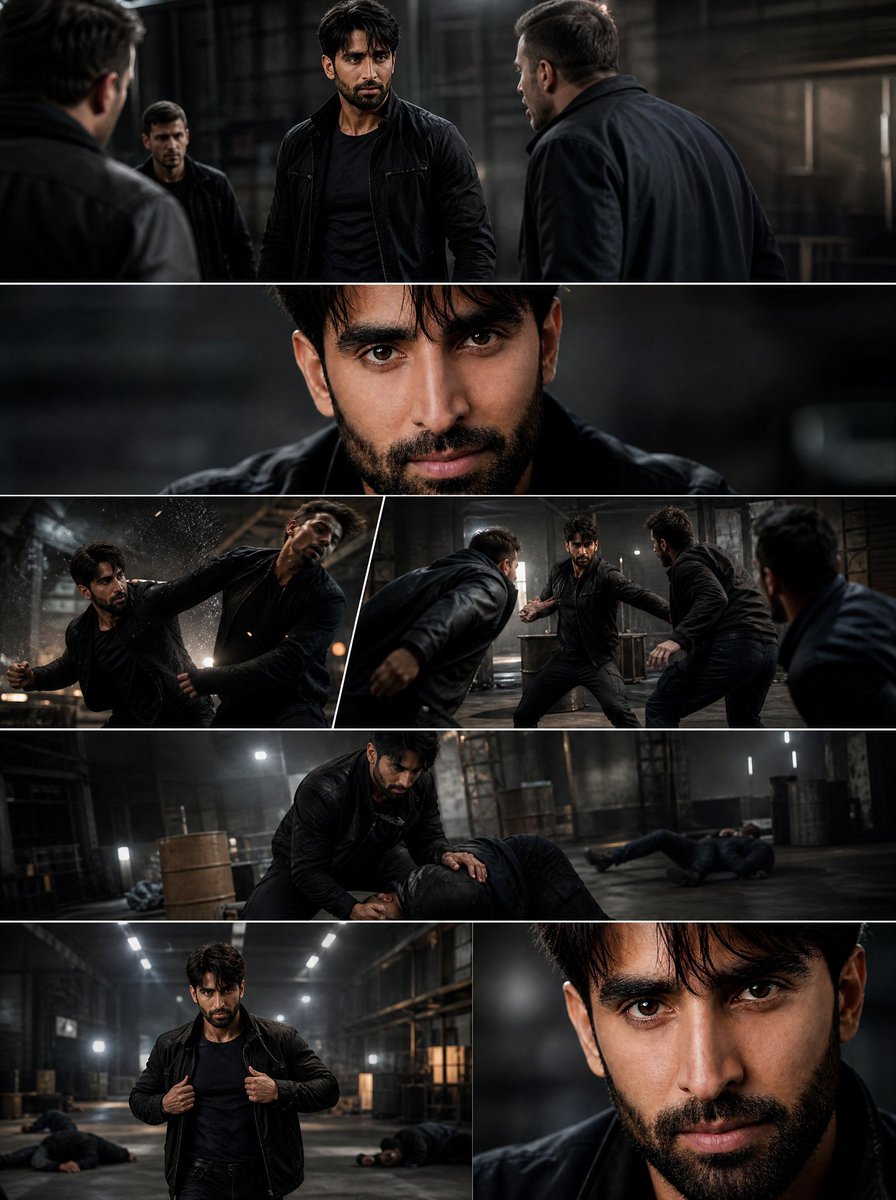
Nichts zerstört eine KI-gestützte Videoproduktion schneller als ein Gesicht, das zwischen zwei Einstellungen die Identität wechselt. Konsistenz ist deshalb kein Detail, sondern das Kriterium, an dem sich Workflows und Modelle messen lassen müssen. Wer hier schlampig arbeitet, produziert Clips, die einzeln gut aussehen und als Serie zerfallen.
Brand-Assets als Regelwerk definieren
Vor der ersten Generierung steht ein kleines Regelwerk: exakte Farbwerte, Typografie, Bildsprache, Kleidung der Figur, Lichtstimmung, bevorzugte Brennweiten. Dieses Regelwerk wird nicht nur dokumentiert, sondern materialisiert – als ein bis drei saubere Referenzbilder pro Motiv, die als visuelle Anker für jede Szene dienen. Ein nützlicher Test: Lässt sich aus dem Regelwerk allein beschreiben, was in einer neuen Szene erlaubt ist und was nicht? Wenn nicht, fehlen Regeln.
Drei Strategien für Figurenkonsistenz
Erstens das Referenzbild-Prinzip: Ein freigestelltes Portrait oder eine Ganzkörperaufnahme wird bei jeder Generierung mitgegeben. Zweitens das Trainings-Prinzip, bei dem ein kleines Set an Aufnahmen auf einen eigenen Stil oder ein eigenes Modell angepasst wird. Drittens das Schnitt-Prinzip, bei dem identitätskritische Einstellungen bewusst kurz gehalten und häufig geschnitten werden. In der Praxis kombiniert man meist alle drei: Referenzbilder als Basis, Training für die Hauptfigur, Schnitt als Sicherheitsnetz.
Ein typisches Warnsignal: Wenn zwischen zwei Clips derselben Serie die Frisur, die Jackenfarbe oder die Lichtrichtung wechselt, fehlt nicht das Modell, sondern das Regelwerk. Wer diese drei Merkmale in einer Tabelle festhält und vor jeder Generierung prüft, spart pro Serie mehrere Stunden Nacharbeit.
Produktkonsistenz über die Serie hinweg
Bei Produkten ist Konsistenz einfacher, weil Formen und Logos eindeutig sind. Hier lohnen Freisteller mit transparentem Hintergrund, und die Perspektive sollte über die Serie hinweg nur in kleinen Schritten wechseln. Große Perspektivsprünge wirken wie ein neues Produkt und verwirren die Wiedererkennung. Bewährt hat sich eine feste Reihenfolge der Ansichten: erst Totalansicht im Kontext, dann Detail, dann Anwendung – in jedem zweiten Clip dieselbe Abfolge.
Der Produktions-Workflow in vier Phasen
Ein wiederholbarer Ablauf schlägt jede Improvisation. Die Vier-Phasen-Struktur funktioniert für Einzelclips genauso wie für eine zehnteilige Serie.
Phase 1: Briefing, Skript und Dramaturgie
Am Anfang steht keine Prompt-Sammlung, sondern eine Aussage. Was soll der Zuschauer nach dem Clip wissen, fühlen oder tun? Daraus entsteht ein Skript von 60 bis 150 Wörtern, aufgeteilt in Hook, Kern und Pointe. Jede Zeile wird einer sichtbaren Handlung zugeordnet – Sätze ohne Bildidee fliegen raus. Wer mit Voice-over arbeitet, liest das Skript laut und stoppt die Zeit: gesprochene Sprache ist langsamer, als sie auf dem Papier wirkt. Erfahrungswert: 150 Wörter Sprechtext ergeben etwa 55 bis 65 Sekunden.
Phase 2: Storyboard und Referenzbilder
Aus dem Skript entstehen sechs bis zwölf Einstellungen. Für jede Einstellung werden drei Dinge festgehalten: Bildinhalt, Kamerabewegung und Lichtstimmung. Anschließend entstehen Referenzbilder – entweder neu generiert oder aus bestehendem Material ausgewählt. Diese Bilder sind der wichtigste Qualitätshebel im gesamten Prozess: Sie reduzieren Zufall und machen Ergebnisse reproduzierbar. Ein Storyboard in Textform mit drei Spalten reicht dafür völlig aus.
Phase 3: Generierung und Auswahl
Nun werden Szenen generiert, und zwar in Varianten. Statt eine Einstellung einmal zu rendern, entstehen drei bis fünf Versionen, aus denen die beste gewählt wird. Wichtig ist eine feste Prüfreihenfolge: erst Bildkomposition, dann Bewegung, dann Details wie Hände, Text oder Schmuck. Fehler in der Komposition lassen sich nicht wegschneiden, Detailfehler schon. Wer diese Reihenfolge ignoriert, verliebt sich regelmäßig in eine schöne Bewegung innerhalb einer unbrauchbaren Komposition.
Phase 4: Audio, Schnitt und Feinschliff
Bild ohne Ton ist im Kurzformat halb fertig. Musik, Voice-over und Geräusche werden getrennt aufgebaut und dann auf den Schnitt gelegt. Ein bewährter Trick: erst den Ton fertigstellen, dann die Bilder an den Ton anpassen. Schnitte sitzen dadurch präziser, und die Wahrnehmung von Bewegung wirkt natürlicher. Am Ende stehen Farbanpassung, Untertitel und Exporte in mehreren Seitenverhältnissen. Praktischer Hinweis: Der erste Schnittdurchlauf dauert oft nur 20 Minuten – die Politur danach zwei Stunden. Diese Verteilung sollte man einplanen, statt sie zu bekämpfen.
Audio zuerst denken: Ton, Stimme und Synchronisation
Sound ist im Kurzformat der halbe Erfolg und wird trotzdem stiefmütterlich behandelt. Drei Ebenen sollten getrennt geplant werden: Voice-over als Informationsträger, Musik als Tempo- und Emotionsgeber, Geräusche als Realitätsanker. Fehlt eine Ebene, wirkt der Clip flach; sind alle drei zu laut, wirkt er anstrengend.
Bei generierten Stimmen lohnt ein Sprechtest vor der Produktion: Hört sich die Stimme bei Zahlen, Markennamen und Fremdwörtern noch natürlich an? Ein häufiger Fehler ist ein Voice-over, das technisch sauber, aber emotional neutral klingt. Abhilfe: kürzere Sätze, bewusste Pausen und ein Sprechtempo, das etwa zehn Prozent unter dem Gefühlten liegt. Bei der Synchronisation zu generiertem Bildmaterial gilt: Mundbewegungen sind bei kurzen Einstellungen erstaunlich unkritisch, solange die Tonspur plausibel auf den Schnittpunkten liegt.
Ein zweiter, oft unterschätzter Hebel ist die Musiklänge. Wer Musik in 15-Sekunden-Blöcken denkt, kann daraus drei verschiedene Schnittvarianten bauen und testen, ob der Clip mit ruhigem oder treibendem Tempo besser funktioniert. Das kostet fast nichts und liefert belastbare Daten.
Modellwahl mit klaren Entscheidungskriterien
Jede Woche erscheint ein neues Videomodell, und jedes wird als Durchbruch angekündigt. Für die Praxis ist wichtiger, welches Modell zu welcher Aufgabe passt.
Wann schnelle Modelle ausreichen
Für Social-Clips mit hoher Frequenz, animierte Textkonzepte, abstrakte Hintergründe und Testvarianten sind schnelle, günstige Modelle die richtige Wahl. Sie liefern innerhalb von Minuten verwertbare Ergebnisse, die im Schnitt ohnehin gekürzt werden. Der entscheidende Vorteil ist nicht die Qualität, sondern die Zahl der Iterationen pro Stunde.
Wann hochwertiges Rendering sinnvoll ist
Sobald Gesichter im Close-up stehen, komplexe Kamerafahrten geplant sind oder eine Szene das Markenversprechen tragen muss, lohnt sich ein leistungsfähigeres Modell. Auch bei langen Einstellungen ohne Schnitt ist die teurere Variante meist günstiger als zehn misslungene Versuche mit einer schwächeren Engine. Faustregel: Je näher die Kamera an der Figur, desto höher die Qualitätsanforderung.
Vier Fragen für die Auswahl
Wie wichtig ist Identitätstreue in der Szene? Wie lang ist die Einstellung? Wie viele Varianten brauche ich? Wie schnell muss das Ergebnis vorliegen? Wer diese vier Fragen beantwortet, wählt selten das falsche Werkzeug – und wechselt nicht bei jedem neuen Release. Hilfreich ist außerdem, zwei Werkzeuge dauerhaft parallel zu betreiben: eines für Exploration, eines für die finale Ausgabe. So entsteht keine Abhängigkeit von einem Anbieter, und man merkt früh, wenn ein Modell für die eigenen Motive nicht mehr passt.
Personalisierung ohne Beliebigkeit
Personalisierung ist ein zweischneidiges Schwert. Varianten für unterschiedliche Zielgruppen erhöhen die Relevanz, können aber die Serienlogik zerstören, wenn jede Variante anders aussieht. Der Ausweg liegt in Modularität: Bildsprache, Figur, Musik und Schnittmuster bleiben konstant, variiert werden nur der erste Satz, die gezeigte Situation und die Handlungsaufforderung. So entstehen aus einem Grundgerüst fünf bis acht Ansprachen, ohne dass die Marke ihre visuelle Klammer verliert.
Zweiter Hebel ist die Sprache: Untertitel und Voice-over in mehreren Sprachen sind mit vertretbarem Aufwand machbar. Wichtig ist, dass die Bildsprache kulturell nicht überladen ist – neutrale Settings, klare Gesten und wenig erklärender Text funktionieren über Märkte hinweg am zuverlässigsten. Ein Warnsignal: Wenn zwei Varianten unterschiedlich geschnitten sind, testet man zwei Dinge gleichzeitig und lernt nichts.
Distribution, Tests und Metriken
Ein guter Clip auf nur einer Plattform lässt Reichweite liegen. Blindes Crossposting ist aber ebenfalls riskant, weil jede Plattform eigene Regeln für Länge, Untertitel und Hook hat. Ausgangspunkt ist vertikal in 9:16 mit fest eingebrannten Untertiteln und auf Mobilgeräten geprüftem Ton. Davon ausgehend wird pro Kanal angepasst: Wo ein junges Publikum unterwegs ist, funktioniert ein schnellerer Schnittrhythmus; auf beruflichen Plattformen eher ein ruhiger Einstieg mit klarer Aussage. Für längere Formate lohnt zusätzlich ein quadratischer oder 16:9-Schnitt.
Reichweite entsteht aus Iteration, nicht aus einem Glückstreffer. Deshalb sollte pro Serie nicht nur die View-Zahl gemessen werden, sondern die Haltequote nach drei Sekunden, die durchschnittliche Wiedergabedauer und die Interaktionsrate. Ein Clip mit weniger Views, aber deutlich besserer Haltequote ist die bessere Vorlage für die nächste Serie. Sinnvoll ist ein Testplan mit einer Variablen pro Durchlauf: nur der Hook wird getauscht, alles andere bleibt identisch. Nach vier bis sechs Durchläufen zeigt sich ein Muster, das sich bewusst wiederholen lässt. Haltequote und Wiedergabedauer sind dabei aussagekräftiger als Likes.
Die ersten 30 Tage: eine realistische Roadmap
Wer neu startet, sollte nicht mit einer Serie von zehn Clips beginnen, sondern mit einer kleinen Werkstattphase. Woche eins: Regelwerk schreiben, Referenzbilder für Figur und Produkt erstellen, Projektstruktur anlegen. Woche zwei: drei Testclips mit identischem Aufbau produzieren und nur den Hook variieren. Woche drei: die beste Variante in eine Serie überführen, Audio-Signet und Untertitelvorlage festlegen. Woche vier: Distribution planen, Exportvarianten anlegen, erste Kennzahlen auswerten.
Diese Reihenfolge hat einen einfachen Grund: Ohne Regelwerk produziert man Zufall, ohne Referenzbilder produziert man Ausschuss, und ohne Kennzahlen produziert man Meinungen. Wer die Werkstattphase überspringt, zahlt sie später in Form von Nacharbeit zurück.
Typische Fehler und wie man sie vermeidet
Die meisten Probleme in KI-Videoproduktionen sind Prozessfehler, keine Modellfehler. Zu viele Ideen in einem Clip: Wer drei Botschaften in 30 Sekunden packt, verliert alle drei. Keine Referenzbilder: Ohne visuelle Anker driftet jede Szene. Zu lange Einstellungen: Je länger eine generierte Szene läuft, desto mehr Details kippen – lieber zwei kurze als eine lange. Audio als Nachgedanke: Ton zuerst planen, nicht zuletzt drüberlegen. Kein Wiederverwendungssystem: Wer Assets, Prompts und Schnittmuster nicht ablegt, baut jede Serie von vorn. Keine Definition von fertig: Ohne Abbruchkriterium wird endlos nachgeneriert; zwei Runden Nacharbeit pro Szene sind ein guter Standard.
Häufige Fragen aus der Praxis
Wie viele Clips pro Woche sind realistisch?
Ein eingespieltes Duo schafft mit KI-Unterstützung acht bis fünfzehn kurze Clips pro Woche inklusive Untertiteln und Exportvarianten. Entscheidend ist nicht die Zahl, sondern die Wiederverwendung: Wer Referenzen, Sounds und Schnittvorlagen einmal sauber aufsetzt, produziert die zweite Serie in der Hälfte der Zeit.
Brauche ich ein eigens trainiertes Modell?
Nur wenn eine Figur über viele Szenen exakt gleich aussehen muss und Referenzbilder allein nicht ausreichen. Für die meisten Marken genügt ein sauberes Set aus Referenzbildern, festen Kamerawinkeln und begrenzter Farbpalette.
Wie vermeide ich, dass Videos künstlich wirken?
Künstlich wirken vor allem unnatürlich glatte Haut, schwebende Bewegungen und perfekte Symmetrie. Gegenmittel: kontrollierte Unschärfe im Hintergrund, leichte Handkamera-Simulation, realistische Lichtrichtungen und Schnitte, die Bewegung übertreiben statt sie zu erklären.
Wie viel Zeit sollte ich pro Clip einplanen?
Für einen 30-Sekunden-Clip mit generiertem Bildmaterial, Voice-over und Schnitt sind zwei bis vier Stunden realistisch, sobald die Assets stehen. In der Startphase dauert es länger, weil Referenzen, Projektstruktur und Stilregeln erst entstehen.
Was mache ich, wenn eine Szene nicht funktioniert?
Erst das Problem benennen: Komposition, Bewegung oder Detail? Bei der Komposition neu generieren, bei der Bewegung die Kamerafahrt vereinfachen, bei Details auf eine andere Einstellung wechseln. Wer ohne Diagnose sofort neu rendert, verbrennt Zeit.
Wer heute eine eigene visuelle Bibliothek aufbaut – Figuren, Produkte, Lichtstimmungen, Sounds – legt damit die Grundlage für alles Weitere. Werkzeuge ändern sich, Assets und Erzählregeln bleiben. Genau dort entsteht aus einem Kurzclip ein wiedererkennbarer Bestandteil einer Marke und aus Zufallstreffern eine Serie, die verlässlich funktioniert.
